
一个人能认出潦草的数字,却很难把辨认过程写成一套没有遗漏的规则。一条蛋白质序列可以被逐字记录,它在空间中怎样折叠,却曾让研究者耗费多年寻找答案。两类困难分属不同的仪器、学科和尺度,背后却是同一种计算愿望:从已经观察到的事物中学出规律,把规律用在尚未见过的对象上。
深度学习让这个愿望有了可反复使用的工程方法。多层网络逐层改变数据的表示,训练把预测误差传回这些变换,使中间表示也随任务调整。这种训练方式让网络从样本中学习笔画、语义关系或空间相互作用。设计系统的人负责选择观测、组织输入、设定学习目标,并决定怎样评价结果。
学到的表示还可以迁移到其他任务,减少为新任务重新开发系统的工作。随着表示能够处理的对象增多,深度学习也从识别数字逐步走向语言、图像和分子结构。
这条道路跨过了八十多年。早期神经网络提供了形式模型和学习思想;今天的深度学习还依赖大规模数据、可训练的多层结构与计算基础设施。符号推理、搜索、统计建模和数值模拟也一直参与其中。例如,围棋程序用网络指导搜索,科学模型则借助实验数据学习预测。
本章史料核验截止于 2026 年 10 月 15 日(Asia/Shanghai);年代指下文注明的论文发表、公开报告或实际事件时间。
早期神经网络
1943 年,Warren McCulloch 与 Walter Pitts 用形式神经元讨论神经活动与逻辑计算的关系。阈值、连接和离散状态,把一部分关于神经系统的问题变成可以推演的数学对象。这项工作关注网络能表达哪些逻辑关系;要让网络从样本中学习,还需要找到调整连接的方法。原论文:A Logical Calculus of the Ideas Immanent in Nervous Activity。
到了 1950 年代,Frank Rosenblatt 把重点移到经验如何改变连接。1958 年的感知机论文把知觉、记忆与统计学习放进同一框架;后来建造的 Mark I Perceptron 则把学习落实为一台可以接收视觉输入、调整连接的装置。这台机器今天收藏在史密森尼美国国家历史博物馆。它所尝试的事情很具体:给机器呈现样例,让内部状态的改变影响下一次判断。Rosenblatt(1958);Mark I 馆藏记录。
感知机通过输入的加权和与阈值比较来分类,因此单层模型的分类边界是一条直线或更高维空间中的超平面。若直接输入两个二进制数,异或要求把 判为一类,把 判为另一类,平面上的一条直线无法将两类分开。增加非线性中间层可以表达这个关系,困难随即变成:训练只告诉网络最后答错了,隐藏层里究竟哪些连接应该改?把最终误差分配给各层连接,就是多层网络遇到的信用分配问题。
“模型表达不了”与“模型能够表达、却难以训练”是两种困难:前者需要让模型能够表示更多种函数,例如增加非线性中间层;后者需要改进学习算法、初始化并提供足够的计算。反向传播首先回应了后一种困难。
把误差送回隐藏层
要知道隐藏层的连接应该怎样改,可以计算损失对每个权重的导数。反向传播的发展围绕这项计算逐步展开。链式法则是微积分工具;把它组织成沿计算过程反向累积导数的算法,是自动微分的发展;再用这些导数调整多层网络的权重,才进入神经网络学习。
Seppo Linnainmaa 在 1970 年的学位工作及 1976 年论文中研究计算过程的误差展开,形成了反向模式自动微分的早期系统表述。Paul Werbos 的 1974 年博士论文则研究模型拟合与预测的新方法,讨论它们在社会和生物科学中的应用。这些工作为后来多层网络的训练提供了求导和模型拟合方面的基础。Linnainmaa(1976)及其论文所列 1970 年学位文献;Werbos 学位论文馆藏记录。
1986 年,David Rumelhart、Geoffrey Hinton 和 Ronald Williams 发表 Learning representations by back-propagating errors,展示隐藏单元怎样在误差驱动下形成有用的内部表示。这篇论文让多层网络的学习方法广为传播。原论文作者存档。
反向传播解决的是高效计算梯度:一次前向计算保存必要的中间量,再从损失向输入方向传递导数,各层得到自己参数的梯度。各层沿着减小损失的方向更新权重,最终任务便能反过来塑造早期特征。
深层网络的训练还受到梯度衰减、初始化和数据量的影响。反向传播给出了梯度的计算方法,接下来的问题是怎样设计网络,让这些梯度能够有效地推动学习。
卷积网络把学习方法与图像结构结合了起来。局部连接让一个单元只处理附近像素,参数共享让同一种特征检测器在多个位置复用,逐层组合则扩大可见范围。LeCun、Bottou、Bengio 与 Haffner 的 1998 年文档识别论文系统呈现了 LeNet-5 和包含识别模块的文档处理系统。局部连接与参数共享减少了需要学习的参数,使网络能够直接从手写字符样本中学习识别特征。Gradient-Based Learning Applied to Document Recognition。
识字说明这条路线能够工作,普通照片却难得多:物体会旋转、被遮挡,背景会干扰,同一类别的外观差异也可能很大。模型需要更多样的例子,也需要足以处理这些例子的容量和训练时间。
数据与计算
2006 年,Hinton、Osindero 和 Teh 提出逐层学习深度信念网络的方法,先为较深的模型建立可用的参数,再继续调整。它回应了当时深层网络难以训练的问题,也表明无标签数据可以参与表示学习。后来大规模监督训练采用了其他训练流程,“先学习表示,再服务于后续任务”的思想则继续发展。A Fast Learning Algorithm for Deep Belief Nets。
当数据和计算资源足以支持大规模监督训练时,直接训练图像分类网络成为可行的选择。2012 年的 AlexNet 汇集了几项条件:ImageNet 竞赛提供约 120 万张训练图像和 1,000 个类别;GPU 承担大规模卷积;ReLU 改善训练速度;数据增强和 dropout 缓解过拟合。
这些计算需要相应的硬件与运行时间。Krizhevsky、Sutskever 与 Hinton 报告,论文所述网络在两张各有 3 GB 显存的 GTX 580 上训练约五至六天。算法的进展在这里有了明确的物理条件:显存决定网络怎样拆分,运行时间决定一次实验要等待多久。AlexNet 原论文 §2–5。
ILSVRC-2012 分类竞赛用 top-5 错误率衡量结果:若正确类别没有出现在模型概率最高的五个候选中,就记为一次错误。团队最终集成系统的 top-5 测试错误率为 15.3%,第二名为 26.2%。差距是 10.9 个百分点,相对错误率下降约 41.6%。论文表 2 中的单 CNN 验证错误率则是 18.2%;最终 15.3% 来自七个网络的集成,其中包含额外预训练的模型。原论文 §6、表 2。
这次结果改变了视觉系统的建设重心。过去常由人设计特征,再训练分类器;端到端训练让特征本身也接受最终识别目标的检验。已有数据的价值因此增加:同一批图像既训练分类决策,也塑造前面的表示。训练这样的表示,需要计算硬件、标注数据和优化技巧共同支持。
继续加深网络又暴露了新的问题。2015 年公开的 ResNet 论文观察到,普通网络变深后,连训练误差也可能变差。残差连接让网络学习相对于输入的修正,使信息和梯度拥有更直接的通路。论文在 ImageNet 上评估到 152 层,展示了这种结构怎样让深度变得可用。Deep Residual Learning for Image Recognition。这一变化后来也进入语言模型:今天常见的现代解码器 block,仍然依靠残差通路组织大量层次的变换。
从辨认对象到生成与行动
分类回答“这是什么”,生成学习还要描述“怎样产生一个可能的样本”。2013 年公开的 VAE 用潜变量表示样本背后的变化因素,并用可优化的变分目标学习潜变量与观测之间的关系。2014 年的 GAN 让生成器产生样本、判别器辨别样本来源,两者共同训练。2020 年的 DDPM 则学习逐步去除噪声,把去噪过程发展为高质量图像生成方法。它们使用不同的训练目标与采样过程,使网络能够生成具有训练数据统计结构的新结果。VAE、GAN、DDPM。
生成能力改变了视觉计算的输出:模型可以提出一张候选图、补全缺失区域,或者按照条件修改内容。2021 年公开、发表于 CVPR 2022 的潜空间扩散工作,把去噪过程移到压缩表示中,并支持文本等条件控制,降低了在高分辨率像素空间直接建模的计算负担。文本到图像由此获得了一条可扩展的技术路线。High-Resolution Image Synthesis with Latent Diffusion Models。创作者可以用描述提出视觉草案,再按构图意图和叙事目的挑选、修改和组合。关于采样与条件控制的机制,见生成模型。
从生成一个样本转向选择一个行动,学习还要处理延迟到来的反馈。棋手落下一子时,往往无法立即知道它对最终输赢的贡献。2016 年 AlphaGo 的论文把策略网络、价值网络与蒙特卡洛树搜索结合:网络建议值得探索的落子并估计局面,搜索再展开可能的后续对局。系统同时使用人类棋谱学习和自我对弈强化学习。学习到的判断缩小搜索范围,搜索又帮助做出当前决定。Silver 等,2016 年论文。
当年 3 月,AlphaGo 在首尔以 4 比 1 战胜李世石。1 月论文记录的是更早对樊麾的比赛,首尔对局属于下一阶段。DeepMind 比赛记录。2017 年的 AlphaGo Zero 进一步在给定围棋规则的环境中从自我对弈学习,不使用人类棋谱作为训练示范。Mastering the Game of Go without Human Knowledge。
自我对弈能够提供大量训练经验,与围棋环境的特点有关:规则确定,动作可枚举,胜负能结算,大量试错不伤害现实中的人。将这种学习与搜索的结合推广到现实任务,就会遇到新的反馈问题:当环境只能部分观察、行动会付出真实代价、好坏要很久才能判断时,怎样获得同样有效的反馈?
语言成为通用接口
语言任务需要利用上下文作出判断。例如翻译一个词时,模型需要参考句子中其他位置的信息。2017 年,Vaswani 等人从机器翻译出发提出 Transformer。自注意力允许序列位置直接交换信息,并使训练中的许多计算能够并行执行。它改变了序列建模的组织方式,为继续扩大模型与训练数据提供了合适结构。Attention Is All You Need。
序列结构能够扩展后,同一个模型可以先从大量文本中学习表示,再用于不同任务。BERT 在 2018 年通过遮蔽词预测等目标学习双向表示,再针对下游任务微调。BERT。
使用预训练模型的另一种方式,是直接在输入中说明任务。GPT-3 在 2020 年展示,把任务说明和少量示例放进上下文,也能让同一个语言模型完成多种任务;示例只在推断时读入,权重并不更新。Language Models Are Few-Shot Learners。
预训练能够扩大的一个原因是文本自身能提供大量训练目标,从而减少每项任务对大规模人工标签的需求。在此基础上,指令示范与人类偏好反馈又把“续写什么文字”的模型行为推向“怎样响应一个请求”。InstructGPT,2022。
语言能描述任务,也能描述图像和程序。2021 年的 CLIP 用成对图文学习共享的表示空间,使文字描述可以参与视觉识别;同年的 Codex 研究用代码训练语言模型,并通过执行测试评价生成程序。代码输出由此获得了直接的外部检查:程序能否运行,是否通过指定用例。CLIP;Evaluating Large Language Models Trained on Code。
当程序和工具能够返回执行结果时,自然语言请求就可以连接到检索、代码和可执行操作。ReAct在 2022 年公开的研究中,把语言推理步骤与环境动作交错组织,让工具返回的观察进入下一步决策。
2023 年的 GPT-4 技术报告描述了接收图像与文本、输出文本的多模态模型;2024 年的 Gemini 1.5 报告进一步研究长文档、音频和视频的长上下文处理。多模态学习让任务输入由一句提示扩展为一份资料、一段录音或一段连续影像,模型需要在不同形式的证据之间建立联系。GPT-4 Technical Report;Gemini 1.5。评价这类任务时,可以沿处理过程检查模型是否找到相关内容、是否理解内容在全文中的作用,以及是否据此作出正确决定。
这些变化已经能在具体工作实验中测量。Noy 与 Zhang 于 2023 年发表的随机实验招募了 453 名受过大学教育的专业人士,研究中等难度的职业写作任务。获得 ChatGPT 辅助的实验条件下,平均完成时间下降 40%,输出质量评分提高 18%。这些数字衡量的是实验设定的短篇写作任务,质量由研究采用的评分方式评定。原论文;MIT 对实验设计的说明。
对知识工作的影响由此变得具体:整理材料和提出初稿可以更快,人的时间可以转向核对事实、处理例外和作出决定。对于缺少专业训练的人,自然语言接口也降低了调用程序与生成工具的门槛。衡量完整工作流程的收益时,需要把节省的起草时间与审阅、纠错以及后续处理错误的时间一起计算。
科学预测
科学预测把模型输出与实验观测直接联系起来:模型先预测一个结构或信号,研究者再与实验结果比较。2020 年 CASP14 采用尚未公开的实验结构考核蛋白质结构预测。
盲测的结果可以用结构偏差衡量。2021 年发表的 AlphaFold 2 论文报告,在其分析的 87 个蛋白质结构域上,覆盖 95% 残基的 Cα 主链均方根偏差中位数为 0.96 Å,下一最佳方法为 2.8 Å。这一指标衡量预测结构与实验结构对齐后的偏差,数值越小,结构越接近;。Jumper 等,图 1a。
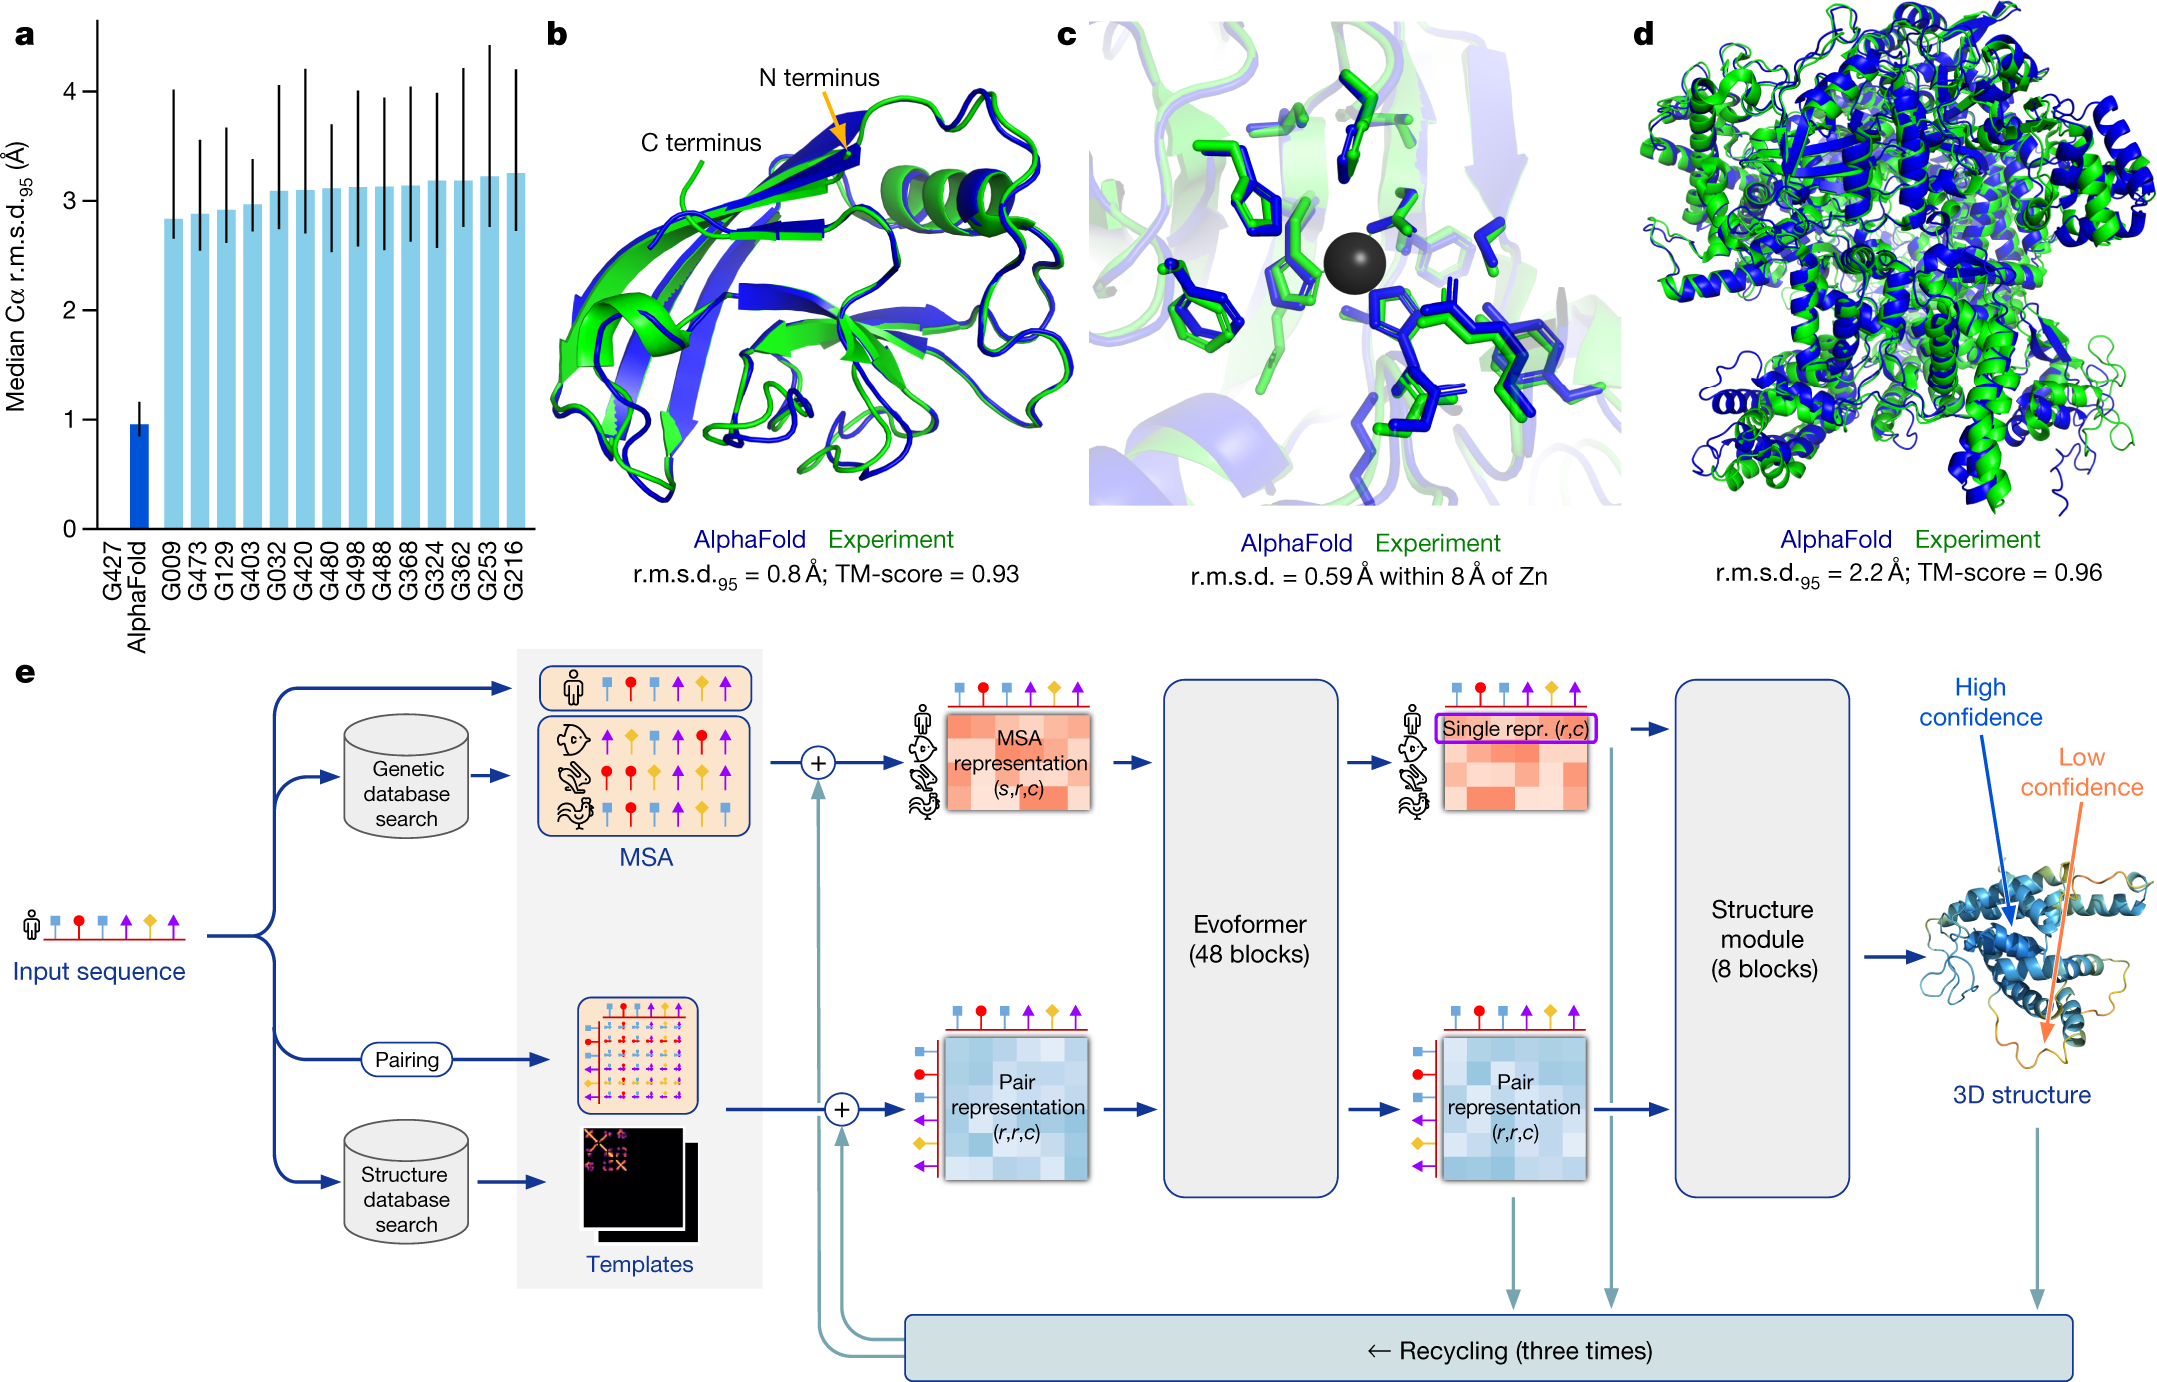
图 1:Jumper 等(2021)原论文图 1,PDF 第 2 页、期刊第 584 页,原图未修改,依据 CC BY 4.0 使用。左上 a 比较 CASP14 结构域误差;b 至 d 以蓝色表示预测、绿色表示实验结构,其中 d 是赛后预测示例;下方 e 显示多序列比对、成对表示与结构模块怎样连接。结合流程图与结构叠合图,可以看到输入信息如何变成结构预测,以及预测如何与实验结构比较。
AlphaFold 2 从序列、进化相关信息和已有结构中提取约束,产生可供检查的三维模型。研究者因此能够先定位一个可能的结合区域,选择要测试的突变,或把预测结构作为解释实验数据的起点。2022 年 7 月,EMBL-EBI 与 DeepMind 将 AlphaFold 数据库扩展到超过两亿个预测结构,开放查询改变了结构信息的可获得性。当时的数据库发布记录。研究者可以结合预测置信度和已有实验结构,选择适合进一步研究的候选。
预测单个蛋白质的结构之后,下一个问题是它怎样与其他分子结合。2024 年的 AlphaFold 3 将预测对象扩展到分子复合物。细胞中的蛋白质与 DNA、RNA、小分子及离子共同作用;模型开始联合预测包含这些分子的复合物结构。扩散方法在这里用于生成原子坐标,将生成模型接入了分子相互作用研究。Abramson 等,2024。
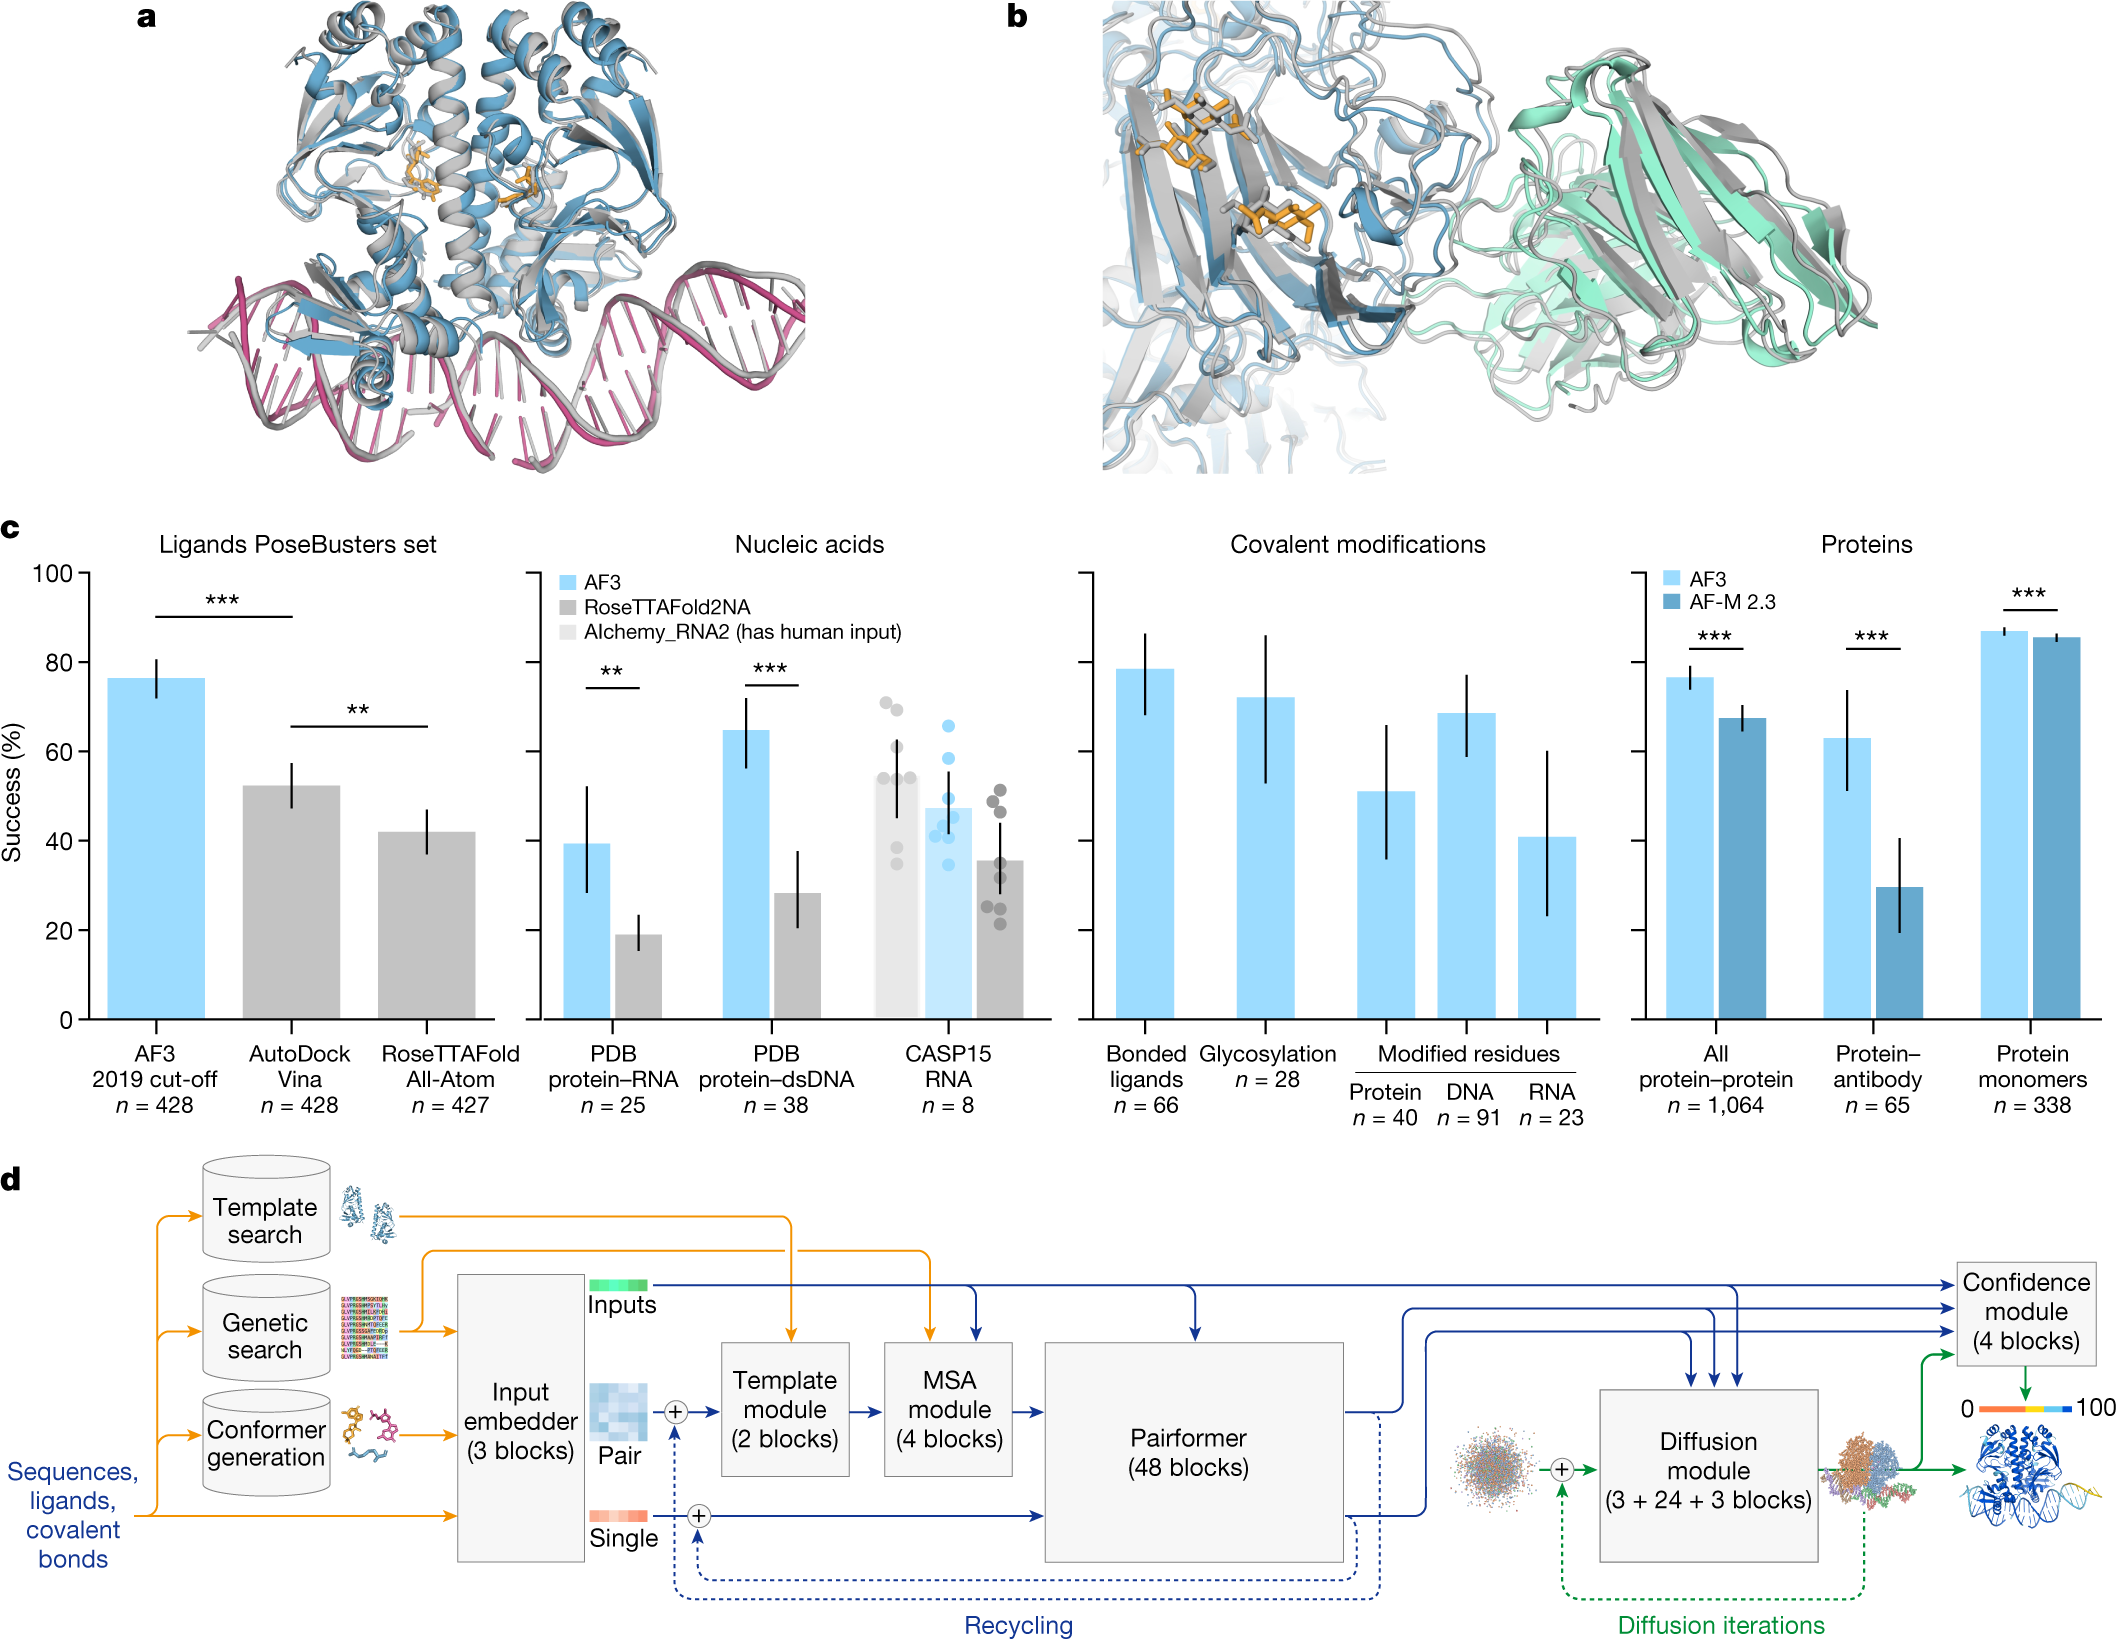
图 2:Abramson 等(2024)原论文图 1,PDF 第 2 页、期刊第 494 页,原图未修改,依据 CC BY 4.0 使用。a、b 展示复合物,c 分别评价配体、核酸、共价修饰和蛋白质相关任务,d 显示扩散模块生成坐标。c 的各任务采用不同判据、样本数和采样设置,因此应在各任务自身的评价标准下比较模型表现。
2026 年 1 月发表的 AlphaGenome 把观察尺度移向 DNA 调控。它接收约百万碱基长度的序列,预测基因表达、染色质可及性、剪接等实验信号;比较参考序列与变异序列的预测,可以估计变异造成的分子影响。论文使用人和小鼠数据训练,并在未用于训练的基因组区域及变异效应任务上评价。Avsec 等,Advancing Regulatory Variant Effect Prediction with AlphaGenome。这样一来,研究者能先对大量候选变异排序,再决定把有限的实验资源放在哪里。若要进一步研究疾病结局,还需要把分子信号与细胞状态、环境等因素联系起来。
从结构预测走向相互作用,再走向序列变化的功能后果,深度学习逐渐参与科学问题的提出与筛选。这些预测依赖长期积累的测序、结构测定和功能实验数据。新模型把这些积累重新组织,使过去只能逐个研究的问题能够先接受大规模计算筛选;实验再淘汰错误候选,并把新的观测带回下一轮研究。
推理计算
除了扩大训练规模,语言模型还可以在回答一道题时投入更多计算。它可以尝试不同解法、运行程序、检查约束,再选择答案。训练时投入的计算塑造模型,推断时投入的计算则服务于眼前这一个问题。围棋搜索也把额外计算用于当前局面的决策;语言模型则把尝试和检查解法的过程用于更开放的任务。
要让模型学会检查和调整解法,训练过程需要对解题结果提供反馈。2025 年的 DeepSeek-R1 工作研究了这种训练方式。R1-Zero 从已经预训练的基座出发,用强化学习和规则奖励训练可验证的推理任务;完整的 R1 还加入冷启动数据、监督微调等阶段。论文观察到更长的解题过程,以及检查和调整解法的行为。这些观察把推理过程与训练反馈联系起来:奖励怎样设置,会影响模型采用怎样的解题行为。2025 年 1 月技术报告;同年 9 月正式论文。
反馈的设计决定了模型向什么目标优化。数学答案、程序测试和形式验证能提供较明确的反馈,开放式研究与现实行动的评价则通常更昂贵。程序测试需要覆盖边界条件,解释的评价需要检查结论是否正确,奖励才能推动模型解决实际任务。比较不同推理方法时,可以固定总计算预算,检查新题上的成功率、失败分布和验证成本。
尚未完成的扩展
前面的进展把研究问题从单次预测推进到多步工作。多模态模型能够接收更完整的情境,语言模型可以调用工具,科学模型能够产生实验候选;下一阶段是否有实质进步,取决于这些能力能否在陌生条件下共同工作。
长程任务需要通过反馈发现并修复中途的错误。如果系统能在工具失败、资料过时或环境改变后识别问题并重新规划,它就有机会继续完成被打断的工作。可检验的实验应把任务放在训练之后产生的新环境中,保留失败与恢复记录,并统计人在中途接管的次数。这些记录能够说明系统在哪些环节需要人帮助,以及它能独立恢复到哪一步。对于机器人,碰撞、时间和能量的代价也必须进入评价;视频预测是否合理,最终要接受真实行动结果的检验。
科学模型可以用实验反馈改进下一轮候选选择。如果结构、功能与实验反馈能够连接成稳定循环,模型可能缩短从提出假设到淘汰假设的时间。比较方法是提前登记候选选择规则,用相同预算进行盲测,报告验证成功率、失败候选和重复实验结果。AlphaFold 3 与 AlphaGenome 已经扩大了可计算的对象范围,未来能否提高发现效率,要看预测在实验室里省下了多少试错。
计算效率可以按每个成功完成的任务来衡量。更长的上下文、更多采样和更长的推理都要消耗资源。若高效序列计算、小模型、蒸馏或有选择的工具调用能在相同可靠性下减少成本,更多人才能实际使用这些能力。应同时报告每个成功任务的延迟、能耗与费用,并观察语言、领域和设备变化后的表现。
工具对人的影响需要同时观察短期工作和长期学习。写作辅助已经能在短时任务中测出收益;要考察长期学习,可以检查:离开工具后还能否独立解释和解决问题,错误建议是否会被识别,使用者能否知道结论来自哪里。生产工具还涉及数据贡献者和创作者的权利、收益分配以及谁能承担纠错成本。技术的可用性与社会的受益范围,需要分别建设和评价。
从早期神经元模型到今天的分子结构预测,研究者逐步把经验转化为可以训练和复用的计算。数据整理、仪器制造、软件开发和实验检验共同支持了这些进展。今后的算法与装置还将影响谁能使用这些方法:能否让一份材料跨越语言,让一个设想变成可运行的程序,或让一个关于生命的猜想获得开展实验的机会,都与使用成本、知识传播和人的判断能力有关。
主要原始来源
| 年代 | 原始资料 | 本章使用位置 |
|---|---|---|
| 1943、1958 | McCulloch 与 Pitts;Rosenblatt | 形式神经元与早期学习模型 |
| 1974–1986 | Werbos 学位记录;Linnainmaa;Rumelhart、Hinton 与 Williams | 求导、学习应用与传播的不同历史层次 |
| 1998、2006 | LeCun 等;Hinton、Osindero 与 Teh | 文档识别、深层模型的训练 |
| 2012、2015 | AlexNet;ResNet | 视觉识别条件、集成结果与深度优化 |
| 2013–2022 | VAE、GAN、DDPM、潜空间扩散 | 生成机制与条件创作 |
| 2016–2017 | AlphaGo;AlphaGo Zero | 学习与搜索、自我对弈 |
| 2017–2022 | Transformer、BERT、GPT-3、InstructGPT | 预训练、上下文使用与偏好反馈 |
| 2021–2024 | CLIP、Codex、ReAct、GPT-4、Gemini 1.5 | 语言、代码、多模态与工具 |
| 2021、2024、2026 | AlphaFold 2、AlphaFold 3、AlphaGenome | 结构、相互作用与变异效应预测;图 1、图 2 |
| 2023、2025 | Noy 与 Zhang;DeepSeek-R1 | 有条件的工作收益、可验证反馈与推理 |