
监督微调用示范回答训练模型。模型随后可能给出两个语句通顺的回答:一个遵守题目要求,一个遗漏了条件。直接让标注者比较两者,能提供示范文本之外的学习信号。
镜子前的两张图
老韩在菜市场后面开理发店二十年。他最得意的是一款两边推短、顶上留长的发型,自己觉得利落,见人就推荐。剪完客人都说好,回头的却不多。
儿子给他装了一个平板。客人坐下说一句要什么,老韩就在平板上调出两张图,都是照着这句话想出来的剪法,请客人指一张。那句话、指了哪张、没指哪张,平板都存下来。
客人不用打分,只说这张比那张好,这比打分容易得多。说“下周去面试”的,两张图里一张是老韩的招牌,一张是短而平的寸头,十个里有八个指寸头。说“下周当伴郎”的,招牌那款反倒常被指中。同一个客人,说的事不一样,指的也不一样。
半年后,老韩再听到“面试”,先想到的是寸头;听到“婚礼”,才把招牌那款拿出来。两张图照样一起给,只是常被指中的那一类,出现得越来越多。回头客也多了。
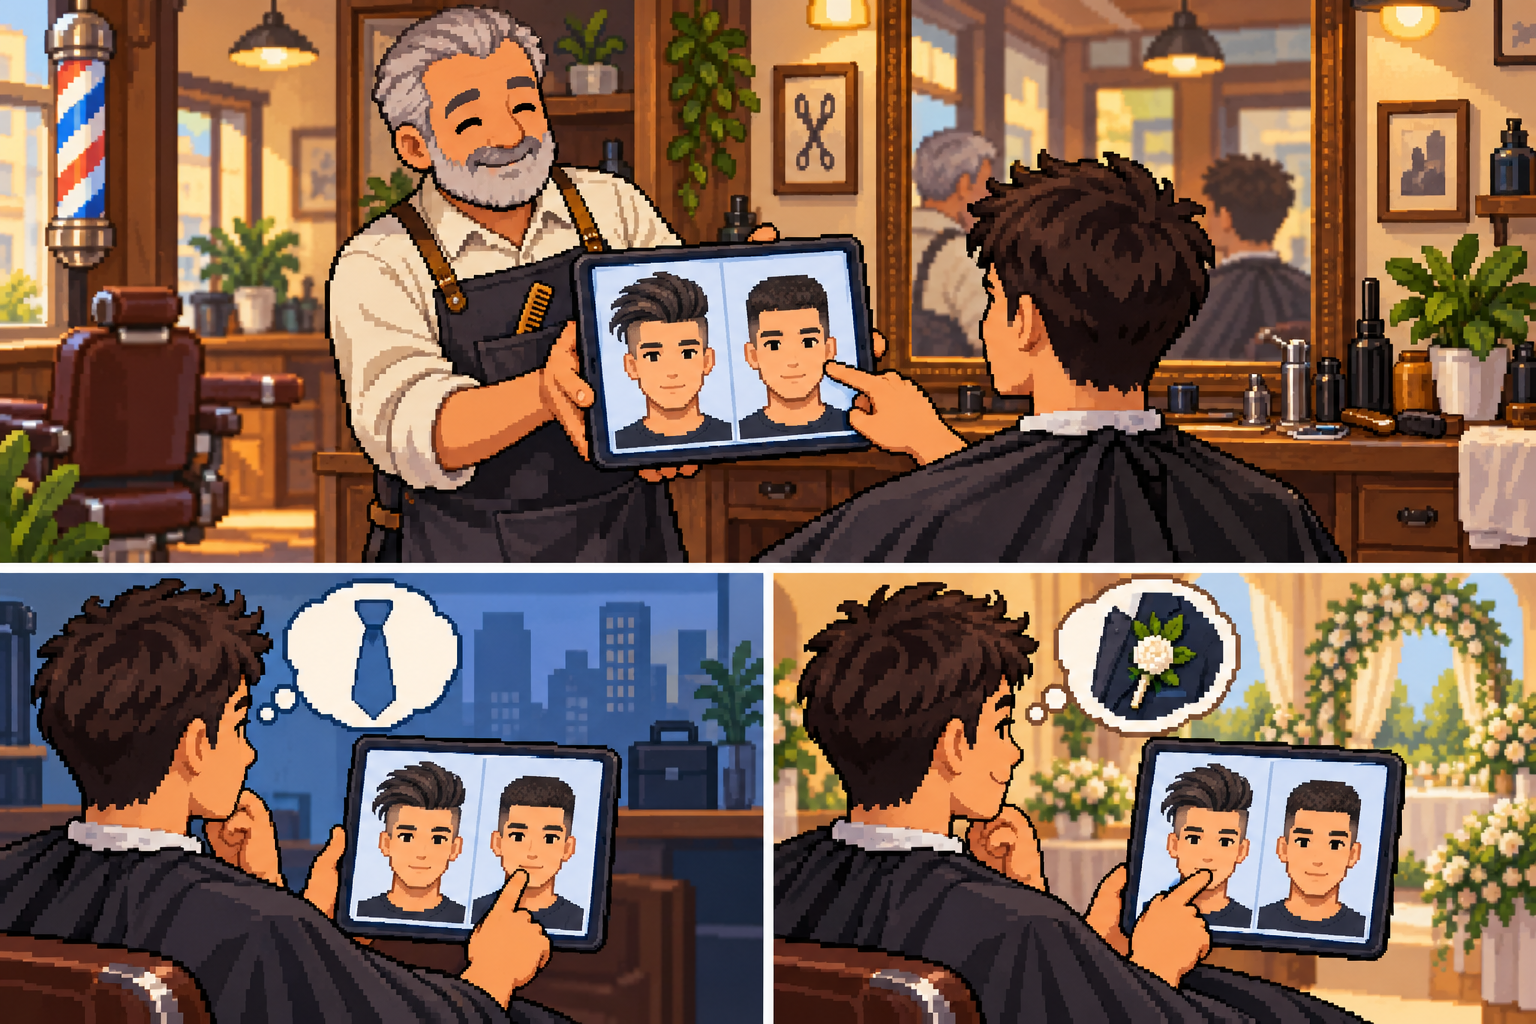
在同一个请求的两个回答里挑一个,记下请求、选中的和没选中的,这就是偏好数据。标签只说两个里哪个更合适,据此调整之后,更受偏好的回答更可能出现。
偏好数据
偏好学习把同一请求下的两份回答放在一起比较。理发店记录的请求、选中的图和未选中的图,对应语言模型训练中的提示与两份回答。一条成对偏好样本记为 : 是提示或任务, 是被选中的完整回答, 是未被选中的回答。下标 表示比较结果。标签只表示同一任务下的相对选择,两段回答的长度可以不同。
例如提示要求“只给出两条建议”,回答甲给两条可执行建议,回答乙给五条泛泛建议。标注规则可以同时要求遵循条数、内容相关和表述清楚。展示顺序可能左右选择,所以要随机交换两份回答的位置;标注者分歧或平局也要显式处理,硬把每对都定出胜负会把噪声带进训练。
要用这些比较结果训练语言模型,先要算出模型给每份完整回答的概率。对长度为 的回答 ,自回归策略 是参数为 的语言模型给这段回答的条件概率。定义序列对数概率
是已经给定的回答前缀,所有对数取自然对数。整段回答的概率是各位置条件概率的乘积,取对数后就变成上式的求和。求和范围包含回答 token 和约定的结束标记 EOS;提示 token 负责提供条件。后文要用整段回答的概率比,因此保留求和,按长度取均值会改变这一目标。
计算已知回答的概率时,可以把原回答作为输入,让每个位置根据真实前缀预测下一个 token,这称为教师强制。各位置的概率可以在一次前向传播中并行计算。
人类反馈强化学习
一个经典 RLHF(Reinforcement Learning from Human Feedback)流程先学习奖励,再用奖励更新策略。InstructGPT §3.1、§3.5给出了 SFT、奖励模型和 PPO 策略更新的路径。下面区分数据如何流动以及哪些参数改变:
示范 (x,y) ──监督训练──> SFT 策略
                            ├──复制并冻结──> 参考策略 π_ref
                            └──初始化─────> 可更新策略 π_θ
比较 (x,y_w,y_l) ──训练 φ──> 奖励模型 r_φ

提示 x ──当前 π_θ 采样──> 回答 y
        y ──冻结 r_φ 打分─────────┐
        y ──π_θ 与 π_ref 算概率比─┤──构造反馈──更新 θ
                                 └──价值基线可另行训练
奖励模型 把完整提示与回答转换成一个分数,供策略更新时使用。 是奖励模型的可训练参数;训练要让被偏好的回答获得更高分。
一种实现是从每条有效序列的最后一个位置取隐藏向量,再投影成标量。设 是批次大小, 是补齐后的总序列长度, 是隐藏宽度,模型的隐藏表示形状为 。取出每条序列的 维向量并投影后,便得到形状为 的分数。
为了让分数能够拟合“选中哪份回答”的标签,Bradley–Terry 偏好模型用 sigmoid 函数把两个回答的奖励差转换成胜率:
符号 表示被偏好。奖励差为零时胜率为 ,差为 时胜率为 。给定比较数据集 ,最小化负对数似然
实现时,先为每对回答计算负对数似然,再对批次内的样本取均值。损失只使用奖励差,因此给同一提示的所有回答分数加同一个常数,偏好概率保持不变;训练确定的是相对分数。
有了奖励模型,就可以让当前策略采样回答,再根据得分更新策略 。这一阶段冻结奖励模型,使打分标准保持一致;同时用 KL 惩罚控制策略偏离参考模型的幅度。常用目标是
其中 是冻结的参考策略, 控制偏离参考分布的代价。序列分布上的 KL 定义为
实际采样时,把各 token 的对数概率比相加,就得到一条序列对 KL 的样本估计。单条估计可以为负,对策略采样分布取期望后,KL 非负。
PPO 等方法把采样回答及其反馈用于策略更新。更新所用的优势估计衡量反馈比基线高出多少,其中价值网络估计未来反馈来提供基线,奖励模型负责给完整回答打分。策略梯度解释了这种反馈怎样变成参数更新。
奖励模型的评分标准会影响策略学到的行为:如果它把某种措辞误判为高质量,策略就会更频繁地产生这种措辞。评估时应使用奖励模型未拟合过的提示,并用独立的人类判断或任务指标衡量回答质量。
直接偏好优化
RLHF 要训练奖励模型,还要反复采样更新策略。若已有固定的成对偏好数据,可以把奖励表示成策略与参考策略的概率比,直接得到一个可微的分类损失。这是 DPO(Direct Preference Optimization)的构造。原论文 §4、附录 A.1–A.2从同一个 KL 正则目标导出它。
从奖励到策略
先固定一个提示 和一个标量奖励函数 ,暂时把完整回答概率 当作可自由优化的变量。考虑参考策略有正概率的回答集合,要求归一化常数有限。对约束 引入拉格朗日乘子 :
对某个回答的概率求导并令其为零:
将导数等于零的条件整理成概率比,再用总概率为 1 的约束归一化,得到最优策略
是只依赖提示的归一化常数。最优策略用奖励的指数重新分配参考策略的概率:奖励越高,获得的权重越大。对固定奖励, 越大,这种重加权越弱。
为了把奖励模型换成策略本身,将上式取对数、移项,把奖励写成概率比:
同一提示下的两个回答共享 ,所以奖励相减时, 消去,剩下的量都能由策略和参考策略的概率计算。用可训练策略 代替 ,就可以直接拟合 Bradley–Terry 偏好概率。定义经参考策略校正的对数概率差
其中第一项衡量当前策略有多偏向 ,第二项扣除参考策略已有的偏向。将奖励差写成 并代入偏好损失,得到
DPO 训练冻结参考模型,只更新 。实现时,对每对已收集的回答计算上述损失,再对批次内的回答对取均值;奖励网络和 的计算已由概率比替代。
这段推导先在所有合法分布中求 KL 正则目标的闭式解,再由神经网络在有限偏好数据上拟合 Bradley–Terry 概率。网络的表达能力和数据量决定了拟合效果。CS336 第 15 讲第 56–58 页也区分了这两步。通常的离线 DPO 使用固定的回答对;在线强化学习则在训练中不断从当前策略采样新的回答。
概率差与梯度
设一条样本的序列对数概率如下,均为回答 token 的总和:
| 模型 | 被偏好回答 | 另一回答 | 两者之差 |
|---|---|---|---|
| 当前策略 | |||
| 参考策略 |
当前策略的对数概率差为 2,扣除参考策略的 0.5 后,得到 。取 ,送入 sigmoid 的分类 logit 为 ,预测偏好概率为 ,单条样本的损失为
损失对校正后的对数概率差的导数,决定了训练如何调整这对回答的排序:
导数为负,因此梯度下降会推动被偏好回答相对于另一回答的对数概率差增大。共享网络的一次更新还会影响其他回答,单份回答的绝对概率由这些共同变化决定。若当前策略与参考策略相同,,损失为 ;若已经把偏好对排得很开,梯度的绝对值会减小。
序列掩码
实现 DPO 时,要从模型输出中取出每份回答的序列对数概率。设一个批次有 对回答,将被选中的回答放在前半批,对应的未选中回答放在后半批,便有 条序列。
是补齐后的序列长度, 是词表大小,模型 logits 形状为 。位置 的 logits 预测位置 的 token,故移位后形状为 。对词表维计算对数概率,再取出目标 token ID 对应的值,得到 。
回答掩码与“目标 token 所在位置”对齐:提示为 0,回答和 EOS 为 1,padding 为 0。第一个回答 token 的概率来自最后一个提示位置的 logits:这个位置的输入是提示,目标却是回答。attention mask 让模型忽略 padding,回答掩码决定哪些目标概率进入损失。
以下函数接收已经按序列位置对齐的 answer_mask,输入 ids 中 padding 也是合法词表 ID。它采用右侧补齐、每条保留至少一个提示 token 的约定:
import torch
import torch.nn.functional as F


def sequence_logprob(logits, ids, answer_mask):
    # logits [2B,S,V]; ids, answer_mask [2B,S]
    logp = logits[:, :-1].float().log_softmax(dim=-1)
    target = ids[:, 1:]
    picked = logp.gather(-1, target.unsqueeze(-1)).squeeze(-1)
    mask = answer_mask[:, 1:].bool()
    return picked.masked_fill(~mask, 0.0).sum(dim=-1)  # [2B]


def dpo_loss(policy_logp, reference_logp, beta):
    # 前 B 项为 chosen,后 B 项为对应 rejected
    chosen, rejected = policy_logp.chunk(2)
    ref_chosen, ref_rejected = reference_logp.detach().chunk(2)
    margin = (chosen - rejected) - (ref_chosen - ref_rejected)
    return -F.logsigmoid(beta * margin).mean()

p = torch.tensor([-4.0, -6.0], requires_grad=True)
r = torch.tensor([-5.0, -5.5])
loss = dpo_loss(p, r, beta=0.2)
loss.backward()
print(loss.item())  # 约 0.554355
print(p.grad)      # 约 [-0.0851115, 0.0851115]
训练时先让当前策略前向,再在 torch.no_grad() 中让冻结参考模型对相同 ID、attention mask 前向,分别调用 sequence_logprob。参考模型应关闭 dropout,使参考概率保持稳定;截断策略必须保证提示一致、有效回答未被截空。
数值实现使用 log_softmax 和 logsigmoid,直接在对数域计算,避免先求整段序列概率再取比值造成下溢。
DPO 学习的是数据中的偏好排序:标注者偏爱更长或更讨好的回答时,模型也会向这个方向调整。对于数学题或代码题,还可以直接检查答案是否满足任务要求,把正确性转成下一节的奖励信号。评估时分别统计偏好胜率和任务正确率,才能看出模型在哪一种标准下有所改善。
可验证奖励
可验证任务可以用预先规定的规则给回答打分,例如检查数学题的最终数值,或运行程序测试用例。令 表示验证器是否接受回答。在采用可验证奖励的强化学习(RLVR)中,模型在训练阶段采样回答,用 等反馈更新参数。
例如解方程 , 是待求数。解析器从回答中提取数值 ,验证 ,正确给 1,否则给 0。如果答案格式无法解析,也要事先规定处理规则。代码任务则可按通过测试的比例或全部通过与否给奖励,测试用例的覆盖范围决定了奖励检查哪些行为。
验证器给出的通过或失败信号通常无法直接求导,策略梯度通过回答的对数概率把信号传回模型。将一次完整回答视为一个动作,设 是不依赖本次采样回答的基线。把奖励视为不可微标量,策略梯度可写为
上式用奖励减去基线,衡量一次采样的结果比基线好多少。例如基线为 0.25,一条通过的回答权重为 0.75,一条失败回答为 -0.25;梯度上升相应提高通过回答的对数概率、降低失败回答的对数概率。实际训练还会加入 KL、裁剪或组内基线。
DeepSeek-R1 v1 §2.2.2描述 R1-Zero 的规则奖励,包括可检查的准确性和格式要求。结果奖励检查最终数字或测试输出;若任务还要求推导步骤有效,就要把步骤纳入检查。训练所用题目与独立测试题应分开,并明确奖励验证规则,以便用新题衡量模型的泛化表现。
樟木箱上的挂锁
奶奶从老屋搬回一只樟木箱,铜挂锁还锁着,钥匙早就没了。孙女小鹿拎着锁,去找街口配钥匙的冯师傅。
冯师傅看了看锁孔,拿出五片空白的钥匙坯,按他估计的齿形一片片切,每片的深浅各差一点。切完一片片插进锁里试。前三片转不动,第四片转了半圈卡住了。他把第四片拿回台上,在卡住的那一齿上锉了一下,再试,锁开了。
小鹿说:“冯师傅您真厉害,一下就配出来了。”冯师傅说,他手上的功夫跟昨天一样,今天不过多切了几片、多试了几回。哪片能用,是锁说了算。
他没马上把钥匙递过去,又用指肚把齿口摸了一遍,挑出一根毛刺锉平。锁只管转不转得开,不管钥匙会不会刮手,也不管用上一年会不会磨断。那几样还得他自己看。
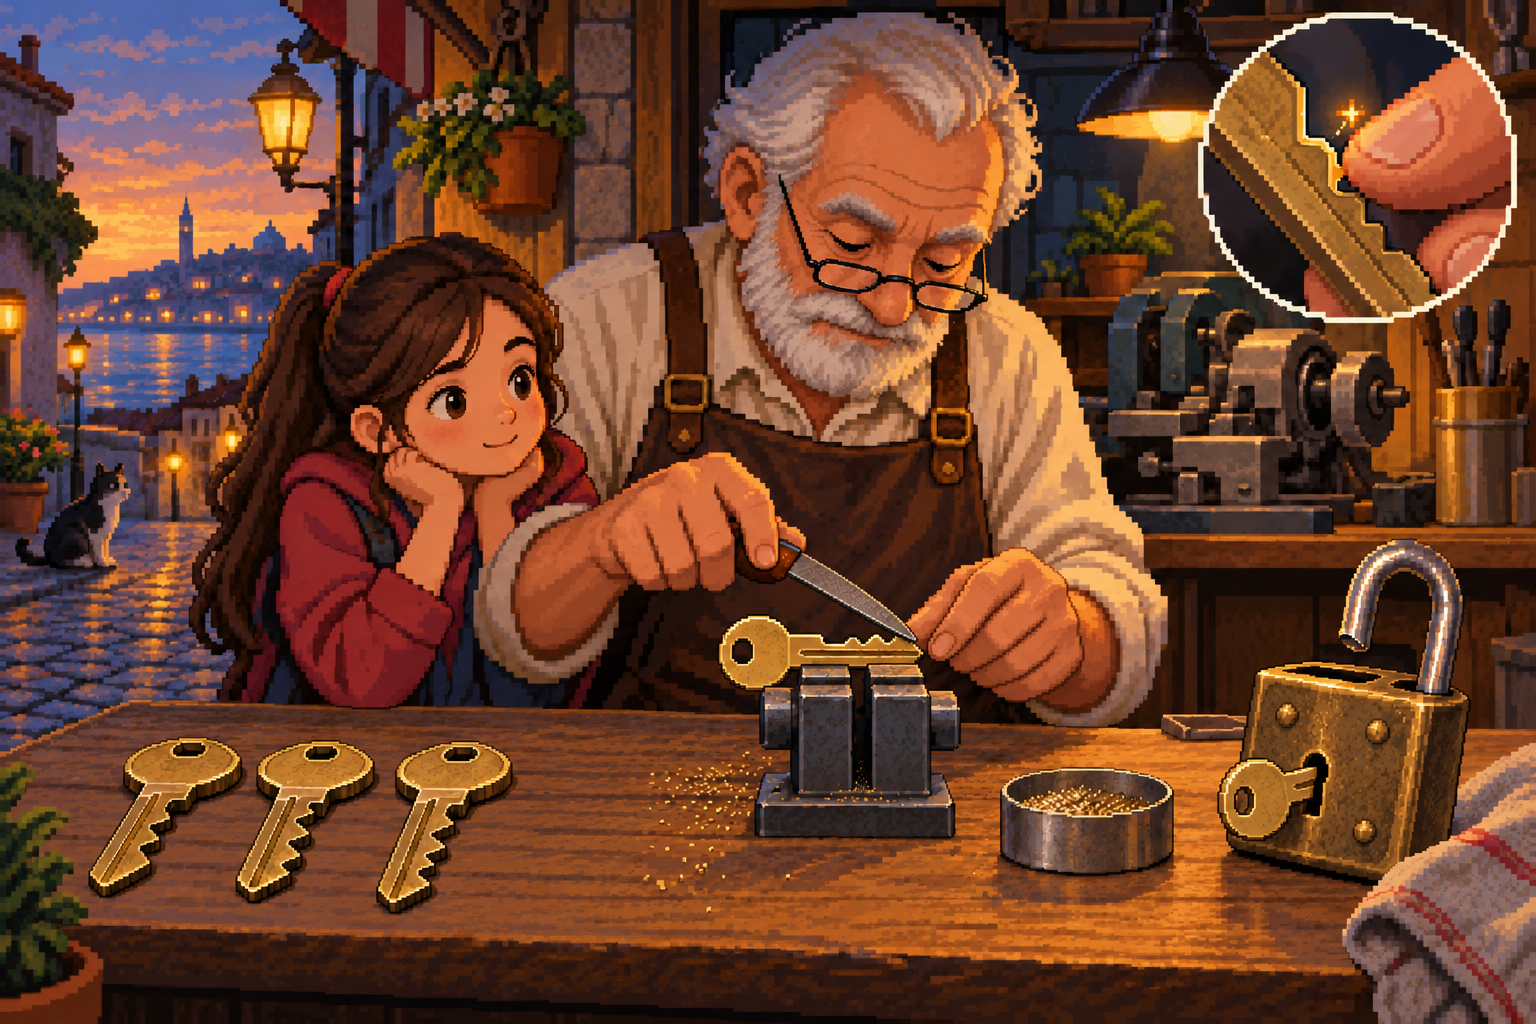
最后他把打开锁的那一片交给小鹿,另外四片扔进了废料盒。
这就是推理时计算:权重不变,一次任务里生成多个候选,交给验证器逐个检查,或者按检查结果改一改再查,最后返回通过的那一个。验证器只核对它覆盖的那几样性质。
推理时计算
验证器也可以直接用于一次任务中的候选筛选。锁匠多切几片钥匙、逐片试锁,再根据卡住的位置修整,对应生成候选、检查结果和带反馈修订。语言模型在推理阶段固定参数 ,通过改变候选数量、上下文和选择程序来分配计算。训练阶段的 RLVR 用反馈改变权重;推理时的每次调用使用同一检查点,把反馈用于当前问题。Snell 等 §2–3将候选生成与验证选择分开分析,也研究顺序修订。
对同一个问题“解 并核验”,候选数记为 ,可以采用以下策略:
| 策略 | 调用过程 | 返回方式 |
|---|---|---|
| 一次生成 | 生成一份解答 | 直接返回 |
| 多候选 | 独立采样 份解答 | 验证或打分后选一份 |
| 多数投票 | 采样多份,提取并归一化最终答案 | 选频次最高的答案 |
| 顺序修订 | 初稿、检查、带反馈修订 | 复查后返回选定版本 |
生成多份回答后,best-of- 用评分函数 ,在候选集合中选择 , 是候选编号。评分可来自规则、单独训练的验证器或另一次模型调用。多数投票只依赖答案出现次数:若模型多次重复同一个代数错误,它们会一起投错。用 检查则利用了题目本身的约束。
候选覆盖与实际选择
多生成候选首先提高的是“候选中包含正确答案”的机会。假设每次独立采样正确的概率为 ,则一次失败的概率是 ,连续 次都失败的概率是 。因此, 次中至少一次正确的概率为
取 ,结果为 0.8704。这对应 pass@4:四份候选中至少有一份正确的概率。最终回答的正确率还取决于选择器能否找出它。若候选里存在正确答案时,选择器选对的条件概率为 ,且只从原候选中返回,则最终正确率为 。
上述覆盖概率依赖独立采样的假设。如果四次始终给出同一份答案,覆盖率仍为 0.4。统计多题表现时,各题难度不同,应先对每题计算覆盖事件,再平均;把全部题的平均 塞进上式通常不等价。
候选覆盖成功后,不同选择规则仍可能返回不同答案。四份回答的最终数值为 ,唯一正确值是 4,故该题候选覆盖成功。多数投票返回 3;若一个学得的评分器依次打出 ,best-of-4 也返回 3;方程验证器会选第三份。
预算与延迟
总预算应包含未选中的候选、检查和修订。设 是第 次调用生成的 token 数, 是实际调用次数,则输出 token 总量为 。输出 token 总量便于统计,因此常用作预算指标。
计算总成本还要计入输入处理和验证器。模型先处理输入上下文(prefill),再逐个生成 token(decode);长上下文会提高这两个阶段的成本,不同大小的验证器每 token 成本也不同。
下面把输出上限固定为 1200 token,所有生成式调用使用相同模型,给同一问题分配预算:
| 分配 | 候选/初稿 | 检查 | 修订 | 输出总上限 |
|---|---|---|---|---|
| 单份长回答 | 0 | 0 | 1200 | |
| 并行候选后逐份评分 | 0 | 1200 | ||
| 顺序修订 | 400 | 600 | 1200 |
第二行的检查输入要包含待评分回答;第三行修订要读初稿与反馈,最后还要检查修订稿。因此即使输出 token 上限相同,输入 token、FLOPs 与延迟仍不同。规则检查没有输出 token,但有 CPU 时间或工具调用费用。
并行候选可以重叠生成,顺序修订必须等反馈才能继续。固定资源下比较延迟时,所有候选占用的设备都要算进去。
修订与停止
顺序修订用检查反馈帮助下一次生成定位错误:把问题、初稿和反馈拼成新的输入,再让模型作答。比如初稿给出 ,检查返回“代入左侧得到 9,与 11 不等”,模型下一次有了具体差错位置。这次生成使用原来的模型参数,但条件上下文增加了代入检查的结果。具体反馈给出了可修改的依据;仅提示“再想一想”时,模型可能保留原错,也可能改坏本来正确的答案。
修订流程需要明确停止条件:检查通过即停止,或达到调用次数、token 上限即停止;如果没有候选通过,就返回失败状态或按预设规则选择。验证器可靠时,多次尝试能把部分失败转成成功;验证器偏向某种错误时,搜索越多,越容易找到迎合它的回答。
参考文献
- Ouyang et al. Training language models to follow instructions with human feedback. 2022,arXiv:2203.02155v1,§3。
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023,arXiv:2305.18290v3,2024 修订,§3–4、附录 A。
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025,arXiv:2501.12948v1,§2.2。
- Snell et al. Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. 2024,arXiv:2408.03314v1,§2–3、§5–6。