
图像分类的数据通常已经给定;智能体选择动作时,动作会改变接下来看到的数据。例如向左走会看到另一条走廊,某次探索还能带来以后才收到的奖励。强化学习研究怎样通过这种交互改善决策。
马尔可夫决策过程(MDP)
在时刻 ,智能体获得状态 ,按策略 选动作 ,环境给出奖励 和下一状态 。一次经验可以记录为 ,其中 标记任务是否真正终止。
马尔可夫决策过程(MDP)用状态空间 、动作空间 、转移规律 、初始状态分布和折扣因子 描述问题。马尔可夫性质表示:给定当前状态和动作,下一状态、奖励的分布不再需要更早历史。
现实中传感器往往只给观测 。一帧画面未必包含速度,两个相同画面可能需要不同动作。可以堆叠相邻帧或使用 RNN汇总历史,形成策略的输入表示;该表示是否充分仍取决于任务。
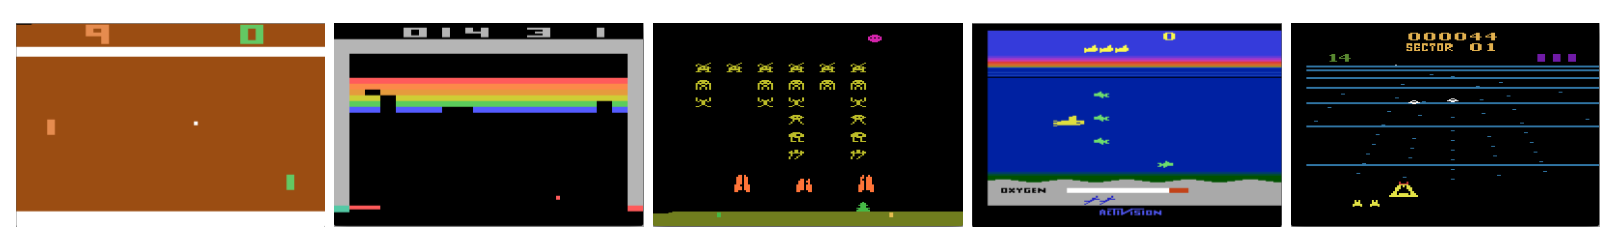
图 1:Mnih 等,2013,Playing Atari with Deep Reinforcement Learning Figure 1,裁去周围正文。游戏屏幕提供观测,动作由控制器发出,分数变化提供奖励。
监督学习直接提供目标标签 ;强化学习的奖励评价采取动作后的结果,通常没有告诉智能体当前最优动作是什么。训练数据随策略变化,并具有时间相关性。探索还会决定哪些动作得到尝试,从而影响估计的覆盖范围。
回报、价值与 Bellman 方程
从时刻 开始的折扣回报为
是终止时刻, 控制未来奖励的权重。有限回合可取 ;无限时域通常取 并要求回报存在。若接下来两步奖励为 0、1,,则 。奖励是某一步反馈,回报汇总了后续反馈。
状态价值和动作价值定义为
期望包含环境随机性与策略后续的动作选择。根据 ,有
终止状态的后续价值取零。最优动作价值 把下一步策略平均替换为最大值:
Bellman 关系把长序列问题写成“一步奖励加下一状态价值”。它为利用已有价值估计构造学习目标提供了依据。状态、策略、回报、价值函数与 Bellman 方程的定义可对照 OpenAI Spinning Up 的基本概念说明。
Q-learning
表格 Q-learning 为每个状态动作对存一个数。观测到一条转移后,构造目标和 TD 误差:
是更新步长, 表示真正终止。TD 是 temporal difference,指这两个相邻时间位置估计之间的差异。
设当前 ,本步奖励 ,下一状态最佳动作价值为 2,。则 、,更新为 。若这一步已经终止,,更新为 。
行为策略可以采用 -greedy:以概率 随机选动作,其余时间选当前 Q 最大的动作。更新目标仍使用下一状态的最大 Q,因此它学习的目标策略可以与采样动作的行为策略不同,这称为 off-policy。探索概率、状态访问次数及步长都会影响实际学习;表格方法的收敛条件不能直接移植为神经网络的收敛保证。
深度 Q 网络(DQN)
状态空间很大时,用网络 输出所有离散动作的价值。一个输入四维状态、具有两个动作的教学网络可采用 的 MLP,隐藏层用 ReLU。批次输入为 ,输出为 ,共 个参数。
输出中的两个数是预期回报估计,无需 softmax,也不要求位于 。按动作下标 gather 后得到 的已执行动作价值,再与 的 TD 目标比较。
DQN 使用经验回放存储过去的转移,从中随机采样 batch,削弱连续帧相关性并复用数据。常用的目标网络版本另存参数 ,计算
可以是平方误差或 Huber 损失。计算 时停止梯度,只更新在线网络 ;每隔一定更新次数复制 ,或按固定比例缓慢更新目标网络。回放缓冲区、在线网络、目标网络和优化器状态分别承担存数据、做预测、提供较稳定目标和更新参数的职责。
2013 年论文给出了经验回放与像素输入方法;这里的独立目标网络对应 2015 年 Nature DQN 的训练设计。上面的四维 MLP 是教学实例,论文 Atari 网络使用卷积处理图像。
下面片段展示一个回放 batch 的训练步骤。states/next_states 为 ,actions 为整数 ,rewards 为浮点 ,terminated 为布尔 ;online、target 均输出 :
q_taken = online(states).gather(1, actions[:, None]).squeeze(1)
with torch.no_grad():
    next_q = target(next_states).max(dim=1).values
    td_target = rewards + 0.99 * (~terminated).float() * next_q
loss = torch.nn.functional.smooth_l1_loss(q_taken, td_target)
optimizer.zero_grad(set_to_none=True)
loss.backward()
torch.nn.utils.clip_grad_norm_(online.parameters(), 10.0)
optimizer.step()
# 按预先设定的更新间隔执行:target.load_state_dict(online.state_dict())
完整交互循环先采样动作,执行环境一步,把转移放入回放;缓冲区有足够数据后开始采样训练,定期更新目标网络。执行多少环境步与做多少梯度更新是两个计数,应分别记录。PyTorch DQN 教程提供了环境交互、回放和训练的完整实现。
终止与时间截断
到达任务终点或失败状态是 termination,后续回报为零。因采样预算耗尽而停止一段仍在继续的任务是 truncation,通常仍应从真实的最后观测估计后续价值。Gymnasium 分别返回 terminated 和 truncated;环境重置条件可用二者的或,TD 目标的 bootstrap 掩码要按任务终止语义设置。
若时间上限本来就是任务定义的一部分,剩余时间也应进入状态,到期按真正终止处理。自动重置的向量环境还要取到重置前的最后观测,不能把新回合第一帧当成 。Gymnasium 时间限制文档解释了此处对价值目标的影响。
策略梯度
另一条路线让网络输出策略 。离散动作可用 softmax,连续动作可输出高斯分布的均值和尺度。策略按该分布采样动作,训练目标为最大化期望回报。
以有限回合、折扣目标 为例,一种 Monte Carlo 策略梯度估计为
是本次采样的轨迹数, 为从 起、相对该时刻折扣的回报, 是不依赖当前动作的基线。外侧 对应本式从回合起点定义的折扣目标;若采用不折扣有限回合目标,取 。策略梯度的形式及函数逼近条件见 Sutton 等,1999。
直观上,优于基线的动作提高其对数概率,低于基线则降低。单步二动作例子中,策略 logits 为 ,选了动作 0,优势取 2。用最小化形式 ,其对 logits 的梯度为 。学习率为 0.1 时更新后 logits 为 ,动作 0 的概率从 0.5 增至约 0.5498。
策略损失中的回报或优势在本次反传中作为固定权重。直接重用很久以前策略采样的数据会改变估计,若没有相应的重要性修正,不能把普通 on-policy 更新当成任意回放算法。
Actor-critic
actor 输出动作分布,critic 估计 。两者可以共用编码器,也可以是独立网络。以 个状态、 个离散动作为例,actor logits 为 ,critic 输出为 。
一阶 TD 优势估计为
将 停止梯度后,critic 用 拟合目标。actor 用 更新,若遵循前面的起点折扣目标,还应带上对应的 权重。共享编码器时,总损失汇总两项的梯度,并明确 critic 权重。
例如 ,优势为 2.3,actor 提高已采动作概率,critic 把当前预测向 2.8 推近。critic 的自举减少等待整段回合的需要,也会引入价值估计误差。
可额外最大化策略熵 ,在最小化目标里写成 , 控制探索鼓励强度。评价时固定采用采样还是贪心动作,不要混用两种策略的结果。价值函数、优势和策略优化的实践关系可参见 OpenAI Spinning Up 的策略优化推导。
训练与评价
先确定观测、动作、奖励和终止条件,再测随机策略或简单规则的回报。奖励缩放与裁剪会改变数值尺度,奖励设计还会决定模型愿意牺牲什么。例如仅奖励速度的导航策略可能频繁碰撞,所以报告应同时列出成功率、碰撞率和耗时。
训练时记录环境交互步数、梯度更新次数、探索设置和各随机种子的曲线。评价使用固定的环境版本、独立初始条件、回合数与时间上限;分开记录真正完成和超时。最终汇总多个独立训练种子,每个策略再运行多个评估回合。大量回合能减小某个策略的测试波动,不能替代多个训练种子来测量训练不稳定性。指标汇总与置信区间见评价与泛化。