读到“这家店虽然很远,但味道很好”时,最后的判断需要用到前面的词。若每个词都独立通过同一个全连接层,当前位置就拿不到前文。循环神经网络(recurrent neural network,RNN)为每条序列保存一个状态:读入新元素,用它和旧状态计算新状态,再把新状态传给下一步。
矩阵采用样本在行上的写法,批量维放在最前。
RNN 单元
设一批序列的表示为 X∈RB×T×D。B 是样本数,T 是时间步数,D 是每步输入维度。取第 t 步得到 Xt∈RB×D;状态 Ht∈RB×H,这里斜体 H 表示隐藏宽度。最简单的 tanh RNN 为
At=XtWx+Ht−1Wh+bh,Ht=tanh(At).
Wx∈RD×H 把输入变成状态宽度,Wh∈RH×H 变换旧状态,bh∈RH 沿批量广播。tanh 对每个元素计算,把结果压在 (−1,1)。常用初始状态是 H0=0。
Wx,Wh,bh 是训练后供所有样本、所有时间步共用的参数;Ht 是当前样本读到第 t 步时产生的中间值。换一条无关序列时重置状态;连续音频被切成几段时,可以把上一段末状态传到下一段。时间展开会重复使用同一组参数,序列变长不会增加参数量。Cho 等人的 RNN Encoder–Decoder 论文 §2给出了这一递归状态与序列概率的联系。
若每一步要预测 C 类,接输出层
Ot=HtWo+bo∈RB×C,Pt,c=∑j=1Cexp(Ot,j)exp(Ot,c).
上式概率省略了样本下标。Wo∈RH×C,bo∈RC;Ot 是 logits,softmax 在类别轴归一化。做句子分类时只取最后一个有效状态;做词性标注时每个位置都接输出层;做语言模型时第 t 步输出用于预测第 t+1 个 token。
状态更新示例
取 B=D=H=1,输入依次为 1,0,−1,Wx=1、Wh=0.5、bh=0、h0=0。这组权重是教学用的指定值。
| 时间步 |
输入 xt |
激活前 at=xt+0.5ht−1 |
状态 ht=tanh(at) |
| 1 |
1 |
1 |
0.7616 |
| 2 |
0 |
0.3808 |
0.3634 |
| 3 |
−1 |
−0.8183 |
−0.6741 |
第二步输入是零,状态仍然携带第一步的信息。若最终二分类 logits 定义为 [h3,−h3],得到 [−0.6741,0.6741],softmax 约为 [0.2062,0.7938]。若真实类别是第二类,交叉熵为 −log(0.7938)≈0.2309。
换成实际张量:两句话,每句补齐到 5 个 token,嵌入宽度 4,状态宽度 3,分类数 2。
| 操作 |
输入与参数 |
输出 |
| 查嵌入表 |
token ID 为 (2,5),词表大小为 V,表为 (V,4) |
X:(2,5,4) |
| 第 t 步输入映射 |
(2,4)@(4,3) |
(2,3) |
| 旧状态映射、相加与 tanh |
(2,3)@(3,3),加 (3,) 偏置 |
Ht:(2,3) |
| 收集全部状态 |
5 次更新 |
(2,5,3) |
| 取各句最后有效状态并分类 |
(2,3)@(3,2)+(2,) |
logits (2,2) |
不计嵌入表,循环单元有 4⋅3+3⋅3+3=24 个参数,输出层有 3⋅2+2=8 个,共 32 个。这里每个单元用一组偏置;某些库把输入和状态偏置分开存储,参数计数会多一组 H。
若第二句话只有 3 个有效词,应取它的 H3。继续让 padding 参与更新再取 H5,即使 padding 向量为零,Ht=tanh(Ht−1Wh+bh) 仍可能改变状态。实现可以打包变长序列,也可以在无效位置保留旧状态。
随时间反向传播(BPTT)
训练先按时间顺序保存各步状态,再由损失反向穿过展开后的计算图,这叫 backpropagation through time(BPTT)。同一个 Wh 出现在每一步,它的梯度是所有使用位置的贡献之和。逐位置任务的损失通常写成
L=−Nvalid1b=1∑Bt=1∑Tmb,tlogPb,t,yb,t,Nvalid=b,t∑mb,t.
yb,t 是正确类别,mb,t∈{0,1} 标记有效位置。训练时计算损失、反传、更新共享权重;隐藏状态通常是计算结果,不是优化器中独立维护的参数。反向传播章解释链式法则与参数更新。
对单个样本暂改用列向量表示导数,记 Jt=∂ht/∂ht−1,则
Jt=diag(1−ht2)Wh⊤,∂ht∂hT=JTJT−1⋯Jt+1.
diag 把向量放到对角线上,平方逐元素计算。远处的梯度要乘很多个 Jacobian:持续收缩的方向会消失,持续放大的方向会爆炸。标量例子里,若每一步局部导数都为 0.5,跨 20 步只剩 0.520≈9.54×10⁻⁷;若都是 1.5,则为 1.520≈3325。真实网络的局部导数随输入变化,这两个数只是乘积效应的算例。Pascanu 等人分析了这一问题及梯度裁剪。
梯度范数裁剪把过大的整组梯度按比例缩小,避免一次更新过猛。截断 BPTT 则每隔 K 步切断计算图:下一段可以沿用状态数值,但梯度不再回到更早片段。它节约显存,也缩短了能够直接分配学习信号的时间范围。
LSTM
LSTM 同时传递隐藏状态 Ht 和细胞状态 Ct,两者均为 (B,H)。采用常见的带遗忘门、无 peephole、无投影版本:
FtItGtOtCtHt=σ(XtWf+Ht−1Uf+bf),=σ(XtWi+Ht−1Ui+bi),=tanh(XtWg+Ht−1Ug+bg),=σ(XtWo+Ht−1Uo+bo),=Ft⊙Ct−1+It⊙Gt,=Ot⊙tanh(Ct).
这里 Ot 表示输出门,前面的分类 logits 在本节不使用这个符号。σ(a)=1/(1+e−a),⊙ 是逐元素乘法。每套 W 为 (D,H)、U 为 (H,H)、b 为 (H,),四个门或候选量的输出全为 (B,H)。
遗忘门 Ft 决定每个记忆分量保留多少;输入门 It 控制候选 Gt 写入多少;输出门 Ot 决定多少细胞信息暴露给下一层。门是输入和旧状态共同算出的连续数值,会随样本、时间和通道变化。
取某一通道的 ct−1=0.8,本步算出 ft=0.9,it=0.2,gt=−0.5,ot=0.75,则
ct=0.9×0.8+0.2×(−0.5)=0.62,ht=0.75tanh(0.62)≈0.4133.
沿细胞状态的直接加法通路、暂固定门和候选时,∂ct/∂ct−1=ft。门接近 1 时,这条通路能让信息和梯度经过更多步;完整导数还包括门随旧状态变化的路径。遗忘门持续偏小依然会丢失记忆。
LSTM 原论文(1997)提出了记忆单元;以上常用公式包含后续引入的遗忘门,具体形式与PyTorch LSTM 文档一致。对 D=4,H=3,单偏置约定下单元参数量为 4(DH+H2+H)=96;两套偏置的实现为 4H(D+H+2)=108。输入 (2,5,4) 产生全部隐藏输出 (2,5,3),末尾还保留 H5,C5 各 (2,3)。堆叠多层时,每层有自己的状态与参数。
GRU
GRU 只传递 Ht。采用 Cho 等人原论文的写法:
RtZtHtHt=σ(XtWr+Ht−1Ur+br),=σ(XtWz+Ht−1Uz+bz),=tanh(XtWg+(Rt⊙Ht−1)Ug+bg),=Zt⊙Ht−1+(1−Zt)⊙Ht.
Rt 是重置门,控制旧状态有多少参与候选计算;Zt 是更新门,在这一符号约定下,越接近 1 越保留旧状态。三个 W 均为 (D,H),三个 U 均为 (H,H),门、候选与状态均为 (B,H)。有些教材把 Zt 的两项权重交换,阅读时应以最后一行确定门的含义。
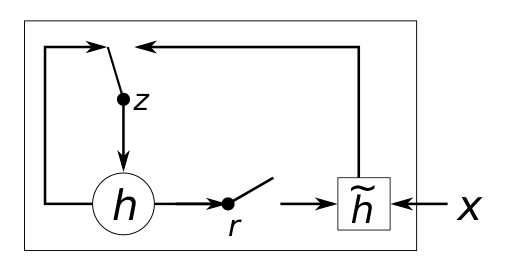
图 1:Cho 等人,2014,图 2,从论文 PDF 第 3 页裁出。图中的 z,r,h~ 分别对应更新门、重置门和候选状态。原图许可为 CC BY-NC-SA 3.0,此处仅裁剪图框并栅格化。
标量例子取 xt=1,ht−1=0.8,rt=0.25,zt=0.75,Wg=0.5,Ug=1,bg=0。先算候选:h~t=tanh(0.5+0.25×0.8)=tanh(0.7)≈0.6044;再混合:ht=0.75×0.8+0.25×0.6044≈0.7511。
在 D=4,H=3 的批量例子中,单偏置 GRU 有 3(DH+H2+H)=72 个参数,输出仍为 (2,5,3)。它比上述 LSTM 少一套仿射变换,也少传一份细胞状态。
PyTorch GRU把候选中的重置门放在隐藏线性变换之后,即 Rt⊙(Ht−1Ug+bhg),并另加输入投影及其偏置。原论文是先按通道重置再乘 Ug。一般矩阵会混合通道,两种顺序并不相等;复现时要同时对齐公式与权重格式。
双向 RNN 与编码器、解码器
双向 RNN 用两套参数,一套从左到右、一套从右到左。每个位置拼接两个宽度为 H 的状态,得到 (B,T,2H)。完整句子的标注可以使用两侧上下文;逐词生成时,未来词尚不存在,生成方向只能使用已经得到的信息。
编码器把源序列压到末状态,解码器把这份状态作为条件,一步步输出目标序列。源长 5、目标长 4 时,可以把源状态 (2,3) 映射成解码器初始状态,再依次输入起始 token 和目标前缀,得到 (2,4,V) 的 logits。训练给解码器真实的前一个 token,称为 teacher forcing;推理把自己刚生成的 token 喂回去,直到结束标记或长度上限。训练与推理前缀的差别会使前期错误继续影响后续输出。
源句变长时,所有细节挤进一个定长末状态会增加编码压力。注意力保留全部源状态,让解码器每步重新选择需要的信息。Transformer则直接用注意力交换位置间的信息。
