翻译一句话时,生成不同目标词需要查阅源句的不同位置。如果编码器只交出一个末状态,每次解码都只能使用同一份压缩结果。注意力保留一组可查阅的表示,让当前输出位置先计算与各位置的匹配分数,再按分数汇聚内容。Bahdanau 等人的论文把这种可学习的对齐过程用于循环编码器与解码器。
注意力运算也适用于图像块、文本 token 或其他特征序列。
Query、Key 与 Value
把当前要查询的表示称为 query(查询)q;每条候选信息提供 key(键)kj 用来打分,以及 value(值)vj 用来汇聚。若有 S 个候选位置,输出为
ej=score(q,kj),αj=∑s=1Seeseej,c=j=1∑Sαjvj.
ej 是任意实数分数;αj≥0 且和为 1;c 与每个 vj 同维。一个分数对 value 的所有通道使用同一权重。分数比较“应该取多少”,value 提供“取来的内容”。这两种任务可以通过不同的线性投影来学习。
例如三个 value 为 (2,0),(0,4),(2,2),权重为 (0.5,0.25,0.25),输出就是 (1.5,1.5)。此时还没有发生 token 选择或离散检索,三个位置都以不同权重参与结果。后续梯度可通过加权和、softmax 和打分函数传回 query、key、value 的生成网络。
加性注意力与缩放点积注意力
加性注意力先把 query 和 key 映射到同一内部宽度,再用小网络输出标量。采用行向量:
et,j=tanh(qtWq+kjWk+b)wa.
qt∈Rdq、kj∈Rdk;Wq∈Rdq×da、Wk∈Rdk×da、b∈Rda、wa∈Rda×1,所以结果是标量。t 索引查询位置,j 索引源位置。Bahdanau 的解码器用前一步解码状态查询源端的双向编码状态;各源位置共享这套打分参数。
缩放点积注意力则让 query 与 key 有相同宽度 dk,用内积直接打分。把一批查询和候选堆成张量:
QKVEAC∈RB×L×dk,∈RB×S×dk,∈RB×S×dv,=dkQK⊤+M,=softmax源位置(E),=AV.
这里 B 是批量,L 是查询数,S 是候选数,dv 是值的宽度。K⊤ 只交换最后两轴,得到 (B,dk,S);E,A 为 (B,L,S);输出 C 为 (B,L,dv)。M 是可广播到分数张量的加性 mask。
为什么除以 dk?若各分量独立、均值为零、方差为 1,点积是 dk 项之和,方差为 dk。宽度增加时,大分数容易使 softmax 接近只选一个位置,梯度也随之变小。除以 dk 后,在这一假设下分数方差回到 1。这是Transformer 原论文 §3.2.1采用缩放的理由。
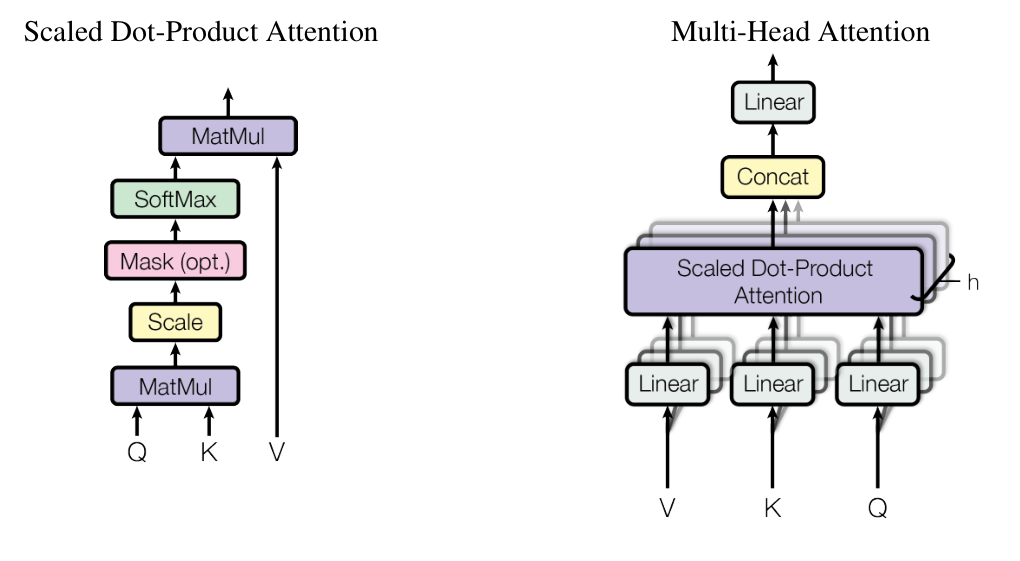
图 1:Vaswani 等人,2017,图 2,从 PDF 第 4 页裁出。左图从下向上读;右图每个头都有自己的投影。
注意力计算示例
令 B=L=1,S=3,dk=dv=2,省略批量轴:
Q=[10],K=101011,V=202042.
不加 mask,先得到 QK⊤=[1,0,1],缩放后为 [0.7071,0,0.7071]。指数约为 [2.0281,1,2.0281],除以总和后
A≈[0.4011,0.1978,0.4011],C≈[1.6044,1.5933].
第三个 key 与第一个 key 在这个 query 下得分相同,两个 value 都被取入。若第三个位置是 padding,则加上 M=[0,0,−∞],softmax 变为 [0.6698,0.3302,0],输出变为 [1.3395,1.3210]。屏蔽改变了归一化分母,其余权重也跟着变化。
可以用下面的 NumPy 运算复算;减去行最大值能避免指数溢出,而不改变 softmax。
import numpy as np

q = np.array([[1., 0.]])
k = np.array([[1., 0.], [0., 1.], [1., 1.]])
v = np.array([[2., 0.], [0., 4.], [2., 2.]])
scores = q @ k.T / np.sqrt(k.shape[-1])
weights = np.exp(scores - scores.max(axis=-1, keepdims=True))
weights /= weights.sum(axis=-1, keepdims=True)
print(weights)
print(weights @ v)
自注意力、交叉注意力与 mask
自注意力的三组投影来自同一个序列 X∈RB×T×d:Q=XWQ,K=XWK,V=XWV。三个矩阵分别学习查询、匹配和内容表示;它们的来源相同,数值通常不同。输出第 t 行是该位置查询整条允许访问的序列后得到的表示。
交叉注意力的查询来自目标序列 Y∈RB×L×dy,键和值来自源序列 X∈RB×S×dx。例如两句翻译,目标长 3、源长 5,投影后 Q:(2,3,4),K:(2,5,4),V:(2,5,6),分数为 (2,3,5),输出为 (2,3,6)。输出长度跟查询走;键和值的长度必须一致,才能逐位置配对。
生成第 t+1 个 token 时不能看到它及其后的内容。用位置 t 的输入预测下一词时,因果 mask 允许查看 j≤t:
Mt,j={0,−∞,j≤t,j>t.
对长度 3 的序列,mask 为
M=000−∞00−∞−∞0.
Padding mask 则按每条样本的真实长度屏蔽无效的键位置,常整理为 (B,1,1,S) 广播到所有头、所有查询。因果 mask 常为 (1,1,T,T)。二者相加决定最后可见的位置。
每个有效查询至少要留下一个可见键;整行都为 −∞ 时,通常的 softmax 会产生未定义值。Padding 查询对应的输出也应从损失和后续有效位置汇聚中排除。各接口布尔 mask 的“真”含义可能不同;PyTorch MultiheadAttention 文档规定其布尔屏蔽位置为 True,传参时需按所用接口确认。
多头注意力
只用一个权重矩阵时,每个查询给所有 value 通道共用一套位置权重。多头注意力先投影成多组较窄的 query、key、value,每组独立算注意力,再拼接和混合:
Qi=XWQ(i),Ki=XWK(i),Vi=XWV(i),headi=Attention(Qi,Ki,Vi),Z=Concat(head1,…,headh),MHA(X)=ZWO.
h 为头数。常用 dk=dv=d/h,此时每个投影矩阵为 (d,d/h),拼接恢复宽度 d,输出矩阵 WO 为 (d,d)。各头得到的关系由训练目标学习,没有预先给某个头指定“语法”或“语义”职能。
取 B=2,T=3,d=8,h=2,全部过程如下:
| 运算 |
张量尺寸 |
| 输入 X |
(2,3,8) |
| 一次线性层同时投影 QKV |
(2,3,24) |
| 切成 Q、K、V 并拆头、转轴 |
各 (2,2,3,4) |
| 每头 QK⊤/4 |
(2,2,3,3) |
| 沿最后一轴 softmax,再乘 V |
(2,2,3,4) |
| 转回位置在前,再拼接头 |
(2,3,8) |
| 乘 WO:(8,8) |
(2,3,8) |
QKV 的合并投影权重为 (8,24),输出投影为 (8,8),共 192+64=256 个权重;带偏置再加 24+8=32,总计 288。固定总宽度 d 时,增加头数同时减小每头宽度,这个标准配置的投影参数总量仍是 4d2+4d。拆头后必须交换头轴与序列轴,不能直接把同样数量的元素当作正确布局。
训练与计算复杂度
注意力层本身不指定预测任务。把输出送到分类器、解码器或其他网络,任务损失的梯度就能更新 WQ,WK,WV,WO。softmax 的导数为 ∂αj/∂ek=αj(δjk−αk),其中 δjk 在 j=k 时为 1,否则为 0。它说明改变某个分数会同时影响同一行的其他权重。
若无位置表示和位置相关 mask,任意重排输入会让自注意力输出按同样顺序重排;模块无法单凭内容判断两个相同 token 的先后。因此Transformer还要引入位置信息、逐位置前馈网络、残差和归一化。
对长度 T、宽度 d 的标准自注意力,QK 与 AV 两次乘法总量级为 O(BT2d),投影为 O(BTd2)。显式保存各头的分数需要 BhT2 个元素。取 B=1,h=8,T=4096,单个分数张量有 134,217,728 个元素,float32 就是 512 MiB,尚未计入梯度和其他激活。融合实现可以避免完整保存这个张量,但全连接位置交互本身仍有二次计算量。FlashAttention 原论文解释了分块计算如何减少高带宽显存读写。
与 RNN 比较,全序列自注意力在一层内就能让两个可见位置直接交换信息;RNN 需要沿状态链传播。因果 Transformer 训练可以并行处理所有已知位置,实际生成时仍要等上一个新 token 产生后再预测下一个。
