注意力能让一个位置从其他位置取信息,但完整模型还需要区分位置、变换通道、保留已有表示,并把最后的表示转成预测。Transformer 把这些运算组成重复堆叠的 block:注意力负责位置间的信息交换,前馈网络负责每个位置内部的非线性变换,残差和归一化连接各层。
算例取批量 B=2、序列长 T=3、模型宽度 d=8、头数 h=2、前馈宽度 dff=16;这些是教学尺寸,原论文 base 模型使用 d=512,h=8,dff=2048。
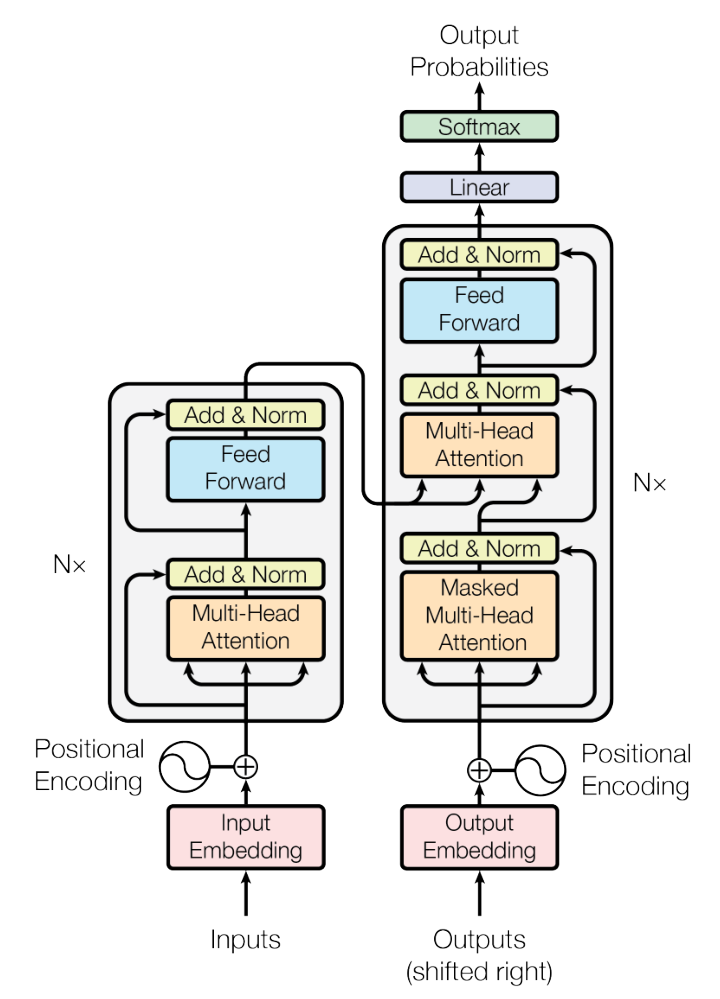
图 1:Attention Is All You Need,图 1,裁自 PDF 第 3 页。沿箭头从下往上读。左侧输出进入右侧中间的注意力层;“N×”表示堆叠多层,通常每层参数独立。
嵌入与位置编码
设词表大小 V=10,输入 ID 为 (2,3),每个整数索引嵌入表 E∈R10×8 的一行,得到 (2,3,8)。标准注意力仅凭这些内容向量不能区分先后位置,因此原论文将位置编码与嵌入逐元素相加:
Xb,t,:(0)=dE[idb,t]+Pt,:.
P∈RT×d 沿批量广播,缩放 d 是原论文的嵌入约定。位置从 0 开始,固定正弦位置编码为
Pt,2i=sin(100002i/dt),Pt,2i+1=cos(100002i/dt),0≤i<d/2.
i 索引通道对,各对使用不同频率。对 d=8,分母依次为 1,10,100,1000。位置 0 的向量为 [0,1,0,1,0,1,0,1];位置 1 的前四个分量约为 [0.8415,0.5403,0.0998,0.9950],后四个约为 [0.0100,1.0000,0.0010,1.0000]。相同 token 出现在不同位置时,加到它上面的向量不同。固定正弦表没有训练参数;若改用最大长度为 Tmax 的可学习位置表,则增加 Tmaxd 个参数。原论文 §3.5描述了这两种选择。
编码器层
先使用图中的 Post-LN 结构。忽略 dropout 的随机性,一个 block 为
U=LN1(X+MHA(X,X,X)),Y=LN2(U+FFN(U)).
MHA 的三个输入依次产生 Q、K、V。它们都来自本层输入 X;两个 LN 分别有自己的参数;Y 交给下一层。X,U,Y 全是 (2,3,8)。实际训练在每个子层输出加回残差之前应用 dropout;推理关闭 dropout。
| 位置 |
操作 |
输出尺寸 |
| 输入 |
嵌入与位置编码相加 |
(2,3,8) |
| QKV 投影 |
(8,24) 权重加 (24,) 偏置 |
(2,3,24) |
| 拆分与转轴 |
2 个头,每头宽 4 |
Q、K、V 各 (2,2,3,4) |
| 自注意力 |
缩放点积、mask、softmax、乘 V |
(2,2,3,4) |
| 拼头与输出投影 |
合并为宽 8,再乘 (8,8) |
(2,3,8) |
| 残差与 LN |
与输入逐元素相加,按通道归一化 |
U:(2,3,8) |
| FFN 第一层 |
(8,16) 权重及 (16,) 偏置,再 ReLU |
(2,3,16) |
| FFN 第二层 |
(16,8) 权重及 (8,) 偏置 |
(2,3,8) |
| 残差与 LN |
与 U 相加并归一化 |
Y:(2,3,8) |
逐位置前馈网络
原论文的 position-wise FFN 是
FFN(u)=ReLU(uW1+b1)W2+b2.
u 为宽度 d 的行向量;W1:(d,dff)、b1:(dff,)、W2:(dff,d)、b2:(d,)。同一层所有位置共享这些权重,各位置独立计算;跨位置通信发生在注意力中。第二个线性层恢复宽度,才能与残差相加。
用更小的 d=2,dff=3 单独验算。令 u=[1,−2],偏置为零:
W1=[10011−1],W2=10101−1.
第一层得到 [1,−2,3],ReLU 后为 [1,0,3],第二层为 [4,−3],残差相加得到 [5,−5]。每一步都在同一位置内部处理通道。
LayerNorm
对某个样本、某个位置的向量 u∈Rd,
μ=d1j=1∑duj,s2=d1j=1∑d(uj−μ)2,LN(u)j=γjs2+ϵuj−μ+βj.
均值和方差沿该位置的特征轴计算;γ,β∈Rd 是训练参数,ϵ>0 防止除零。对 u=[1,3],μ=2,s2=1,若 γ=[1,1],β=[0,0] 且暂忽略很小的 ϵ,输出为 [−1,1]。LayerNorm 每次都用当前向量的统计量,不需要 BatchNorm 那样的运行均值。参见Layer Normalization 原论文。
常见 Pre-LN 把归一化移到子层输入:
U=X+MHA(LN1(X)),Y=U+FFN(LN2(U)).
此处 MHA 的 QKV 都由归一化后的输入产生,堆栈末尾通常再接一次 LN。两种结构的归一化位置改变了残差路径和梯度行为;Xiong 等人的分析专门比较了它们。复现图 1 时用 Post-LN,阅读具体模型实现时按它的实际顺序计算。
参数量
教学模型每个带偏置编码器 block 中,多头注意力有 4d2+4d=288 个参数;FFN 有 ddff+dff+dffd+d=280 个;两个 LN 各有 2d=16 个,共 32 个。合计 288+280+32=600 个。
序列长 3 变为 30,block 参数仍为 600,但激活和注意力计算增多。堆两层且不共享权重,就是 1200 个 block 参数。它们与嵌入表的 80 个参数、任务输出头分开计数。普通 Transformer 层不保存 RNN 式的单个递归隐藏状态;全序列前向保存各层激活,生成时还可保存各层的 KV cache。
编码器与解码器
编码器自注意力通常能看整条有效输入,适合把完整文本变成上下文表示。分类时可以取专门的汇聚 token,或对有效位置做平均,再接 (d,C) 分类权重,得到 (B,C) logits。
原论文的解码器每层有三个子层:带因果 mask 的目标端自注意力、查询源端表示的交叉注意力、FFN。交叉注意力里 Q 来自本层目标表示,K、V 来自最后一层编码器输出。若源长 S=5、目标长 L=3,均宽 8,两个头的交叉分数是 (2,2,3,5),汇聚并拼头后回到 (2,3,8)。因果约束加在目标自注意力上;翻译时整句源文本已知,目标每步可看全部有效源位置。原论文 §3.1 与 §3.2.3给出了这一信息流。
由此得到三种常用组织方式:
| 结构 |
可见信息与输出 |
训练任务例子 |
| Encoder-only |
每个输入位置访问双向上下文 |
掩码 token 预测、整句分类 |
| Encoder-decoder |
源端双向编码,目标看过去及源端 |
翻译、条件文本生成 |
| Decoder-only |
每个位置只访问自身和更早位置 |
下一 token 预测 |
Decoder-only 使用因果自注意力和 FFN 堆栈,没有源端交叉注意力子层。Transformer 指这类网络组织方式;自回归指序列概率分解与生成顺序。
训练目标
设一条目标序列为“我、爱、猫、EOS”,EOS 为结束标记。取长度 4 的训练输入 [BOS, 我, 爱, 猫],标签为 [我, 爱, 猫, EOS];BOS 表示开始。输入和标签错开一位,配合因果 mask,输入位置 t 只能根据目标前缀预测该位置的标签。
最后一层隐表示为 (B,4,d),乘词表输出矩阵 Wvocab∈Rd×V 并加偏置,得到 (B,4,V) logits。沿词表做 softmax,再对有效标签取负对数平均:
ℓb,t=−logpθ(yb,t∣yb,<t,c),L=Nvalid1b,t∑mb,tℓb,t.
c 表示条件输入,ℓb,t 是单个位置的负对数似然;m 标记有效目标,Nvalid 是有效 token 数;decoder-only 省去源端条件。若词表大小为 4,某位置 logits 为 [0,log2,0,0],softmax 为 [0.2,0.4,0.2,0.2],标签为第二类时损失是 −log0.4≈0.9163。实现交叉熵时通常直接传 logits,库内部用稳定的 log-softmax。
真实训练把损失对所有层反传,更新嵌入、投影、FFN、归一化和输出头。原论文还采用 label smoothing 与学习率 warmup;这里的交叉熵算例没有加入平滑。
训练数据提供完整目标,因此因果 mask 下的各位置可在一次前向中并行计算。推理只知道前缀,要取最后位置的 logits 产生一个 token,再把它追加到前缀,重复直到 EOS 或长度上限。贪心选择最大概率;温度采样先算 softmax(o/τ),τ>0,再随机抽取,较小温度让分布更集中。
KV cache
因果模型中,一个已处理位置不依赖未来 token,所以它在各层产生的 K、V 可以复用。第一次处理整个提示称为 prefill;之后每步仅计算新 token 的 Q、K、V,把新 K、V 接到该层缓存,再用新 Q 查询全部缓存。Hugging Face 的官方缓存说明给出了这一过程。
用 B=2,h=2,dk=dv=4 的标准多头模型,已经缓存 3 个位置时,每层 K、V 各为 (2,2,3,4)。新 token 的 Q、K、V 各为 (2,2,1,4);追加后缓存为 (2,2,4,4),新 query 的注意力分数为 (2,2,1,4)。只需要新位置的输出,不再重算历史位置。
N 层、长度 T 的标准缓存共存 2NBTd 个标量,前面的 2 来自 K 与 V。教学模型若 N=2,B=2,T=3,d=8,就是 192 个标量,float32 占 768 字节;生成一个 token 后增到 256 个标量。缓存减少重复投影和历史计算,仍需让新 query 与不断增长的历史 key 交互。不同请求的缓存分别维护,修改旧前缀时要使相应缓存失效。
