分类模型给一张图预测类别;生成模型要产生一张新图,或在已有前缀后续写文本。训练样本提供可学习的分布规律,模型需要把这些规律变成明确的采样过程。
图像算例多用两张 28×28 灰度图,即 (B,C,H,W)=(2,1,28,28),展平后是 (2,784);小尺寸网络和指定数值均用于说明计算。
自回归模型
对 token 序列 x1,…,xT,概率链式法则给出
pθ(x1,…,xT)=t=1∏Tpθ(xt∣x<t),LAR=−t=1∑Tlogpθ(xt∣x<t).
x<t 表示此前所有 token,θ 是模型参数。第一项以起始标记或空前缀为条件。训练让真实序列的负对数似然下降;生成时先抽取 x1,再以它为条件抽取 x2,一直继续到结束标记。条件分布可以由 RNN 或因果 Transformer 计算。Cho 等人的论文 §2.1明确写出了序列概率乘积及逐步采样方式。
例如词表为 {BOS, A, B, EOS},一批含两条序列,训练输入为 [[BOS,A,B],[BOS,B,A]],标签为 [[A,B,EOS],[B,A,EOS]]。嵌入宽度 8,输入 ID 为 (2,3),隐表示为 (2,3,8),输出投影 (8,4) 产生 (2,3,4) logits。因果 mask 保证每个位置只访问给定前缀。若第一条的正确 token 条件概率依次为 0.5,0.25,0.8,整条序列概率为 0.1,负对数似然为 −log0.1≈2.3026,按 3 个 token 平均为 0.7675。
这个目标适用于确定了顺序的离散数据。将图像按行展开成像素序列也能这样建模,代价是逐位置采样较慢。对于连续像素,输出需要改成合适的连续分布参数或先离散化,不能直接把灰度值当词表索引。模型权重在生成过程中固定,前缀与 KV cache 随采样增长。
自编码器(AE)
自编码器(autoencoder,AE)把输入压到潜在表示,再从表示重建输入:
z=fϕ(x),x^=gθ(z),LAE=BD1b=1∑Bj=1∑D(xb,j−x^b,j)2.
ϕ 为编码器参数,θ 为解码器参数,D 是输入展平维度,z 是样本的低维编码。MSE 是连续数值的一种重建目标。编码器和解码器一起反传,输入本身提供目标,不需要额外类别标签。利用瓶颈重建高维数据的经典实例见 Hinton 与 Salakhutdinov(2006)。
灰度图例子可使用带偏置的全连接网络:
| 阶段 |
运算 |
批量尺寸 |
| 输入 |
展平两张图 |
(2,784) |
| 编码 |
Linear(784,128) + ReLU |
(2,128) |
| 潜在层 |
Linear(128,16) |
z:(2,16) |
| 解码 |
Linear(16,128) + ReLU |
(2,128) |
| 重建 |
Linear(128,784) + sigmoid |
(2,784) |
| 还原布局 |
reshape |
(2,1,28,28) |
这里把输入缩放到 [0,1],sigmoid 也输出这个区间。四个线性层共有 100480+2064+2176+101136=205856 个参数。瓶颈宽度 16 迫使模型用较少数值表达重建所需的信息;若网络容量大且缺少约束,单纯重建可能学到接近复制的映射。
用 D=2 的例子检验损失:输入 x=[1,0],设编码器把它映成 z=0.5,解码器输出 x^=[0.6,0.2],则平均平方误差为 ((1−0.6)2+(0−0.2)2)/2=0.1。梯度既更新解码器,也穿过 z 更新编码器。
训练完成后,AE 能重建给定输入,也能提供压缩表示。若要从零生成,需要额外规定从哪里抽取 z。普通 AE 的重建目标没有约束编码的总体分布,因此直接抽标准高斯可能落在解码器未见过的区域。VAE 把潜在分布及其训练目标一并定义出来。
变分自编码器(VAE)
变分自编码器(variational autoencoder,VAE)先定义生成过程:
z∼p(z)=N(0,I),x∼pθ(x∣z).
N 为高斯分布,I 是单位协方差,z∈RK 是潜变量。解码器根据 z 输出观测分布的参数,例如每个二值像素取 1 的概率。数据的边缘概率为 pθ(x)=∫p(z)pθ(x∣z)dz,这个积分通常不能直接算完,因此引入编码器分布 qϕ(z∣x) 近似后验。
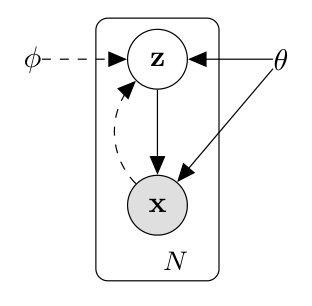
图 1:Kingma 与 Welling,Auto-Encoding Variational Bayes,图 1,裁自 v11 PDF 第 2 页。ϕ 控制推断网络,θ 控制生成模型;外框表示 N 个观测。
重参数化
取对角高斯近似后验:
qϕ(z∣x)=N(μϕ(x),diag(σϕ2(x))).
沿用 (2,784)→(2,128) 的编码特征,接两个 Linear(128,16) 头,分别输出 μ 与 ℓ=logσ2,各为 (2,16)。用 ℓ 表示对数方差,经过指数就能得到正方差。采样采用重参数化:
ϵ∼N(0,I),z=μ+exp(ℓ/2)⊙ϵ.
ϵ,z 也为 (2,16)。随机性放在与参数独立的 ϵ 中,固定一次噪声样本后,z 对 μ,ℓ 的路径可以正常求导。解码器仍按 (2,16)→(2,128)→(2,784) 运算。相较上面的 AE,多一个 2064 参数的头,总计 207920 个参数。
证据下界(ELBO)
VAE 最大化证据下界(ELBO):
E(x)=Eqϕ(z∣x)[logpθ(x∣z)]−KL(qϕ(z∣x)∥p(z)).
其来源是恒等式
logpθ(x)=E(x)+KL(qϕ(z∣x)∥pθ(z∣x)).
右侧 KL 非负,所以 E(x)≤logpθ(x)。第一项奖励潜变量能解释观测;第二项限制后验偏离先验的程度,使训练时使用的编码与生成时的采样分布建立联系。优化器最小化 −E。推导和重参数化见原论文 §2 与附录 B。
若先验是标准高斯、后验为上述对角高斯,单个样本的 KL 可直接计算:
KL(q∥p)=21j=1∑K(μj2+eℓj−1−ℓj).
重建项取决于观测模型。二值像素 xj∈{0,1} 可用独立 Bernoulli,解码器输出概率 πj,负对数似然为 −∑j[xjlogπj+(1−xj)log(1−πj)]。连续观测若用固定方差高斯,负对数似然则含按方差缩放的平方误差。两种选择对应不同的数据假设。
完整小算例取 x=[1,0]、K=2、μ=[1,0]、ℓ=[0,0]。后验标准差为 [1,1],一次噪声 ϵ=[0.5,−1] 给出 z=[1.5,−1]。设解码器在该点输出 π=[0.8,0.3],单次重建负对数似然为 −log0.8−log0.7≈0.5798;KL 为 0.5,这次负 ELBO 的单样本估计为 1.0798。重建项、潜变量项都按维度求和,再对批量平均。如果把重建项改为像素平均而 KL 仍求和,两项相对权重会改变。
训练每个批次重新采噪声,反传同时更新 ϕ,θ。生成时直接抽取 (B,16) 的标准高斯 z,只运行解码器得到 (B,784) 分布参数,再按观测模型采样并 reshape。展示 Bernoulli 概率图相当于展示条件均值;真正的 Bernoulli 样本是逐像素抽得的 0 或 1。
生成对抗网络(GAN)
生成对抗网络用生成器 Gθ 把噪声 z∼p(z) 映射成数据,再让判别器 Dψ(x)∈(0,1) 区分真实样本与生成样本。原始目标为
θminψmaxV(θ,ψ),V(θ,ψ)=Ex∼pdatalogDψ(x)+Ez∼p(z)log(1−Dψ(Gθ(z))).
pdata 表示训练数据分布,θ,ψ 为两套独立参数。判别器要给真图较高概率、假图较低概率;生成器通过判别器反馈调整自己产生的样本。Goodfellow 等人的原论文 §3还提出非饱和生成器损失,改善早期训练信号:
LD=−ExlogDψ(x)−Ezlog(1−Dψ(Gθ(z))),LG=−EzlogDψ(Gθ(z)).
后者替代生成器原先最小化的 Ezlog(1−D(G(z)))。判别器强、D(G(z)) 很小时,非饱和形式能提供更强的生成器更新信号。
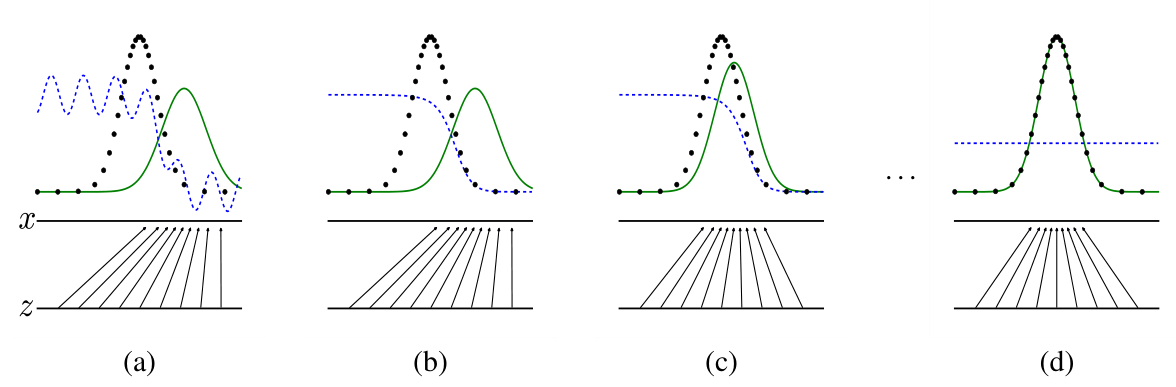
图 2:Generative Adversarial Nets,图 1,裁自 v1 PDF 第 3 页。黑色点线是数据分布,绿色实线是生成分布,蓝色虚线是判别器;下方箭头表示噪声到数据的映射。图示的是一维分布的训练过程。
让生成器接收 (2,16) 高斯噪声,通过 Linear(16,128)、ReLU、Linear(128,784)、sigmoid 得到 (2,784),共有 2176+101136=103312 个参数。判别器接收真图或假图的 (2,784),通过 Linear(784,128)、LeakyReLU、Linear(128,1) 得到 (2,1) logits,共 100480+129=100609 个参数;sigmoid 把 logits 转成真假概率。
一次交替更新按下面的顺序执行:
- 抽真图和噪声,生成假图;算 LD。在这一步把假图从生成器计算图中分离,只更新 ψ。
- 用噪声再次产生假图,经判别器计算 LG。固定判别器参数,但保留从判别器输入回到生成器的导数,更新 θ。
若一张真图的 D(x)=0.8,一张假图的 D(G(z))=0.2,上述求和约定下 LD=−log0.8−log0.8≈0.4463,LG=−log0.2≈1.6094。若把两类合在一个批次整体平均,判别器损失会多一个 1/2 因子,记录实验时要注明 reduction。
训练结束后采样只需 z→G(z),不运行判别器。生成器把简单噪声分布推成复杂数据分布,通常不直接给出可计算的 pθ(x)。若许多噪声都映到少数相似输出,会出现模式坍塌;单看判别损失下降无法说明生成覆盖了多少数据模式,需要同时评价质量与多样性。
扩散模型
DDPM(denoising diffusion probabilistic model)指定一个逐步加噪的前向过程,再训练网络表示反向转移。这里 t 是噪声步骤,T 为总步数,与文本 token 位置无关。x0 是干净数据,xt 与它形状相同。
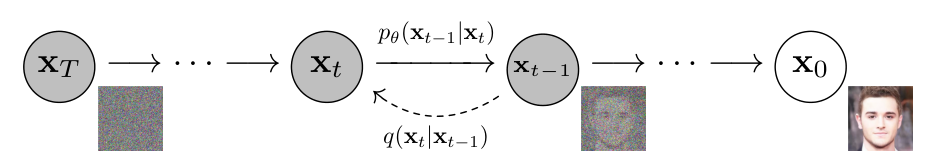
图 3:Ho、Jain 与 Abbeel,2020,图 2,裁自作者提供 PDF 第 2 页。q 是加噪转移,pθ 是学习的反向转移。
前向加噪
设每步噪声方差 0<βt<1,定义 αt=1−βt、αˉt=∏s=1tαs。前向转移与它的闭式边缘分布为
q(xt∣xt−1)=N(αtxt−1,βtI),xt=αˉtx0+1−αˉtϵ,ϵ∼N(0,I).
第一项逐步衰减原图信号,第二项补入噪声。选择使 αˉT 接近零的日程后,末端接近标准高斯。训练时使用第二个式子直接构造随机选定的 xt,不必真的循环加噪 t 次。
假设某一步 αˉt=0.81,某像素 x0=0.5,本次噪声 ϵ=−1,则 xt=0.9×0.5+0.19×(−1)≈0.0141。单个含噪数值无法唯一确定原始像素;网络靠训练数据中的统计关系预测去噪方向。
噪声预测网络
DDPM 的常用简化目标是
Lsimple=Ex0,t,ϵ[∥ϵ−ϵθ(xt,t)∥22].
训练随机取数据、噪声步骤 t∼Uniform{1,…,T} 和高斯噪声,构造 xt,让网络预测本次噪声。ϵθ 的输出与输入图像同形;t 经时间嵌入告诉网络当前噪声强度。该目标来自 DDPM 对变分目标的参数化与重新加权,不等同于完整负对数似然的逐项精确计算。公式与训练算法见原论文 §3 及 Algorithm 1。
一个用于理解尺寸的小网络可以把 (2,1,28,28) 的 xt 展平成 (2,784),把每个 t 编码为 16 维,拼接成 (2,800),经过 Linear(800,128)、SiLU、Linear(128,784),最后 reshape 回 (2,1,28,28)。SiLU 为 aσ(a);两个线性层有 102528+101136=203664 个参数,固定时间编码不增加参数。输出层保持线性,因为噪声可正可负。实际 DDPM 使用带时间条件的 U-Net,在多尺度特征之间用跳跃连接传递空间信息;卷积、下采样和融合分别见 CNN及网络组合。
用卷积写一个教学用 U-Net 时,也能逐步核对空间尺寸:先用 3×3、padding 为 1 的卷积把 (2,1,28,28) 变成 (2,32,28,28),再用 4×4、stride 为 2、padding 为 1 的卷积降到 (2,64,14,14)。中间的 3×3 卷积保持这个尺寸。把每个样本的时间嵌入线性投影成 64 维,整理成 (2,64,1,1) 后加到特征上,所有空间位置就都能获得时间条件。
上采样把空间恢复到 28×28,与先前保存的 (2,32,28,28) 浅层特征沿通道拼接,得到 (2,96,28,28);接 3×3 卷积降至 32 通道,最后 1×1 卷积输出 1 通道噪声。深层特征提供较大范围的信息,跳跃连接保留较细的空间结构。卷积核、偏置和时间投影由训练更新;跨步骤反复调用的是同一个网络,浅层跳跃特征只在本次调用内保存。这组简化尺寸用于解释 U-Net 的数据流,与原论文的具体层数、通道数分开。
若上面像素的真实噪声为 −1,网络预测 −0.8,这一分量的平方误差就是 0.04。批量训练对所有像素求和后平均样本,或统一对全部元素求平均;两者相差固定维数因子。反传只更新去噪网络参数,预设的噪声日程不参加更新。
反向采样
开始抽 xT∼N(0,I),随后按 t=T,T−1,…,1 调用同一个网络。DDPM 的噪声参数化给出反向均值
μθ(xt,t)=αtxt−αt1−αˉtβtϵθ(xt,t),xt−1=μθ(xt,t)+σtz.
t>1 时 z∼N(0,I) 是新抽的噪声;最后一步按原文采样算法取 z=0。一种固定方差选择为
σt2=βt=βt1−αˉt1−αˉt−1,αˉ0=1.
σt 控制反向采样的随机性。若某步 αt=0.9,αˉt−1=0.9,则 αˉt=0.81、βt=0.1。使用刚才的 xt≈0.0141 和预测噪声 −0.8,得到 μθ≈0.2083,σt≈0.2294;若本步抽到 z=0.2,则 xt−1≈0.2542。这一步得到较低噪声的状态,仍要继续迭代到 x0。
从预测噪声也能估计干净图:x^0=(xt−1−αˉtϵθ)/αˉt。这个估计与上述反向采样的 xt−1 作用不同:前者指向干净端,后者保持当前采样日程的下一步分布。所有时间步共享 θ;生成中的状态是不断更新的 xt,多次网络调用也构成主要采样成本。
条件生成再把标签、文字或其他输入 c 送入网络,写成 ϵθ(xt,t,c)。例如文本条件可通过交叉注意力进入图像特征,Q 来自图像,K、V 来自文本。潜空间扩散则先用自编码器把图像压成较小的连续张量,在这个空间训练和采样扩散,再解码回图像;具体实现与像素空间 DDPM 的区别见Latent Diffusion 原论文。
训练与采样比较
| 方法 |
训练时的数据与目标 |
生成或使用时的起点 |
推理计算 |
| 自回归 |
真前缀预测真下一个元素,负对数似然 |
起始标记或给定前缀 |
逐元素预测并追加 |
| AE |
输入重建自身,重建误差 |
一份输入 |
编码再解码;额外采样分布需另建 |
| VAE |
观测编码成后验,优化重建项与 KL |
从先验抽潜变量 |
解码成观测分布并采样 |
| GAN |
真数据与噪声,交替优化判别和生成目标 |
从简单分布抽噪声 |
运行生成器 |
| DDPM |
数据加已知噪声,预测噪声 |
与数据同形的高斯噪声 |
反复调用去噪网络和采样器 |
这些目标可以搭配不同网络:卷积或 Transformer 都能组成去噪器,RNN 或 Transformer 都能输出自回归条件分布。比较模型时先确定要衡量似然、重建误差、样本质量还是条件符合度。五类训练损失的数值尺度与含义不同,不能直接用大小排出生成质量的顺序;实际比较需要固定数据、采样设置和评价协议。
