
一层运算已经能把输入变为新表示。组织多层时,还需确定哪些表示继续向前,哪些跨层保留,来自不同分支的信息在哪里汇合。这些选择会同时改变前向信息流、参数量和梯度路径。
顺序堆叠
令 ,依次计算
是第 个模块输出, 是它的参数, 是模块数。整个网络为 。每个模块可以是一层线性变换,也可以是“卷积、归一化、激活”的组合。上一层输出尺寸必须符合下一层输入约定。
例如 ,经过 Linear(4,6) → ReLU → Linear(6,2),形状依次为 。参数量是 。ReLU 改变数值但不改变形状,也没有参数。
深层网络的反传包含多层导数相乘。若沿某一标量路径每层导数都是 0.5,经过 10 层后的乘积是 ;若都是 2,则为 。真实网络的导数是矩阵,但这个例子能说明梯度缩小或增大的来源。增加深度还可能带来更难优化的训练目标,ResNet 论文据此研究了普通网络加深后的训练误差变化。原论文第 1、3 节给出了比较设定。
残差连接
设块输入为 ,主分支 输出同样形状。最基本的残差相加是
学习要添加到输入上的变化。假设一条输入 ,主分支算出 ,则相加为 。若该块在相加后还使用 ReLU,最终输出就是 。
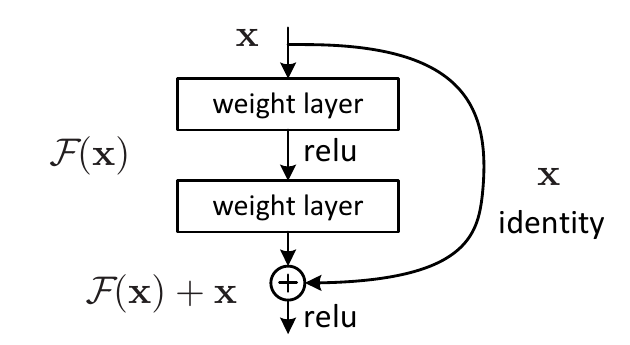
图 1:摘自 He 等,ResNet,CVPR 2016,图 2。裁去周围正文,保留相加后的 ReLU。图中 经过两个权重层,identity 分支直接传入 。
前向过程中两个分支都使用同一个输入,相加后仍是宽度 的表示。恒等分支没有可学习参数,相加需做逐元素加法。参数量由主分支决定;若主分支是 的两层 MLP,则有 个参数。
残差也改变反传。先考虑没有相加后激活的 ,对单条样本临时采用列向量记法,令 :
是 单位矩阵, 是最终标量损失。右侧含直接传回的 与经过主分支的梯度。若再接 ReLU,需要先乘其激活导数;负值位置会被截断。初始化、主分支尺度和归一化仍会影响梯度传播。
投影分支
若主分支把 变成 ,输入无法原样相加。可以在短接上放投影 :
选择 卷积、stride 2,把 32 个通道映射为 64 个通道,并同时下采样。无偏置时,投影参数量为 。主分支和短接分支需要相同的张量尺寸,各空间位置也要对应相同的采样布局。
一个带 BatchNorm 的卷积残差块可以这样写:
import torch
from torch import nn

class ResidualBlock(nn.Module):
    def __init__(self, cin, cout, stride=1):
        super().__init__()
        self.main = nn.Sequential(
            nn.Conv2d(cin, cout, 3, stride=stride, padding=1, bias=False),
            nn.BatchNorm2d(cout), nn.ReLU(),
            nn.Conv2d(cout, cout, 3, padding=1, bias=False),
            nn.BatchNorm2d(cout),
        )
        self.skip = (
            nn.Identity() if cin == cout and stride == 1
            else nn.Sequential(
                nn.Conv2d(cin, cout, 1, stride=stride, bias=False),
                nn.BatchNorm2d(cout),
            )
        )

    def forward(self, x):
        return torch.relu(self.main(x) + self.skip(x))

block = ResidualBlock(32, 64, stride=2)
x = torch.randn(2, 32, 28, 28)
y = block(x)
assert y.shape == (2, 64, 14, 14)
assert sum(p.numel() for p in block.parameters()) == 57728
这里是便于教学的投影残差块。两层主分支卷积分别有 和 个权重;加上短接投影的 2048 个,以及三组 BatchNorm 各 个可学习参数,总计 。BatchNorm 的运行均值、方差是另外保存的状态。ResNet 原论文也讨论了无参数补零短接和投影短接等选择。
相加、拼接与门控
当两个分支都描述同一批对象时,可以选择不同的汇合方式。
相加要求各轴匹配,且坐标需要通过设计或训练对应起来。若 ,则 仍为 。例如 ,输出已将两路信息叠到同一组坐标。
拼接则沿一个轴保留两路坐标。若 、,
对于 与 ,拼接结果为 。拼接本身没有参数,后接 的线性层才学习如何组合两路信息。例如图像向量宽 128、数值特征宽 16,拼接后宽 144,再投影到 64 维,需要 个参数。可直接用 torch.cat([u, v], dim=-1),其文档要求除拼接轴外其余尺寸一致。
对空间特征, 与 沿通道拼接成为 。编码器深层特征与浅层细节可能有不同高宽,需要先上采样、裁剪或做坐标对齐。U-Net 原论文通过上采样与来自编码器的裁剪后特征拼接,将定位细节带入解码过程;原始结构的裁剪与其无补零卷积有关。
还可以让模型决定各路占比。以同形状 为例:
表示沿特征轴拼接,、 生成门控, 是 sigmoid, 是逐元素乘法。每个 坐标在 0 到 1 之间。若 ,得到 。门控网络有 个参数,训练时与两路编码器共同接收最终损失的梯度。多位置的内容相关加权见注意力。
归一化
归一化模块按指定的一组坐标计算均值和方差,再缩放、平移:
是该组的均值、方差, 避免分母过小, 是可学习的缩放和平移。模块之间的重要区别是“哪一组值共享统计量”和“预测时用什么统计量”。
BatchNorm2d 对 的每个通道,在 batch 与空间位置共 个值上计算统计量。默认训练模式下用当前 batch 的均值、方差,并维护运行统计量;默认评估模式使用运行统计量。可学习的 各有 个元素,运行均值和方差各有 个元素,但不由优化器梯度更新。PyTorch 训练归一化使用有偏方差估计,更新运行方差使用无偏估计;两者区别见 BatchNorm2d 文档。
LayerNorm 常用于 的序列表示,在每个样本、每个位置的最后 个特征上算均值和方差。设 normalized_shape=d,则 各有 个元素。训练和评估都根据当前输入算统计量,不需要 BatchNorm 那样的运行均值。LayerNorm 原论文与官方实现给出了这种归一化轴的选择。
例如一个位置的特征 ,其均值为 2、方差为 1。取 ,忽略很小的 时,归一化结果约为 。若用 BatchNorm,参与统计的数值来自同一通道的其他样本及位置,结果一般会不同。
归一化与相加的顺序也改变函数。原始 ResNet 的常见块是 Conv → BN → ReLU → Conv → BN → Add → ReLU。序列模型中常见的两种排列是
LN 表示 LayerNorm。前者把归一化放在主分支内,短接路径直接相加;后者对相加后的结果再归一化。二者在反传中的路径不同,相关分析见 Xiong 等,On Layer Normalization in the Transformer Architecture。具体 Transformer block 的完整信息流由对应章节展开。
残差块训练示例
前向时,框架记录分支运算;反传遇到相加节点,会把输出梯度传给两路,再把汇到同一输入或共享参数上的梯度累加。拼接反传则按原分支宽度切分梯度。除非主动冻结参数或截断计算图,主分支、投影、门控和各编码器都可以由同一个最终损失联合训练。
保存模型时,应同时保存参数和 BatchNorm 运行统计量;要继续原来的优化过程,还需保存优化器状态。model.eval() 会改变 BatchNorm、Dropout 等模块的行为,torch.no_grad() 则控制是否记录求导所需的计算图。两者分别服务于推理行为和内存计算开销,见 PyTorch 自动求导说明。
上面的投影块输入 ,两路都得到 后相加;三个 BatchNorm 的统计状态随训练更新,卷积、缩放和平移参数由损失梯度更新。