在 32×32 图像上寻找一段竖直边缘,左上角与右下角可以使用同一种检测规则。卷积把这条规则写成一个小核,在整张图像上复用。多层卷积网络逐步组合局部响应,再根据任务生成类别、位置或像素级预测。
卷积运算
采用 NCHW 排列,输入 X∈RB×Cin×H×W,卷积核权重
K∈RCout×Cin×kh×kw,b∈RCout.
B 是样本数,Cin,Cout 是输入、输出通道数,kh,kw 是核的高宽。普通卷积的每个输出通道都读取全部输入通道。忽略 batch 下标,令 Xpad 是四周补零后的输入,则
Yo,u,v=bo+c=0∑Cin−1i=0∑kh−1j=0∑kw−1Ko,c,i,j⋅Xc,ush+idh,vsw+jdwpad.
o 是输出通道,(u,v) 是输出位置,(i,j) 是核内位置;sh,sw 是步幅,dh,dw 是膨胀率。步幅控制相邻窗口移动多远,膨胀率控制核内采样点隔多远。多个通道的乘积相加后产生一个标量,同一个 K 在所有空间位置复用。
深度学习库实现的上述运算通常是互相关:不翻转核。数学卷积会翻转核的空间坐标。PyTorch Conv2d 文档明确采用互相关约定;对可学习的核而言,采用哪个方向主要影响记号与实现对应。
取单通道、无补零、步幅和膨胀率均为 1 的例子:
X=147258369,K=[100−1],b=0.
左上角窗口的输出是 1⋅1+2⋅0+4⋅0+5⋅(−1)=−4;右上角是 2−6=−4。整个输出为
Y=[−4−4−4−4].
若有第二个输入通道,它会用同一输出通道对应的另一片核进行计算,再加到这四个结果上。若要输出 8 个通道,就学习 8 组覆盖全部输入通道的核。
输出尺寸与参数量
高度方向每侧补 ph 个零,膨胀卷积核占据的有效宽度为 dh(kh−1)+1。最后一个窗口必须完整落在补齐后的输入中,因此
Hout=⌊shH+2ph−dh(kh−1)−1⌋+1.
宽度同理,将 H,ph,kh,dh,sh 换成对应的 W,pw,kw,dw,sw。⌊⋅⌋ 表示向下取整。这个写法假设两侧补零相同;非对称补零时把 2ph 换成上下补零量之和。
输入 (8,3,32,32),使用 16 个 3×3 核、stride 1、padding 1、dilation 1,则
Hout=⌊(32+2−2−1)/1⌋+1=32,
输出为 (8,16,32,32)。把 stride 改成 2 后,高宽变成 16。若输入大小为 31,同样设置仍得到 16,所以“减半”在奇数尺寸上要按公式计算。dilation 2 的 3×3 核覆盖 5×5 范围,只有 9 个采样位置;配 padding 2、stride 1 时可以保持高宽。
不分组且有偏置的卷积参数量为
Cout(Cinkhkw+1).
上述 3→16 的卷积只有 16(3×3×3+1)=448 个参数,但权重需要在 8×32×32 个位置重复使用。参数量小与运算次数小是两回事;乘加次数约为 BHoutWoutCoutCinkhkw。
分组卷积将通道分成 g 组,每组只连接自己的输入通道,权重参数变为 Cout(Cin/g)khkw,另加可选偏置。输入和输出通道数都要能被 g 整除。深度卷积是 g=Cin 的特例。1×1 普通卷积则在每个位置混合通道,不直接扩大空间邻域。
池化
池化在每个通道内部汇聚窗口,不同通道保持分开。最大池化取窗口最大值,平均池化取均值;通常都没有可学习权重。例如
[1234]max pool4,[1234]average pool2.5.
2×2 窗口、stride 2 的池化把 32×32 变成 16×16。最大池化反传时将梯度交给被选中的最大值位置;平均池化把梯度按平均权重分配。其输出尺寸规则还受 ceil_mode 影响,下文使用默认向下取整。
全局平均池化把每个通道的整张特征图平均:
vb,c=HW1u=1∑Hv=1∑WXb,c,u,v.
它把 (B,C,H,W) 变为 (B,C),然后可接一个分类线性层。空间平均舍去了精确位置,适合“图中是什么”的汇总;像素级分割通常保留或恢复空间输出。
感受野
某个输出位置所依赖的输入区域叫感受野。对顺序连接的卷积和局部池化,用 rl 表示第 l 层的理论感受野边长,用 jl 表示相邻两个输出中心在原始输入上相隔多少个像素。初始 r0=1,j0=1,递推为
jl=jl−1sl,rl=rl−1+(kl−1)dljl−1.
这里在一个方向计算;矩形核可分别处理高和宽。kl,sl,dl 是当前层的核大小、步幅、膨胀率。逐点激活不改变 r,j。递推与更多分支情形可参见 Distill 的感受野推导。
取 3×3 conv → 2×2 pool → 3×3 conv → 2×2 pool,步幅依次为 1,2,1,2,膨胀率均为 1:
| 运算后 |
r |
j |
对原图的含义 |
| 第一层卷积 |
3 |
1 |
每点读取宽 3 的区域 |
| 第一次池化 |
4 |
2 |
相邻中心相距 2 像素 |
| 第二层卷积 |
8 |
2 |
新增两个跨度为 2 的邻域间隔 |
| 第二次池化 |
10 |
4 |
每点理论上覆盖宽 10 的区域 |
这算的是连接结构允许覆盖的范围;padding 附近有一部分位置落在补零上,真实输入的贡献还取决于权重、激活和池化选择。两个 stride 1 的 3×3 卷积形成宽 5 的理论感受野,层间还可放一次非线性,这就是小核堆叠同时扩展范围与变换能力的具体方式。
CNN 分类示例
把三分类相册任务具体化,输入是 B 张 32×32 RGB 图像:
| 模块 |
输出形状 |
可学习参数 |
| 输入 |
B×3×32×32 |
0 |
| Conv 3→8,3×3,padding 1;ReLU |
B×8×32×32 |
8(3⋅9+1)=224 |
| MaxPool 2×2,stride 2 |
B×8×16×16 |
0 |
| Conv 8→16,3×3,padding 1;ReLU |
B×16×16×16 |
16(8⋅9+1)=1168 |
| MaxPool 2×2,stride 2 |
B×16×8×8 |
0 |
| 全局平均池化,展平 |
B×16 |
0 |
| Linear 16→3 |
B×3 |
16⋅3+3=51 |
总参数量为 224+1168+51=1443。第二次池化后的局部感受野为 10×10。全局平均池化汇总 8×8 个位置,其理论覆盖边长为 10+7×4=38,包含补零区域,实际可依赖整张 32×32 输入。
数据先在局部邻域内组合,再随池化扩大在原图上的间隔,最后变成每个通道一个汇总数。这个模型的参数是两层卷积和输出线性层的权重、偏置;没有跨图像传递的循环状态,也没有 BatchNorm 运行均值。反向传播会将分类损失依次传给线性层、平均池化、卷积与输入激活;某个卷积权重在所有使用它的位置上累积梯度。
import torch
from torch import nn
torch.manual_seed(7)
model = nn.Sequential(
nn.Conv2d(3, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(16, 3),
)
x = torch.rand(4, 3, 32, 32)
y = torch.tensor([0, 1, 2, 0], dtype=torch.long)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
model.train()
optimizer.zero_grad()
logits = model(x)
assert logits.shape == (4, 3)
loss = nn.functional.cross_entropy(logits, y)
loss.backward()
optimizer.step()
assert sum(p.numel() for p in model.parameters()) == 1443
model.eval()
with torch.no_grad():
predictions = model(x).argmax(dim=1)
print(predictions.shape)
随机图像与标签用于检查形状和训练调用顺序。学习真实分类规律时,要把它们替换成训练集批次,并用独立数据做评价。
ResNet
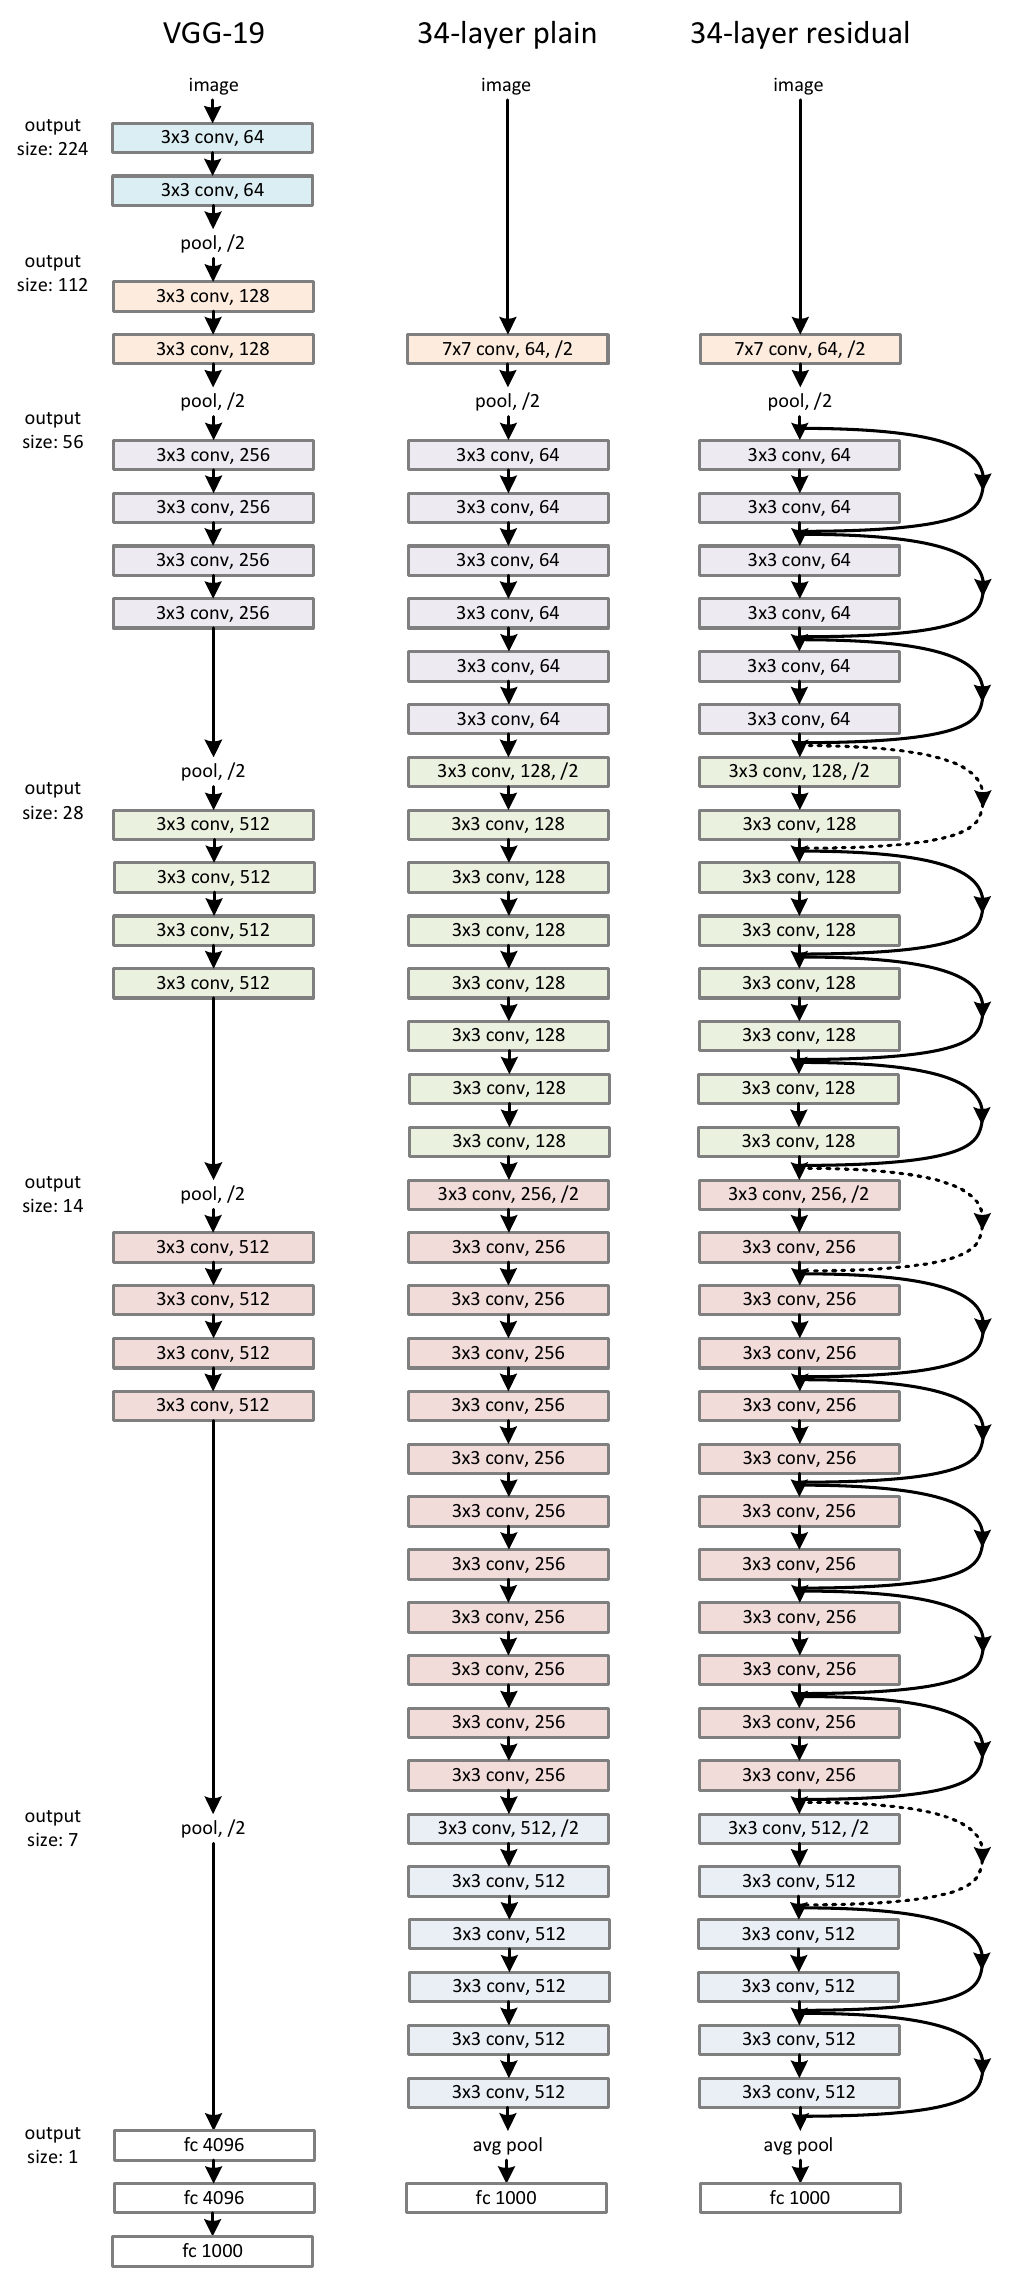
图 1:摘自 He 等,Deep Residual Learning for Image Recognition,CVPR 2016,图 3。保留三列架构,裁去周围正文。中列与右列方便对照跳跃连接;/2 表示 stride 2。可打开原尺寸图片放大阅读。
沿右列向下,特征图高宽逐阶段缩小,通道数从 64 增加到 128、256、512。以 224×224 输入为例,7×7、stride 2、padding 3 的首层输出 112×112;3×3、stride 2、padding 1 的池化得到 56×56,后续三个降采样阶段得到 28,14,7 的高宽。末尾平均池化与全连接层把空间特征变成类别分数。
论文在卷积后、激活前使用 BatchNorm,训练时还维护其运行统计量。图中的弧线把块输入送到更深处相加;通道或空间尺寸改变时要处理短接分支的形状。相加公式、投影参数量以及归一化状态在堆叠、残差与融合中继续计算。
卷积的共享权重使同一种局部运算能在不同位置重复。无边界影响、stride 1 等条件下,它具有平移等变性:输入移动,特征图也相应移动。池化、下采样与最终汇总会改变这种关系,分类器能否适应实际平移仍需在数据上检验。
