
如果只用几百张新任务图片从随机参数开始训练,模型既要学习边缘和纹理,也要学习类别区别。预训练先在另一批数据和目标上学习参数,再把这些参数作为新任务的起点。微调决定哪些参数继续更新,以及用什么数据和损失更新。
预训练
从头训练通常随机初始化参数 ,再在目标数据 上优化。预训练先求得 ,随后以它初始化目标模型。两阶段可以使用相同结构和不同输出头,也可以继续使用原输出头。
监督预训练使用人工或已有系统提供的标签,例如让视觉编码器学习大规模图像分类。自监督预训练从样本本身构造预测目标,例如遮住文本的一部分并预测它,或用前缀预测下一 token。无人工任务标签仍然可以产生明确的训练目标,前向、计算损失、反传和更新的程序依然存在。
BERT 使用遮蔽语言建模等目标预训练双向 Transformer,再针对下游任务微调。遮蔽位置可以利用左右上下文;自回归模型在预测下一 token 时只能读取前缀。两者的注意力掩码和标签位置不同。BERT 原论文 §3给出了预训练与微调的连接方式。
以自回归训练为例,某条完整序列是 [BOS, 我, 爱, 学习, EOS]。输入可取前四项,目标取后四项。若批次大小为 2、有效长度为 4、词表大小为 10,000,输入 ID 的形状为 ,网络输出 logits 为 ,目标为 。其损失为
标记有效目标位置, 是计入损失的 token 数。某些模型接口会在内部移动 labels;使用这样的接口时传完整标签,不能又在外部移动一次。实现前应查看该模型 forward 的标签约定,并用一条短序列核对。
预训练留下的不只有权重文件,还有分词器、词表、特殊 token、输入归一化和结构配置。替换其中任何一项都可能改变权重接收到的输入含义。实验记录应保存检查点标识、版本与这些配套文件。
冻结与微调
把网络写成 、。 是编码器, 是任务头。比如输入 ,视觉编码器输出 ;新任务有 5 类,线性头参数为 、,输出 logits 为 ,任务头共 个参数。
| 方式 | 本次更新的参数 | 用途与训练代价 |
|---|---|---|
| 冻结编码器,只训练线性头 | 直接检查预训练表示能否线性区分类别,可缓存固定特征 | |
| 解冻末端若干层 | 部分 与 | 让较高层表示适应新任务 |
| 全参数微调 | 全部 | 所有表示可调整,需要保存全部可训练参数的梯度和优化器状态 |
| LoRA 等参数高效微调 | 指定的新参数,通常另含任务头 | 限制更新的表示方式,减少可训练状态 |
冻结表示参数的 requires_grad=False。这与评估模式是两个设置:若要保持编码器的 BatchNorm 统计量及关闭 Dropout,还需将其设为 eval()。当冻结编码器只位于最前端,且不需要对其输入求导时,可以在 no_grad() 中提取特征;若冻结层夹在可训练层之间,仍需保留对输入的梯度路径。
下面的片段假设已经加载与任务匹配的 encoder,且它输出 。它展示“固定特征、训练新头”的实际操作,数据加载复用训练章:
for p in encoder.parameters():
    p.requires_grad_(False)
encoder.eval()
head = torch.nn.Linear(768, 5)
optimizer = torch.optim.AdamW(head.parameters(), lr=1e-3)

head.train()
for images, labels in train_loader:
    with torch.no_grad():
        features = encoder(images)
    logits = head(features)
    loss = torch.nn.functional.cross_entropy(logits, labels)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
全参微调时恢复编码器梯度,移除该 no_grad(),并把编码器参数加入优化器。可给编码器较小学习率、随机初始化的任务头较大学习率,然后用验证数据选择。若分阶段解冻,新增参数也必须进入优化器;重新创建优化器会重置原有矩估计,应作为明确的训练设置记录。PyTorch 迁移学习教程展示了冻结与全参更新两种流程。
低秩适配(LoRA)
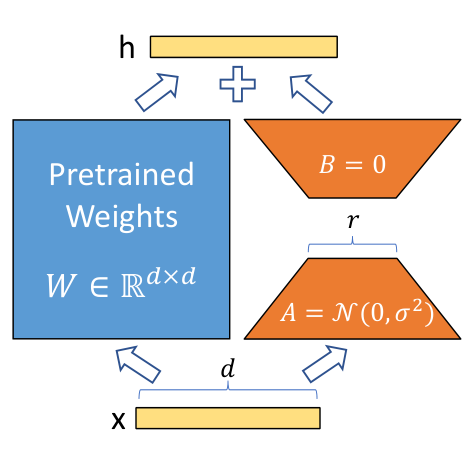
图 1:Hu 等,2021,LoRA Figure 1,裁去周围正文。蓝色为冻结权重,橙色为可训练分支。
考虑线性层 。,。LoRA 冻结 ,学习
是选定的秩上限,通常远小于输入输出宽度; 控制更新缩放。 先得到 维向量, 再把它映射回输出宽度。 的秩至多为 ,因此用较少参数表达一个受约束的权重更新。
若 ,原矩阵有 个参数,LoRA 分支有 个,是该原矩阵参数量的 。此计算只比较这一矩阵的可训练权重;原始权重仍要存储,激活和其他可训练模块也需要显存。
再用二维算一遍:,,,,取 。有 ,,输出为 。更新矩阵为
其两行成比例,秩为 1。合并成 后,再计算 会得到相同输出。这个等价关系适用于普通线性权重与关闭的 LoRA Dropout;量化或重新量化后的误差还需单独检查。
原论文采用随机初始化 、零初始化 ,使初始增量为零。此时第一步 的梯度因 为零, 通常可得到非零梯度;更新 后,两者都能学习。原论文 §4.1给出了参数化与初始化方法。
下面是无 Dropout 的最小线性实现,保留并冻结传入层的已有偏置:
import math
import torch
from torch import nn

class LoRALinear(nn.Module):
    def __init__(self, base, rank=8, alpha=8):
        super().__init__()
        self.base = base
        self.base.requires_grad_(False)
        self.scale = alpha / rank
        self.A = nn.Parameter(base.weight.new_empty(rank, base.in_features))
        self.B = nn.Parameter(base.weight.new_zeros(base.out_features, rank))
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5))

    def forward(self, x):
        return self.base(x) + self.scale * (x @ self.A.T @ self.B.T)

layer = LoRALinear(nn.Linear(4, 3), rank=2, alpha=2)
x = torch.randn(5, 4)
assert layer(x).shape == (5, 3)
trainable = sum(p.numel() for p in layer.parameters() if p.requires_grad)
assert trainable == 2 * (4 + 3)
对 Transformer 进行 LoRA 微调时,要明确替换哪些线性层,例如注意力的 query、value 投影,并记录每层的 rank、缩放和 Dropout。冻结 仍需通过该层把梯度传到更早的可训练分支,因此不能简单把整个基础模型包进 no_grad()。反传只免去 的参数梯度及其优化器状态。
指令微调
监督指令微调把提示和参考回答组织为序列。比如 [用户问题, 分隔符, 助手回答, EOS],模型读取完整前缀,用下一 token 目标学习回答。有的设置只对助手回答及 EOS 计算损失,提示位置和 padding 的标签设为忽略值。这样输入上下文仍参与前向,但不要求模型在损失中复述用户问题。
需要分别处理两类掩码:因果注意力掩码决定当前位置可读哪些信息,标签掩码决定哪些预测计入损失。把提示位置从损失中排除,不等于从输入中删掉它们。多轮对话还要明确是否监督所有助手轮次,以及截断是否切掉问题或回答。训练前应解码几条实际 batch,同时打印哪些目标位置被忽略。
较长样本按 token 平均时权重更高;按序列平均时每条样本总权重接近。选定归约方式后,与梯度累积的有效 token 计数保持一致。生成评价还需固定解码温度、最大长度和停止条件,详见评价章。
微调实验
- 固定目标任务、数据划分和指标,排查训练文本与测试题的重复。保留基础模型直接评估或只训练头的结果作为基线。
- 核对模型配置、输入预处理、标签映射和最大长度。检查实际 batch,而不只查看原始数据文件。
- 选择更新范围并打印可训练参数名、数量。先在几十条样本上确认损失可以下降,再扩大训练。
- 使用相同验证集比较学习率、更新步数、冻结范围或 LoRA rank。保存验证最优检查点和完整设置。
- 在目标任务上评价,并用原任务或通用能力子集检查遗忘。目标任务分数提高而旧任务退步时,记录这项取舍,可再比较较小学习率、较少更新或混合数据。
- 方案确定后做最终测试。LoRA 交付包含适配器权重、对应基础模型版本和配置;更换基础模型会改变适配器叠加的对象。
预训练是否有帮助要由同一评估协议下的比较判断。数据领域接近、目标一致和足够的目标样本,都可能影响适合的更新范围。比较从头训练、冻结、全参和 LoRA 时,应同时记录数据量、可训练参数量、训练预算与推理成本。