
一个分类网络接收输入张量,输出每个类别的分数。训练要让这些分数逐渐符合标签,还要检验模型能否处理没有参与训练的数据。
数据集划分
设数据集为 。 是样本数, 是输入, 是监督标签。划分的基本单位应与实际部署的新对象一致。
| 子集 | 在训练过程中的用途 | 会影响什么 |
|---|---|---|
| 训练集 | 计算损失和梯度,拟合预处理统计量 | 网络权重、偏置,以及均值等统计量 |
| 验证集 | 比较超参数、选择检查点与决策阈值 | 采用哪个模型、在哪一轮停止 |
| 测试集 | 在方案确定后评估一次 | 本次实验最终报告 |
例如有 1,000 名用户,每人 10 条记录,要预测新用户的类别,就应按用户划分。若随机拆分 10,000 行,同一用户的记录可能出现在训练和测试两边,模型利用个人习惯就能取得偏高的成绩。预测未来销量则按时间划分,训练日期早于验证、测试日期,并检查滑动窗口是否跨越边界。独立图片的分类任务可按类别分层抽样,让各子集保留近似的类别比例。分组、时间切分与交叉验证的适用条件见 scikit-learn 数据划分文档。
数据泄漏是评估阶段才应获得的信息提前参与了训练或选择。除了重复样本,还包括用全体数据拟合归一化、根据测试成绩选模型、把拍摄时间后的信息作为预测输入。先保存样本 ID 的划分清单,再在训练子集上拟合所有有统计量的变换。这样同一清单可以用于不同模型的公平比较。官方泄漏示例展示了为何特征选择和预处理也必须遵守这一边界。
预处理与批次
对数值特征 ,用训练集的均值 和标准差 做标准化:
是样本下标, 是特征下标, 防止常数列除零。若训练列为 ,采用总体标准差,则 、;验证样本 转换为 。验证值不参与重新计算均值。缺失值填补、词表构造、特征筛选也要明确其拟合数据;使用预训练模型时,输入缩放与分词器应遵循该检查点的约定。
batch 是一次并行送入网络的样本集合。若有 个样本,每个样本 4 个浮点特征,则 。三分类标签 使用整数类型;网络给出 ,每行是三个 logits。图像可组成 ;文本通常先补齐为 的 token ID,并另存有效位置掩码。补齐位置既可能需要在注意力中屏蔽,也需要在损失中忽略。
一次 epoch 表示遍历一轮训练数据;一次 optimizer step 表示更新一次参数。训练集有 600 个样本,batch size 为 32,保留最后不足一批的样本时,每轮有 次更新,最后一批有 24 个样本。使用梯度累积后,两者不再一一对应。
训练时打乱独立样本能减少固定顺序对连续更新的影响。验证和测试无需打乱。序列任务则要保留样本内部的时间关系;若跨 batch 延续循环状态,还必须同步处理顺序与状态重置。
数据增强
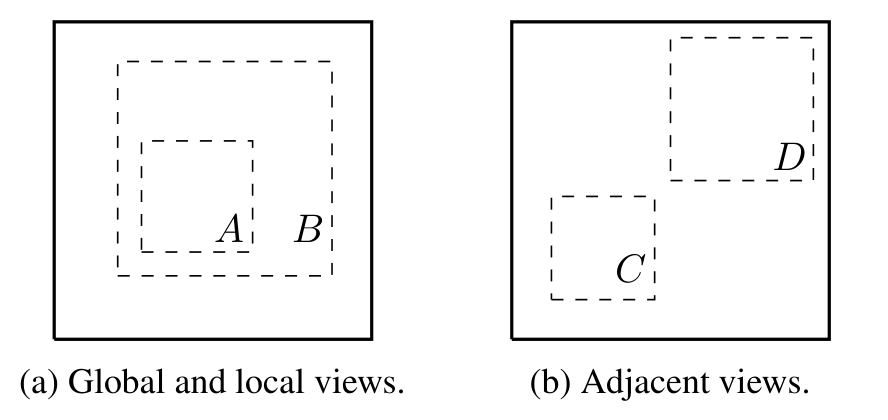
图 1:Chen 等,2020,SimCLR Figure 3,裁去周围正文。实线框是图像,虚线框是不同裁剪区域。
随机裁剪改变了模型能看到的区域,颜色扰动改变了外观。监督分类中,变换后的标签必须仍然成立:裁掉唯一目标后,原标签可能已经失效;把数字 6 旋转成近似 9,也不能直接保留原标签。分割和检测还要同步变换掩码或框坐标。
自监督训练可把同一原图的两次增强定义为正样本对。图中局部与整体的对应关系因此成为学习信号,具体损失见对比学习。训练数据增强采用随机变换,普通验证采用固定预处理,便于比较相邻轮次。测试时增强若被采用,需要事先固定组合方法,并计入推理成本。
分类训练示例
下面在 CPU 上生成 1,000 个四维样本,用已知线性规则产生三类标签。这个例子用于检查训练链路;实际项目应替换数据读取部分,并依据对象或时间重新设计切分。
模型为 的 MLP。第一层参数形状为 和 ,第二层为 和 ,共 个可训练标量。隐藏激活为 ,经 ReLU 后输出 。分类损失把该批输出和整数标签汇总成标量,反传为每个参数计算同形状的梯度。
import copy
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(7)
torch.set_num_threads(1)
x = torch.randn(1000, 4)
teacher = torch.tensor([[1., -1., 0., .5],
                        [-.5, 1., 1., 0.],
                        [0., 0., -1., -1.]])
y = (x @ teacher.T).argmax(dim=1)
ids = torch.randperm(len(x))
train_ids, val_ids, test_ids = ids[:600], ids[600:800], ids[800:]
mean = x[train_ids].mean(dim=0)
std = x[train_ids].std(dim=0, unbiased=False).clamp_min(1e-6)
x = (x - mean) / std

def loader(indices, shuffle=False):
    return DataLoader(TensorDataset(x[indices], y[indices]),
                      batch_size=32, shuffle=shuffle)

train_loader = loader(train_ids, shuffle=True)
val_loader = loader(val_ids)
test_loader = loader(test_ids)
model = nn.Sequential(nn.Linear(4, 16), nn.ReLU(), nn.Linear(16, 3))
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=0.01,
                             weight_decay=0.001)

@torch.no_grad()
def evaluate(batches):
    model.eval()
    loss_sum, correct, count = 0., 0, 0
    for xb, yb in batches:
        logits = model(xb)
        loss_sum += loss_fn(logits, yb).item() * len(yb)
        correct += (logits.argmax(dim=1) == yb).sum().item()
        count += len(yb)
    return loss_sum / count, correct / count

best_loss, best_state, stale = float('inf'), None, 0
for epoch in range(100):
    model.train()
    for xb, yb in train_loader:
        optimizer.zero_grad(set_to_none=True)
        logits = model(xb)
        loss = loss_fn(logits, yb)
        loss.backward()
        optimizer.step()
    val_loss, val_acc = evaluate(val_loader)
    if val_loss < best_loss - 1e-4:
        best_loss = val_loss
        best_state = copy.deepcopy(model.state_dict())
        stale = 0
    else:
        stale += 1
    if stale >= 10:
        break

model.load_state_dict(best_state)
test_loss, test_acc = evaluate(test_loader)
print(f'test loss={test_loss:.4f}, accuracy={test_acc:.3f}')
zero_grad 清除上一步留下的梯度;前向计算建立求导图;backward 沿图累计梯度;step 使用梯度及优化器状态更新参数。调用 backward 后,权重本身还没有变化。这个顺序与 PyTorch 训练教程一致。
最后一批较小,所以验证损失先乘实际样本数,再除总数。直接平均各批的平均损失,会给较小的最后一批过大的权重。若序列损失按有效 token 平均,累加的权重也应改为有效 token 数。
参数与训练状态
训练的持久状态包含权重和偏置、Adam 的一阶与二阶矩估计,以及某些层的缓冲区。BatchNorm 的运行均值和方差属于缓冲区,不由梯度更新。前向激活通常只为当前反传暂存;RNN 的隐藏状态是否跨批保留由任务决定。
model.train() 与 model.eval() 切换 Dropout、BatchNorm 等层的行为;torch.no_grad() 控制是否记录求导运算。二者负责不同事情,验证时通常同时使用。即使全部参数被冻结,处于训练模式的 BatchNorm 仍可能更新运行统计量。Autograd 文档说明了模式与梯度记录的区别。
保存推理模型时至少保存模型状态、模型配置、标签映射和预处理统计量。恢复训练还需要优化器、调度器、当前步数、混合精度缩放器及相关随机数状态;这些信息决定后续更新是否能衔接。仅保存 model.state_dict() 足以用于本例的最佳检查点评估,但不能完整恢复被中断的 Adam 训练。
早停与测试
例子预先规定最多 100 轮;验证损失至少下降 才算改善,连续 10 轮未改善就早停。每次改善时深拷贝权重,最后恢复最佳版本。若只保存 best_state = model.state_dict(),其中张量可能继续随训练改变,无法保留那一轮的模型。
原树中 End?的 N 分支对应继续取批次和更新,Y 分支对应停止训练并评价。停止规则可以是固定更新预算、验证早停或达到预设目标;不能根据测试集成绩决定继续多久。验证集已经参与模型选择,因此最终成绩使用一直保留的测试集。
运行前先检查一批样本的数值范围、标签及形状,再让模型拟合几十个样本。若小样本训练损失也降不下去,逐项检查标签匹配、参数是否进入优化器、梯度是否为零、学习率是否过大。链路跑通后,记录训练和验证曲线、实际更新次数及耗时。如何从这些记录判断欠拟合、过拟合和分布变化,见评价与泛化。