网络输出一组数字,损失函数规定这些数字怎样才算接近目标。预测温度时,误差 2 度和 20 度应有不同代价;判断邮件是否为垃圾邮件时,需要评价模型分给正确类别的概率。损失把任务要求写成可优化的标量,再由反向传播计算参数的修改方向。
记 B 为批次大小,θ 为全部可训练参数,y^=fθ(x) 为模型预测。一个 batch 的常见目标为
L(θ)=B1i=1∑Bℓ(fθ(xi),yi).
ℓ 是单样本损失,L 是批次平均损失。若另加正则项,要写明其系数和是否随 batch 大小缩放。
输出与标签
| 任务 |
网络输出 |
标签 |
常用损失 |
| 每个样本预测 D 个实数 |
[B,D] 实数 |
[B,D] 浮点数 |
MSE、MAE |
| 二分类 |
[B] 或 [B,1] logits |
完全同形状的 0/1 浮点数 |
BCE with logits |
| C 类单标签分类 |
[B,C] logits |
[B] 整数类别 ID |
交叉熵 |
| C 个可同时成立的标签 |
[B,C] logits |
[B,C] 的 0/1 浮点数 |
逐标签 BCE |
| 自回归 token 预测 |
[B,T,V] logits |
[B,T] 的 token ID |
对有效位置求交叉熵 |
logit 是归一化前的分数,可以为负,也不要求和为 1。多类单标签的 softmax 让类别竞争总和为 1 的概率;多标签的 sigmoid 分别判断每个标签,一张图可以同时有“猫”和“室内”。
PyTorch 的 CrossEntropyLoss 对类别 ID 模式要求输入 logits 和整数标签,内部完成 log-softmax。把 softmax 概率再传进去会改变目标。二分类可直接使用 BCEWithLogitsLoss,省去单独计算 sigmoid 和取对数的数值不稳定。交叉熵接口、BCE 接口给出了形状与类型约定。
均方误差与高斯似然
对 B 个样本、每个 D 个输出,按全部元素平均的均方误差为
LMSE=BD1i=1∑Bj=1∑D(y^ij−yij)2,∂y^ij∂L=BD2(y^ij−yij).
例如两个标量预测为 [2,4],标签为 [1,2],则 L=(12+22)/2=2.5,对预测的梯度为 [1,2]。平方使大误差占更高权重;MAE 使用 ∣y^−y∣,对远离零点的残差给出大小相同的局部梯度。带离群标签的数据可据任务代价比较 MAE、MSE 或在两者之间过渡的 Huber 损失。
MSE 也对应一个概率假设:给定 x,标签由均值 fθ(x)、固定方差 σ2 的高斯分布产生。单个标量标签的负对数似然为
−logpθ(y∣x)=2σ2(y−fθ(x))2+21log(2πσ2).
固定 σ 时,第二项与 θ 无关,最小化该目标与最小化平方误差得到相同的最优参数。若同时学习 σ,就必须保留对数项,否则模型可以单纯扩大方差来降低第一项。概率建模与损失的关系可参见 Deep Learning 第 5 章的最大似然部分。
回归尺度也会影响训练:同样的物理误差,以厘米表示会比以米表示产生大 104 倍的平方误差。多个输出采用不同单位时,可标准化目标,或按任务代价明确指定权重,并在报告指标时还原单位。
二元交叉熵
给一个 logit z∈R,sigmoid 输出正类概率
p=σ(z)=1+e−z1,ℓBCE=−ylogp−(1−y)log(1−p).
y∈{0,1}。当 y=1 时损失为 −logp;当 y=0 时为 −log(1−p)。若 p=0.8,y=1,损失约 0.2231;若以同样的概率预测错了,即 p=0.8,y=0,损失约 1.6094。本章对数均为自然对数。
将 sigmoid 代入并整理,可得
ℓ(z,y)=max(z,0)−zy+log(1+e−∣z∣),∂z∂ℓ=σ(z)−y.
稳定形式避免直接计算极大指数或对接近零的概率取对数。对上例 p=0.8,y=1,z=log4,梯度为 −0.2;梯度下降会增大 z,从而提高正类概率。
正类稀少时可改变采样或使用正类权重,但这会改变优化目标及概率解释。训练后的阈值应在验证集上按漏报、误报代价选择,不能把加权损失变小直接解释成所有评价指标都变好。
多类交叉熵与似然
单样本的 logits 是 z∈RC,softmax 概率为
pc=∑k=1Cezkezc,ℓ=−logpy=−zy+logk=1∑Cezk.
C 是类别数,y 是正确类别的下标。实现时令 m=maxkzk,把末项写成 m+log∑kezk−m,减小溢出风险。比如 z=[log2,0,0],概率为 [0.5,0.25,0.25];若正确类为第一类,损失为 log2≈0.6931。
用 one-hot 向量 q 表示标签,交叉熵为 −∑cqclogpc。其对每个 logit 的梯度是
∂zc∂ℓ=pc−qc.
上例梯度为 [−0.5,0.25,0.25],既提高正确类分数,也降低其余类的相对分数。对 batch 平均时,再除以 B。softmax 对所有 logits 同加一个常数不变,这也解释了该梯度的分量之和为零。
条件独立样本的似然为 ∏ipθ(yi∣xi)。取负对数,把连乘转为各样本交叉熵之和,因此监督分类的交叉熵训练就是这一模型下的最大似然估计。
标签平滑可用 qc=(1−ϵ)1[c=y]+ϵ/C,其中 ϵ∈[0,1]。它把一部分概率分给其他类别,改变模型受到的训练信号。评价时仍应按真实任务标签计算正确率;平滑系数属于验证集选择的超参数。
序列长度与损失归约
语言模型输出 [B,T,V],T 是序列长度,V 是词表大小。每个位置用 V 个 logits 预测下一个 token。可把 logits 展平为 [BT,V]、标签展平为 [BT],忽略 padding 后再平均。若有效 token 数为 M,目标是 L=M−1∑i,tmitℓit,其中 mit∈{0,1} 表示该位置是否计入损失。
“先对每条序列平均,再对序列平均”和“对所有有效 token 平均”给长短序列的权重不同。梯度累积、分布式汇总和验证报告必须使用相同的分母约定。对于分割任务,类别维在 PyTorch 中通常位于第 2 维,即输入 [B,C,H,W],目标 [B,H,W];不能直接套用语言模型最后一维为类别的布局。
KL 散度
令 q 为目标分布,p 为模型分布,两者定义在同一组离散事件上。KL 散度为
DKL(q∥p)=c∑qclogpcqc=H(q,p)−H(q),
其中 H(q,p)=−∑cqclogpc 为交叉熵,H(q)=−∑cqclogqc 为目标自身的熵。q 固定时,最小化交叉熵与最小化这个方向的 KL 对 p 有相同梯度。若 q=[1,0,0],H(q)=0,便得到普通分类损失。
KL 一般不对称。例如 q=[0.5,0.5]、p=[0.75,0.25],有 DKL(q∥p)≈0.1438,反向约 0.1308。若 qc>0 而 pc=0,前向 KL 为无穷大。零概率项按 0log0=0 的极限处理。
知识蒸馏可把教师的类别分布作为 q,训练学生的 p;生成模型中的 VAE 则有后验与先验之间的 KL 项。调用 PyTorch KLDivLoss 时,默认 input 接收 logp,target 接收 q;reduction='batchmean' 先对事件维求和再按 batch 平均,和把所有元素求平均的 mean 尺度不同。官方接口说明明确列出了这一约定。
对比损失
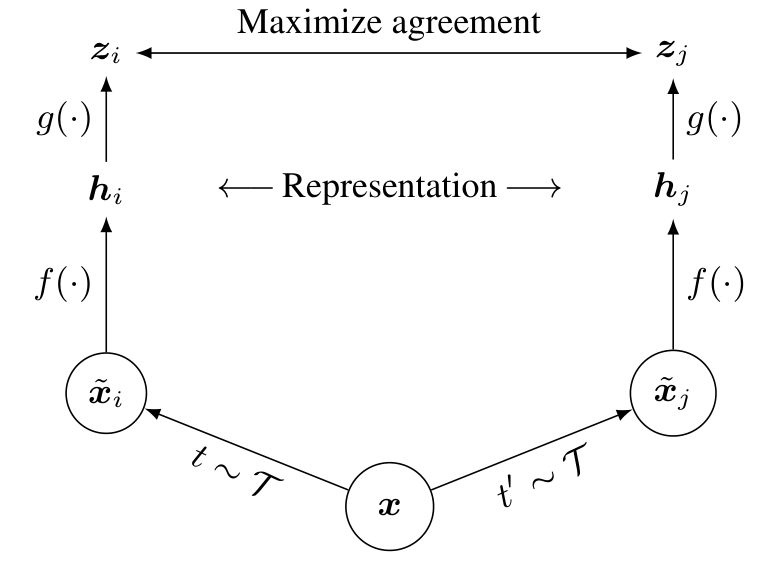
图 1:Chen 等,2020,SimCLR Figure 2,裁去周围正文。f 是编码器,g 是投影头,h 与 z 分别是两者的输出。
取 N 张原图,每张生成两种增强,得到 2N 个视图。编码器和投影头给出 Z∈R2N×d,d 是投影维度。同一原图的两个视图形成正样本对 (i,j)。以 i 为锚点时,它需要从其余 2N−1 个视图中找出 j。
ℓi,j=−log∑k=iexp(s(zi,zk)/τ)exp(s(zi,zj)/τ),s(u,v)=∥u∥2∥v∥2u⊤v.
s 是余弦相似度,τ>0 是温度。分母包含正样本,排除锚点自己。实现可先归一化各行,再计算 ZZ⊤/τ 得到 [2N,2N] 分数矩阵,屏蔽对角线,指定每行的正样本下标后做交叉熵。
举一个三候选的手算例:正样本相似度为 1,两个负样本均为 0,τ=0.5。正样本概率为 e2/(e2+2)≈0.7870,损失约 0.2395。较低温度会放大候选间的分数差,也会改变梯度大小。
SimCLR 对全部 2N 个锚点平均,两条增强分支共享参数,梯度共同更新编码器与投影头。正样本定义依赖增强是否保留所需语义;不同原图也可能属于同一语义类别,把它们视作负样本会引入冲突。因此损失公式还需要与采样规则一起理解。原论文 §2 与 §5给出了目标和相关实验。
损失计算示例
import torch
import torch.nn.functional as F
pred = torch.tensor([2., 4.])
truth = torch.tensor([1., 2.])
print(F.mse_loss(pred, truth).item())
z = torch.log(torch.tensor([[2., 1., 1.]], dtype=torch.float64))
z.requires_grad_()
loss = F.cross_entropy(z, torch.tensor([0]))
loss.backward()
print(loss.item())
print(z.grad)
logit = torch.tensor([4.]).log()
print(F.binary_cross_entropy_with_logits(logit, torch.ones(1)).item())
运行真实训练前,先打印一次输出形状、标签类型、有效样本数和损失值。随机初始化的均匀 C 类预测,交叉熵应接近 logC;这能帮助发现类别数或归约方式错误。损失用于更新参数,任务表现还要用评价指标检查,例如交叉熵降低时分类阈值下的 F1 未必同步提高。
