上一章已经把一批输入写成 X∈RB×d。现在要让每条记录产生预测:先用一组权重组合输入,再用非线性改变响应方式,多次重复后得到输出。这个结构就是多层感知机,简称 MLP。
仿射变换
设输入有 d 个特征,单个神经元先算
a=i=1∑dwixi+b.
xi 是输入的第 i 个值,wi 是对应权重,b 是偏置,a 是加权结果。权重控制各特征的贡献,偏置让响应阈值能够平移。若 x=(2,−1)、w=(3,4)、b=0.5,则 a=6−4+0.5=2.5。
同时计算 m 个神经元,就得到一个全连接层:每个输出都连接全部 d 个输入。本文统一采用“每条样本占一行”的记法:
A=XW+b,X∈RB×d,W∈Rd×m,b∈Rm,A∈RB×m.
矩阵乘法要求中间维度 d 相同;每个输出 An,j=∑iXn,iWi,j+bj,其中 n 是 batch 内样本下标,j 是输出坐标。偏置沿 batch 轴广播。参数量为 dm+m,增加 batch 大小只增加同时计算的样本数。
严格说,带偏置的运算是仿射变换,b=0 时才是线性变换。深度学习库通常仍将这一模块命名为 Linear。PyTorch 保存的 weight 形状是 (m,d),实际算 X @ weight.T + bias;和本文的 W 互为转置。Linear 文档同时列出了权重与输入输出形状。
激活函数
若接连使用两个仿射层而不插入激活,结果为
(XW1+b1)W2+b2=X(W1W2)+(b1W2+b2).
两个层可以合并成一个,增加深度没有改变这类函数的形式。非线性激活逐元素作用于 A,使网络能够根据输入所在区域采用不同的响应。
常用 ReLU 为 ReLU(a)=max(0,a)。例如 (−2,0.5,3) 经 ReLU 后变成 (0,0.5,3)。在固定的正负激活模式内,带 ReLU 的 MLP 是仿射函数;跨过某个神经元的零点时,组合方式改变,因此整个网络可以形成分段线性的边界。ReLU 在正半轴导数为 1、负半轴为 0;实现会在零点选一个约定的次梯度,PyTorch 取 0。
其他常见激活有
σ(a)=1+e−a1,tanh(a)=ea+e−aea−e−a.
sigmoid 的输出在 (0,1),可表示二元概率或门控系数;tanh 在 (−1,1),可用于有正负号的状态。它们在大绝对值输入处趋于饱和,导数变小。隐藏层激活和输出层的选择由计算目的决定:回归头常直接输出实数,分类头输出 logits 后交给损失函数。可对照 PyTorch 的 ReLU、Sigmoid 与 Tanh定义。
一个具体的非线性能力例子是 XOR。输入 (x1,x2) 限于 {0,1}2,定义
h1h2o=ReLU(x1+x2),=ReLU(x1+x2−1),=h1−2h2.
四种输入 (0,0),(0,1),(1,0),(1,1) 分别得到 o=0,1,1,0。单个仿射函数若在前三点输出 0,1,1,就被迫在最后一点输出 2;这个两隐藏单元的网络则通过 ReLU 的折点完成了所需映射。
多层感知机(MLP)
设第 l 层输入宽度为 dl−1、输出宽度为 dl:
H(0)=X,H(l)=ϕl(H(l−1)Wl+bl).
H(l)∈RB×dl 是第 l 层激活,Wl∈Rdl−1×dl、bl∈Rdl 是该层参数,ϕl 是逐元素激活或输出所需的恒等映射。隐藏层夹在输入和任务输出之间,通常没有逐单元的人为标签;它的值由最终损失通过反传约束。
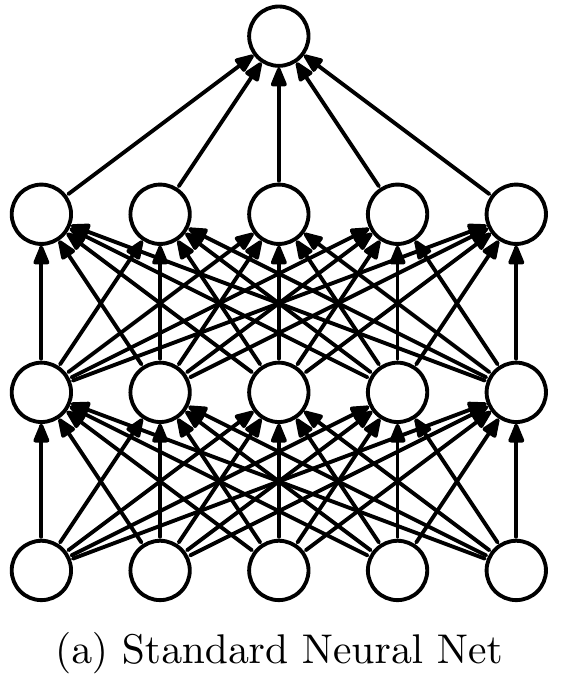
图 1:摘自 Srivastava 等,Dropout,2014,图 1(a),只裁取左侧标准网络。圆点表示单元,连线表示层间权重;从底向上是输入、两个隐藏层与输出。原图右侧的随机删单元机制在评价与泛化中讨论。
权重和偏置跨样本复用,中间激活随输入变化。一个普通前馈 MLP 不在两次独立样本调用之间保存循环状态。训练需要保留部分中间值以便求导;优化器还可能为每个参数保存动量等状态。这些数据的数量和网络参数量应分别计算。
前向传播计算示例
取一条输入 X=[1,2],网络宽度为 2→3→2。先算隐藏层:
W1=[10−1101],b1=[0,0,−3].
于是
A1H=XW1+b1=[1,1,−1],=ReLU(A1)=[1,1,0].
输出层取
W2=1−1201−1,b2=[0.5,−0.5].
得到两类 logits:
Zp=HW2+b2=[0.5,0.5],=softmax(Z)=[0.5,0.5].
若标签是类别 0,交叉熵为 −log0.5≈0.693147。第一层有 2×3+3=9 个参数,第二层有 3×2+2=8 个,总共 17 个。第三个隐藏单元在这条输入上为 0,但其输入权重仍属于模型参数,并可能在别的样本上参与计算。
参数更新
对单样本 softmax 交叉熵,输出分数的梯度是 p−yonehot。本例标签的 one-hot 为 [1,0],因此 ∂ℓ/∂Z=[−0.5,0.5]。根据矩阵乘法的求导规则,
∂W2∂ℓ=H⊤[−0.5,0.5]=−0.5−0.500.50.50.
沿第一层继续传播,得到 ∂ℓ/∂A1=[−0.5,1,0],其中第三项被 ReLU 的零导数截断。使用学习率 η=0.1 的 SGD,对全部权重和偏置作 θ←θ−η∇θℓ 后,再算同一输入,logits 约为 [1.535,−0.235],类别 0 概率约为 0.85446,损失约为 0.15729。
下面代码固定了参数,可以复现上述结果。
import torch
from torch import nn
net = nn.Sequential(nn.Linear(2, 3), nn.ReLU(), nn.Linear(3, 2))
with torch.no_grad():
net[0].weight.copy_(torch.tensor([[1., 0.], [-1., 1.], [0., 1.]]))
net[0].bias.copy_(torch.tensor([0., 0., -3.]))
net[2].weight.copy_(torch.tensor([[1., -1., 2.], [0., 1., -1.]]))
net[2].bias.copy_(torch.tensor([.5, -.5]))
x = torch.tensor([[1., 2.]])
y = torch.tensor([0], dtype=torch.long)
optimizer = torch.optim.SGD(net.parameters(), lr=0.1)
optimizer.zero_grad()
logits = net(x)
loss = nn.functional.cross_entropy(logits, y)
loss.backward()
optimizer.step()
print(logits.detach(), loss.item())
print(net(x).detach())
assert sum(p.numel() for p in net.parameters()) == 17
cross_entropy 直接接收 logits,内部组合了对数归一化与负对数似然,因此训练代码没有先调 softmax;输入格式见官方文档。预测时可以取 logits.argmax(-1),它与 softmax 后选最大概率得到相同类别。
实际训练通常随机初始化不同单元的权重,以打破它们完全相同的响应。批量训练将损失在样本轴上归约,再对同一组参数累积梯度。增加层宽会提高参数量与计算量;对于图像,直接把每个像素连到所有隐藏单元开销很大。例如 3072→128 的第一层已有 393344 个参数。卷积网络通过局部连接与共享权重处理这种空间输入。
