
模型接收数值。照片需要展开颜色和位置,文本需要分词并映射为编号,表格需要约定每一列的含义。表示方式决定哪些关系容易被下一层使用:图像保留空间轴后,卷积可以在邻域内操作;词编号经过嵌入后,线性层可以组合多个连续特征。
张量与轴
这里的张量指多维数值数组。标量有零根轴,向量有一根轴,矩阵有两根轴;数组的 shape 按顺序列出每根轴的长度。例如 表示 条样本、每条 个实数特征。 表示实数域,实际程序使用有限精度浮点数。
| 对象 | 形状 | 下标的含义 |
|---|---|---|
| 一条三特征记录 | 是第 个特征 | |
| 两条三特征记录 | 是第 条记录的第 个特征 | |
| 一批 RGB 图像 | 样本、颜色通道、行、列 | |
| 一批等长 token 编号 | 样本、序列位置 | |
| token 的连续表示 | 样本、位置、嵌入坐标 |
程序的数组下标通常从零开始。数学式若从一开始计数,会明确写出求和上下限。batch 轴用于并行计算多个样本,一般不参与单样本的特征含义。(3,)、(1,3)、(3,1) 的轴数或轴长不同,后续矩阵乘法与广播的结果也会不同。
比如 为 ,偏置 为长度 的向量, 表示对每一行加同一个偏置。广播让代码省去复制操作;轴排列必须使偏置对应预期的特征维。PyTorch 的广播规则从末尾维度开始比较,各轴长度需相同或其中之一为 1。
表格特征
假设每条记录含“房间面积、室温、是否开空调”,一条输入可写为 。这里三个坐标的单位不同。对连续特征常使用训练集均值 和标准差 做标准化:
若面积的训练均值为 、标准差为 ,则面积 变为 。统计量在训练集上计算并保存,验证和预测时复用。标准差为零的列需要删除或单独约定处理,缺失值也要有明确的填补和缺失标记策略。操作流程见数据与训练。
类别编号通常只是索引。把“红、绿、蓝”写成 并直接作为一个数,会把顺序和间隔带入模型;可以改用 one-hot,分别写成 ,或者使用可学习嵌入。
图像表示
一张 的 RGB 图像包含 个数。按照 PyTorch 二维卷积的约定,一批 8 张图像形状为 ,也称 NCHW。某些图像读取库给出 HWC,即 ,进入网络前要调整轴顺序。Conv2d 文档明确给出了输入的通道位置。
8 位像素位于 到 ,转为浮点再除以 后, 分别成为 左右。还可以按通道继续做标准化,使用的均值、标准差与预训练模型约定一致。
展平操作将每张图像变为长度 的向量,于是 变为 。数据值和固定的排列规则仍在,但全连接层不再通过轴直接表达空间邻域。卷积保留高宽轴,并在所有位置复用同一组局部权重。
reshape 重新分组线性排列的数据,permute 改变轴的对应关系。对于 [[1,2,3],[4,5,6]],转置结果是 [[1,4],[2,5],[3,6]],直接 reshape 成三行两列则是 [[1,2],[3,4],[5,6]]。把 HWC 改为 CHW 应使用轴置换;二者的具体 API分别表达不同操作。
词嵌入
tokenizer 把文本切为 token,token 可以是字、子词或其他片段。词表给每个 token 分配整数编号。设词表大小为 ,嵌入维度为 ,嵌入表是参数矩阵
是位置 的 token ID, 表示取第 行,结果 是 维向量。若用 one-hot 行向量 表示编号,也可写为 ;实际实现直接查表,省去构造巨大 one-hot 的工作。Embedding 官方文档给出的输出形状就是在索引张量后追加一个嵌入维。
用一个教学词表:[PAD]=0,我=1,爱=2,猫=3,狗=4。设
“我 爱 猫”的 ID 是 ,查表得到
这里的数值只用于演示索引操作。训练从随机或已有嵌入开始,让任务损失经下游网络反传到查到的行。同一 token 在一个 batch 内出现多次时,其对应行累积这些位置的梯度。嵌入表参数量为 ;若 ,共有 个参数,FP32 权重本身占 字节,约 MiB,梯度和优化器状态需额外内存。
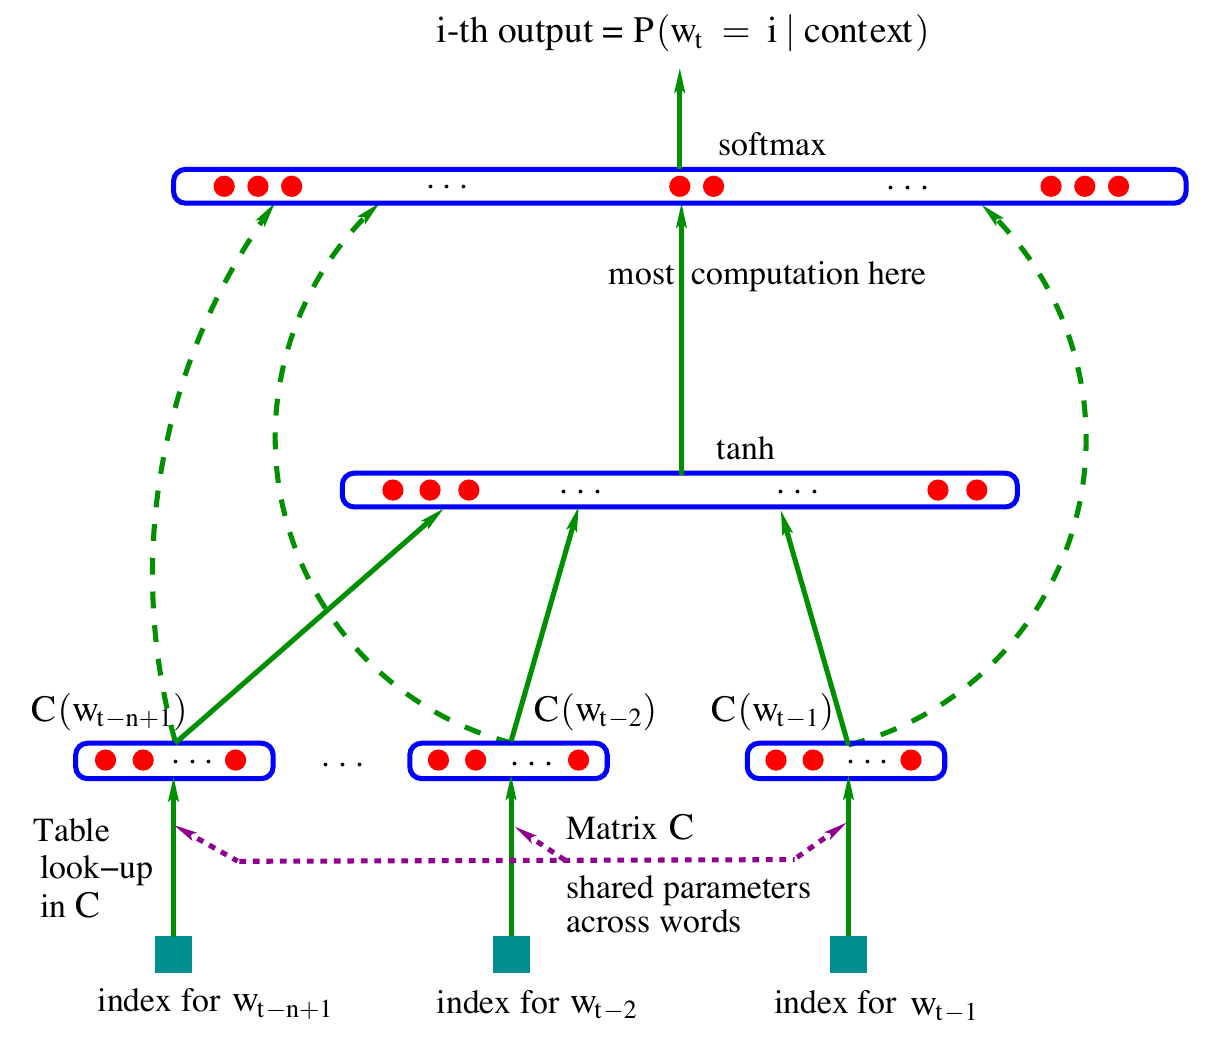
图 1:摘自 Bengio 等,A Neural Probabilistic Language Model,2003,图 1。从底部词编号向上读:查同一个表 ,拼接上下文向量,经隐藏层得到词表上的分布。原图的 对应本文嵌入表 ;它还画出了从嵌入直接连到输出的可选连接。
这个模型把词向量与下一词概率一起训练,说明嵌入本身就是网络参数。查表输出只依赖 token ID;在后续循环网络或注意力中,当前位置的表示还会结合其他位置,成为上下文相关的表示。
变长序列与填充
若两句文本 ID 分别为 和 ,可补齐为
的形状为 , 是同形状的有效位置标记,1 表示真实 token。嵌入后形状为 。若做带 mask 的平均池化,第 句的表示是
分母是实际长度,要求每句至少有一个有效 token。本例两句分别得到 与 。直接除以补齐长度 3 会把第二句的表示缩小。注意力 mask 和损失 mask 分别控制“哪些位置可被读取”和“哪些目标参与损失”,要传给各自运算。
平均池化会丢失词序。“猫 爱 我”和“我 爱 猫”拥有相同 token 集合,平均后完全相同。需要词序时,可使用按位置拼接、循环状态或带位置表示的 Transformer。
输出张量、分数与概率
logits 是未归一化的实数分数。对单标签 类分类,逐样本用 softmax:
是第 类的 logit, 且各类概率和为 1。取 ,减去最大值 2 后指数为 ,得到 。减同一常数不改变结果,可以避免大正数指数溢出。softmax 文档说明了归一化沿指定轴进行; 的分类输出应沿类别轴处理。
二元或多标签输出常逐元素用 sigmoid,。两个分数都为 0 时,两项概率都是 0.5;三个标签也可以同时得到 0.5,各项之和无需为 1。回归输出则可以直接是一组数,例如 表示二维位置。
分数的用途决定其解释:动作价值是预期回报,检索相似度用于排序,都可以作为数值输出。具体采用概率、实数还是结构化输出,应回到任务约定。
张量操作示例
import torch

images = torch.zeros(8, 32, 32, 3, dtype=torch.uint8)
x = images.permute(0, 3, 1, 2).float() / 255
assert x.shape == (8, 3, 32, 32)
assert x.flatten(1).shape == (8, 3072)

ids = torch.tensor([[1, 2, 3], [1, 2, 0]], dtype=torch.long)
E = torch.tensor([[0., 0., 0.], [1., 0., 1.], [0., 1., 1.],
                  [1., 1., 0.], [-1., 1., 0.]])
h = E[ids]
mask = ids.ne(0)
pooled = (h * mask[..., None]).sum(1) / mask.sum(1, keepdim=True)
print(h.shape)                       # torch.Size([2, 3, 3])
print(pooled)                        # 两行分别约为 [.6667,.6667,.6667]、[.5,.5,1.]
print(torch.softmax(torch.tensor([2., 1., 0.]), dim=-1))
代码中的 E 是固定演示数组;训练时用 nn.Embedding 将表注册为参数。mask[..., None] 给 mask 增加长度为 1 的最后一维,使它广播到每个嵌入坐标。线性层对最后一个特征轴进行运算。