
假设要给相册自动标记猫、狗和鸟。拿到照片后,模型输出三个类别的分数,再选分数最高的类别。若任务改成“给照片写一句描述”,输出就变成一串词;若任务改成“让摄像头跟随动物”,输出还要控制下一次观测的位置。同一张图像,可以对应不同的学习问题。
任务定义
用 表示一次预测的输入, 表示希望得到的结果。 和 分别是输入、输出的取值空间。模型记作 ,其中 是所有可学习参数,预测结果为 。帽子表示模型估计,方便与真实结果 区分。
相册分类的输入可以是一张 的 RGB 图像,输出类别编号 。实际网络通常先输出 ,再将分数转成概率。这里“照片”“浮点图像张量”“类别”“类别分数”各有位置:前两项是原始输入和计算表示,后两项是任务答案和模型的输出表示。
预测时的信息边界也属于任务定义。例如预测明天用电量,可以使用截至今天的负荷、日历和已发布天气预报。把明天实际温度放进输入,会让离线结果混入部署时拿不到的信息。按时间切分和避免泄漏的做法见数据与训练。
可以先写一份足够具体的任务约定:
| 项目 | 相册分类的教学设定 |
|---|---|
| 一条样本 | 一张只标注一个主类别的照片 |
| 可用输入 | 照片像素,不使用文件夹名中的类别文字 |
| 目标 | 猫、狗、鸟中的一个类别 |
| 训练信号 | 人工标注的类别编号 |
| 输出 | 三个 logits,推理时取最大值的位置 |
| 评价 | 未参与训练的照片上,预测类别与标注一致的比例 |
| 部署变化 | 夜景、模糊、不同相机的照片是否仍能识别 |
最后一项对应原树中的“新环境”。它要求评价数据覆盖预计遇到的变化,不能从训练误差直接推出结论。
输出类型
分类、回归、生成和决策分别约束输出的含义,但“预测”可以作为它们的上位描述。原树把这些词并列列出,写任务时应继续具体化。
| 任务 | 一个批次的典型输出 | 输出之后的操作 |
|---|---|---|
| 类单标签分类 | 个分数 | softmax 得到互斥类别概率,argmax 选类别 |
| 标签多标签分类 | 个分数 | 每列独立 sigmoid,再分别设阈值 |
| 个数的回归 | 按目标单位解释,例如温度或位置 | |
| 长度为 的文本建模 | 个分数 | 每个位置对 个 token 建立分布 |
| 图像语义分割 | 个分数 | 每个像素选择一个类别 |
| 离散动作决策 | 个策略分数或动作价值 | 从 个动作中采样或选择 |
是 batch 中的样本数, 是图像高宽, 是词表大小, 是动作数。任务可以同时包含多种输出,例如检测器既预测类别,又回归边界框。输出头和目标函数的匹配见损失函数。
生成模型需要描述输出分布。自回归文本生成按顺序使用
其中 是第 个 token, 是已经出现的前缀。训练时可从现成文本取前缀和下一个词,生成时从当前分布选出一个词再加入前缀。Bengio 等人的语言模型用有限长度上下文学习这样的条件概率;更多生成方法见生成模型。
监督学习
监督数据写成 , 是训练样本数。训练选择参数,使平均损失较小:
把预测和目标的差异变成一个标量; 表示寻找使目标最小的参数。实际优化通常通过许多小批次更新得到近似解。分类可用交叉熵,回归可用平方误差。这种输入、标签、损失的组织方式可参见作者维护的 Dive into Deep Learning 导论。
例如三分类模型对一张“狗”的照片输出概率 ,类别顺序是猫、狗、鸟。单样本交叉熵为
这里取自然对数。如果更新后“狗”的概率变成 ,该样本损失变为 。这个变化说明模型更符合这条标注;在其他照片上的效果要另测。
标签也可以来自已有记录或程序。例如以恒定规则计算出来的几何量为目标,仍能形成监督训练。区分学习范式时,需要看训练目标怎样产生以及数据怎样收集。
自监督学习
一段“今天 天气 很好”的文本可以构造出“今天”预测“天气”、“今天 天气”预测“很好”的训练对。目标来自原始序列,因而可以使用大量没有人工逐条标注的文本。遮住一部分图像再预测被遮住的部分,也使用了数据内部的监督信号。
另一种方法把同一张图像变换成两个视图。SimCLR 对图像 独立抽取两次随机变换,得到 和 。共享编码器 得到表示 ,投影网络 再产生用于对比损失的 。 分别是两部分的参数。
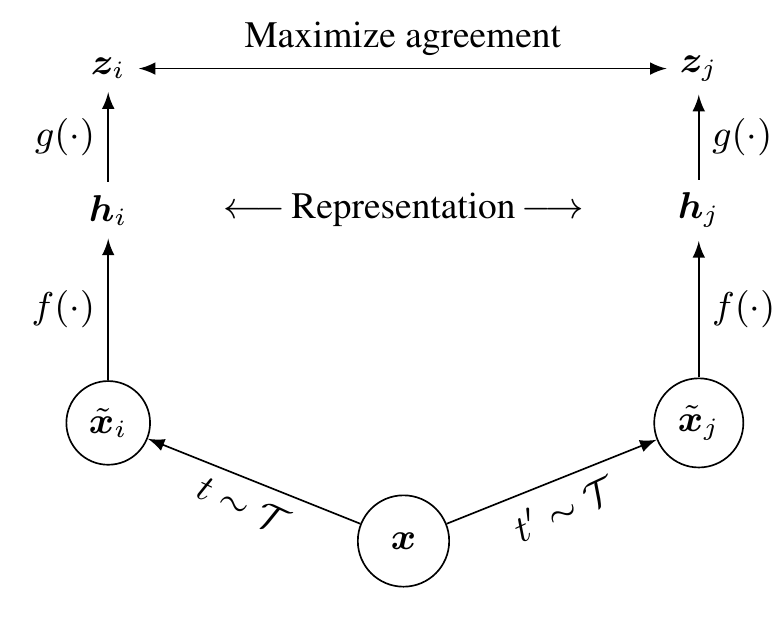
图 1:摘自 Chen 等,SimCLR,ICML 2020,图 2。保留原图,裁去周围正文。从底部输入沿两条分支向上看,两次增强生成的是同源视图, 和 在分支间共享参数。
设一个 batch 有两张原图,每张各增强两次,便得到四个视图。固定其中一个视图作为查询,另一个同源视图是正样本,来自另一张原图的两个视图是负样本。对比损失让模型在这些候选中找出同源视图。只有“让两条表示相同”的目标时,输出恒定向量就能满足要求;这里的候选竞争使不同原图也参与约束。SimCLR 训练后使用编码器表示 做下游任务,投影头 不参与其线性评价流程。论文第 2 节给出了采样、相似度与完整目标。
增强还规定了模型应忽略哪些变化:若类别依赖颜色,过强的颜色扰动可能删掉答案所需信息。训练目标来自数据,也仍要按任务选择。
无监督学习
没有外部标签的数据集可记为 。聚类希望找到样本分组,密度估计希望拟合 ,降维希望用较少坐标保留所需结构。每种目标都需要一个具体的准则。
以一维两簇聚类为例,样本为 。设簇中心为 ,分组变量 ,k-means 最小化
分为 和 时,中心分别是 ,平方误差总和为 。分组编号的语义需另行解释;换一下两个簇的编号,目标值不变。这个例子说明无监督学习也有可计算的目标,并且可以使用非神经网络方法。
自监督通常归入广义无监督学习,因为它不需要外部逐条标签;单独使用“自监督”这个名称,是为了说明目标通过遮盖、移位、增强等操作由数据构造。D2L 导论的无监督学习部分采用了这一关系。预训练后再接少量有标签数据,会形成预训练与微调的多阶段流程。
强化学习
让摄像头转向并持续跟随动物时,当前动作会改变下一帧图像。把时刻 的状态记为 ,动作记为 ,环境返回奖励 和下一状态 。策略 给出状态下选择动作的概率,训练常以最大化期望折扣回报为目标:
表示一次交互轨迹, 是轨迹长度, 是有限时域例子的折扣因子, 表示对策略与环境产生的轨迹取平均。若三步奖励为 ,且 ,起点的回报是 。训练需要把最后的收益与之前的动作联系起来。
在只看到摄像头图像的任务中,真实状态可能不可直接观察;策略会使用观测或观测历史。交互数据随策略变化、延迟奖励如何分配,是这里新增的问题。可结合 D2L 的马尔可夫决策过程章节阅读,完整计算见强化学习。若只是对专家提供的“图像、动作”配对做拟合,则训练阶段是监督式模仿学习。
图像分类的任务约定
相册分类以一批 张图像为输入,输出 个分数。人工标签是长度为 的整数数组,训练最小化平均交叉熵。像素顺序、数据类型、数值范围和分数到概率的转换属于数据表示的约定;泛化误差由未参与训练的新照片估计。