损失函数给出了训练目标 L。为了降低它,需要知道每个参数变化一点会让损失怎样变化。反向传播计算这些导数,优化器用导数决定本次参数更新。
链式法则与计算图
若 u=g(θ),L=f(u),则
dθdL=dudLdθdu.
θ 是参数,u 是中间结果。前向计算先求 u 和 L;反向从 dL/dL=1 出发,用下游传来的导数乘当前运算的局部导数。若一个变量同时流向多条分支,各条路径对它的贡献要相加。
例如 u=θ2,v=3θ,L=u+v,两条路径分别贡献 2θ 和 3,因此 dL/dθ=2θ+3。共享权重的网络也按这一规则累计来自多个位置的梯度。RNN会从多个时间步累计,注意力会从多条矩阵运算路径累计。
自动微分系统在前向时记录运算及反传所需的中间量,反向按依赖关系执行局部求导。这避免为每个参数单独扰动一次输入,也不需要显式存下庞大的完整 Jacobian。PyTorch Autograd 文档介绍了这类动态计算图及中间量保存方式。
反向传播计算示例
取一个二特征样本 x=(1,2)⊤,标量标签 y=1。网络只有一个隐藏单元:
a=w⊤x+b,h=ReLU(a),y^=vh+c,L=21(y^−y)2.
w∈R2,b,v,c,a,h,y^,L 都是标量,共 5 个可训练参数。这里的 1/2 用来抵消平方求导产生的 2;它与默认 MSE 的尺度不同。
初始参数为 w=(0.5,−0.25)⊤、b=1、v=2、c=−0.5。前向结果为
a=0.5×1−0.25×2+1=1,h=1,y^=2×1−0.5=1.5,L=0.125.
从末端回传:
∂y^∂L=y^−y=0.5,∂v∂L=0.5h=0.5,∂c∂L=0.5.
输出对 h 的局部导数为 v=2,所以 ∂L/∂h=0.5×2=1。当前 a=1>0,ReLU 的局部导数为 1,继续得到
∂a∂L=1,∂w∂L=x=(1,2)⊤,∂b∂L=1.
按参数顺序 (w1,w2,b,v,c),梯度为 (1,2,1,0.5,0.5)。学习率取 η=0.01,使用同一次前向所算的全部梯度同时更新:
w′=(0.49,−0.27)⊤,b′=0.99,v′=1.995,c′=−0.505.
再次前向有 a′=0.94、y^′=1.3703,损失约 0.068561,小于更新前的 0.125。学习率过大则可能越过局部下降区域;负梯度只提供当前位置的一阶下降方向。
如果前向时 a<0,这个隐藏单元经 ReLU 传回的梯度为零,w,b 在该样本上不会获得更新。a=0 是不可导点,框架要选择一个约定;PyTorch 在这里采用零梯度。
矩阵求导
采用每行一个样本的约定,令
X∈RB×d,W∈Rd×h,b∈Rh,A=XW+b,H=ϕ(A).
B 是批次大小,d 为输入维度,h 为输出宽度;b 广播到每一行。若下游已经给出 GH=∂L/∂H∈RB×h,逐元素激活的反传为
GA=GH⊙ϕ′(A),∂W∂L=X⊤GA,∂X∂L=GAW⊤,∂b∂L=i=1∑B(GA)i,:.
⊙ 表示逐元素乘法。尺寸依次为 [B,h]、[d,h]、[B,d]、[h],与被求导变量一致。偏置在所有行共享,因此必须对 batch 维求和。若上游损失已经按 batch 平均,GH 已含 1/B,这里不再重复除以 B。PyTorch Linear 存储的 weight 是 [h,d],前向等价于 XWtorch⊤+b,读代码时要转换这一记号。
自动求导与有限差分
import torch
theta = torch.tensor([.5, -.25, 1., 2., -.5],
dtype=torch.float64, requires_grad=True)
def objective(t):
h = torch.relu(t[0] + 2 * t[1] + t[2])
prediction = t[3] * h + t[4]
return .5 * (prediction - 1).square()
loss = objective(theta)
loss.backward()
print(theta.grad)
eps = 1e-6
numeric = []
with torch.no_grad():
for j in range(theta.numel()):
delta = torch.zeros_like(theta)
delta[j] = eps
numeric.append(((objective(theta + delta) -
objective(theta - delta)) / (2 * eps)).item())
updated = theta - .01 * theta.grad
print(numeric)
print(objective(updated).item())
中心差分近似 ∂L/∂θj≈[L(θ+ϵej)−L(θ−ϵej)]/(2ϵ),ej 是第 j 个坐标方向。这个例子使用双精度、固定输入,并远离 ReLU 的折点。过小的 ϵ 会放大浮点消减误差,过大则增加近似误差。对于含随机操作的网络,先固定随机性;数值检查用于小张量和局部运算,不能代替大模型的日常反传。
SGD、动量与 Adam
设第 t 次更新前的参数为 θt−1,当前 batch 梯度为 gt=∇θLt(θt−1)。SGD 使用
θt=θt−1−ηtgt.
ηt>0 是学习率。小批次梯度随抽样变化,因此相邻步骤的损失可以上升。固定同一批数据才适合检查单步更新是否符合预期。
带动量的一个常见约定为
vt=μvt−1+gt,θt=θt−1−ηtvt,v0=0.
0≤μ<1 控制历史梯度的保留。vt 与参数同形状,要随检查点保存。若连续两次梯度都是 2,μ=0.9,则 v1=2,v2=3.8;另一种把梯度乘 1−μ 的定义会改变尺度,比较公式和实现时要先统一约定。
Adam 分别平滑梯度和梯度平方:
mt=β1mt−1+(1−β1)gt,vt=β2vt−1+(1−β2)gt2,
m^t=1−β1tmt,v^t=1−β2tvt,θt=θt−1−ηtv^t+ϵm^t.
平方、平方根和除法逐元素进行。mt,vt 初始为零;β1,β2 是衰减系数;ϵ>0 避免分母为零。偏差修正补偿零初始化导致的早期缩小。若首步标量梯度为 2,β1=0.9,β2=0.999,则 m1=0.2,v1=0.004,修正后为 2 和 4;忽略极小的 ϵ,首步参数减少约 η1。
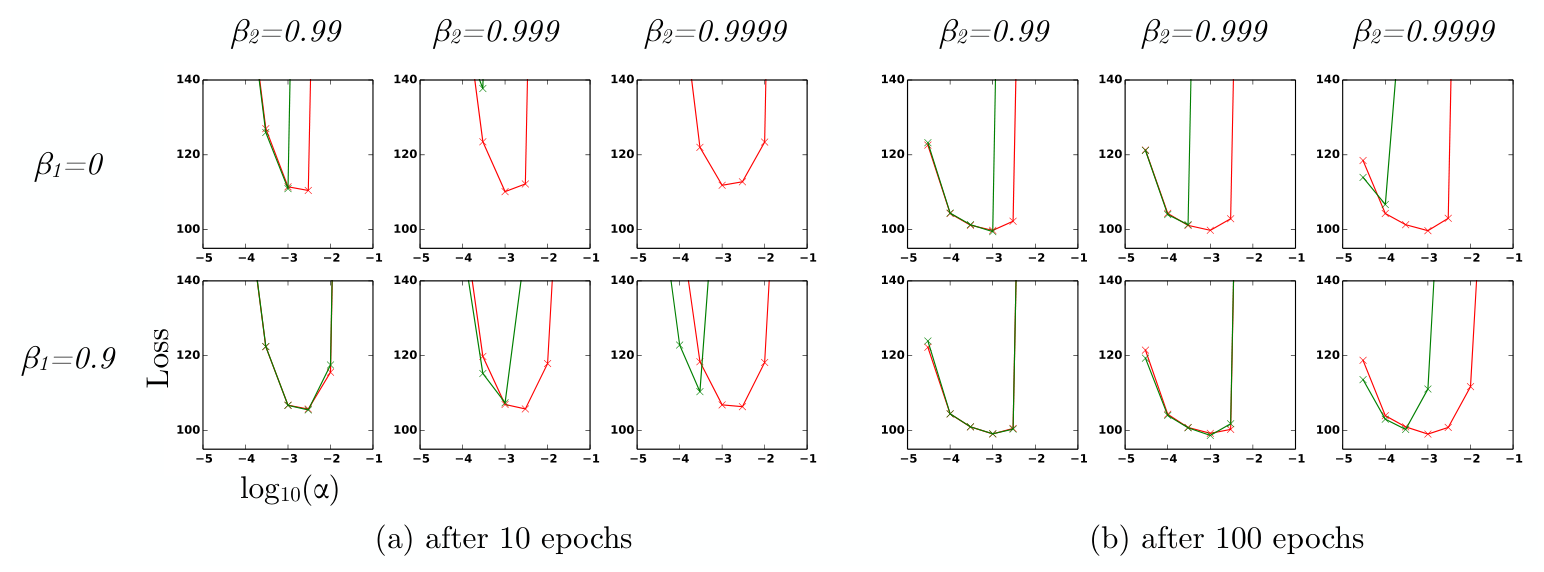
图 1:Kingma 与 Ba,Adam Figure 4,裁去周围正文。红线使用偏差修正,绿线不使用;横轴是学习率的常用对数,纵轴是损失。左右两组分别在训练 10 轮和 100 轮后测量,上下两行与各列改变矩估计的衰减系数。原实验使用 VAE;算法公式见原文 Algorithm 1。
Adam 保存两组与参数同尺寸的矩估计和步数。模型权重之外,梯度、优化器状态与前向激活都会消耗显存。把参数转成较低精度也不代表所有状态都使用同样精度。
AdamW 把权重衰减单独应用到参数,例如先做 θ←(1−ηtλ)θ,再执行 Adam 更新。λ 是衰减系数。将 λθ 加入梯度的 L2 惩罚会进入 Adam 的矩估计与逐坐标缩放,二者一般不等价。AdamW 原论文和 PyTorch 接口说明了这一分离方式。
学习率、裁剪与梯度累积
学习率决定每步走多远。可先用少量训练数据观察损失,寻找能稳定下降的数量级,再在验证集上比较。warmup 在最初若干更新中逐渐提高学习率,随后按预定规则下降。一种余弦调度为
ηt=ηmin+2ηmax−ηmin(1+cosTπt),0≤t≤T.
这里 t 是 warmup 结束后的更新计数,T 为余弦阶段的总更新数。梯度累积改变每轮 optimizer step 的数量,因此调度器按“轮”还是按“更新”推进必须明确。依赖验证损失的调度器则在完成验证后接收该指标。
全局范数裁剪把所有待更新梯度拼成一个向量,使用
g←gmin(1,∥g∥2c),
其中 c>0 是阈值,g=0 时保留原值。裁剪限制这次更新所见的梯度幅度,无法修复错误标签或前向中的 NaN。PyTorch 通常在 backward() 之后、step() 之前调用 clip_grad_norm_。
显存不足时可将一个有效 batch 拆成微批次。例如 4 个各 8 样本的微批,累计后相当于对 32 样本的平均损失求导,前提是样本之间没有改变结果的批次耦合操作。每个微批的平均损失应乘 8/32,每组只清零和更新一次。BatchNorm 的微批统计量不同,因此有 BatchNorm 时一般不能宣称与大批次完全等价。
下列片段假设 group 是本次更新的若干 (xb, yb) 微批,loss_fn 按样本平均:
optimizer.zero_grad(set_to_none=True)
count = sum(len(yb) for _, yb in group)
for xb, yb in group:
    loss = loss_fn(model(xb), yb)
    (loss * len(yb) / count).backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
optimizer.step()
按实际样本数加权可以处理最后不足一组的微批。若损失按 token 平均,这里的权重改为有效 token 数。采用浮点混合精度和梯度缩放时,先反传缩放后的损失,再取消梯度缩放,然后裁剪,最后由缩放器执行更新;官方 AMP 示例给出了顺序。
检查训练异常时,可以记录损失、学习率、梯度范数以及参数更新量。若损失不降,先确认梯度存在且更新确实发生;若梯度爆炸,定位首次出现非有限值的运算。优化链路正常后,再用评价与泛化判断模型是否只是更好地记住了训练数据。
