
同一只鸟可以出现在照片、文字描述和录音中。这些输入的数值格式不同:图像是像素网格,文字先变成 token ID,声音是随时间变化的采样值。把它们送进各自的编码器后,还需要训练目标告诉模型哪些信息应当联系起来。
裁布台上的牛皮纸
唐师傅做了四十年衣服,这两年眼睛花了,挑布全靠手。一块料子在指头间搓两下,他就知道厚薄、软硬,攥一下回弹快不快。徒弟小秋眼睛好,隔着柜台就能分出灰蓝和铁灰,哪块有光,哪块发哑。
两人一起接活儿就容易拧。小秋说客人要“那块发哑的灰蓝”,唐师傅去库房摸了一圈,拿回一块又厚又挺的,颜色没错,客人要的却是软的。唐师傅说要“薄、有点糙、一攥就弹回来的那种”,小秋在架子前看来看去,指不出是哪一卷。
老板娘是唐师傅的女儿。她在裁布台上铺了一张牛皮纸,每晚收工后抽八卷布,每卷剪下两小块,在背面缝上同样颜色的线头。一块装进布袋,唐师傅只能伸手进去摸;另一块摊在小秋面前,小秋只许看,不许碰。两人各凭各的办法,把手里的布块放到牛皮纸上。
放完了对线头。从唐师傅的每一块看过去,离它最近的小秋那块,应该是同一卷上剪下来的;再从小秋的每一块看回来,离它最近的唐师傅那块,也该是同一卷的。两头都找对,才算对上。头几晚,八对里只对上两三对,常常是别的卷挨得更近。
对不上的,两人各改各的放法:同卷的两块往一处挪,靠得太近的别卷往外推。唐师傅还是只用手,小秋还是只用眼,改的是各自心里“什么样的布该放在纸上哪儿”。第二天换八卷布,接着放,接着对。
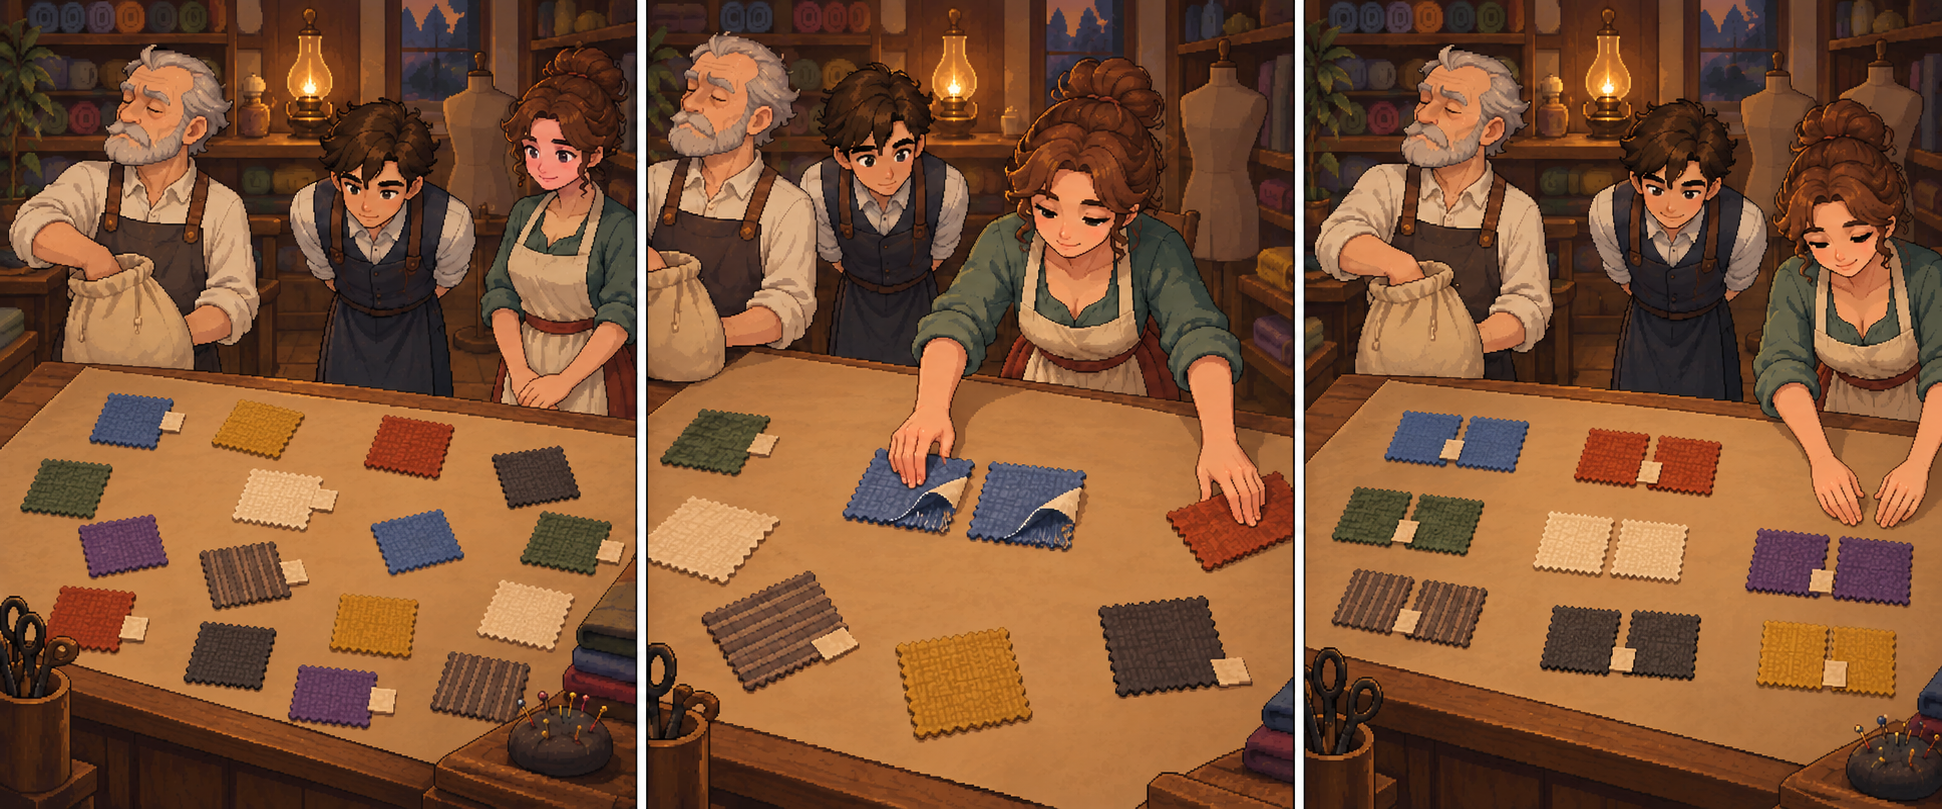
一个多月后,八对常常全对上。新到一卷布,唐师傅摸过放下,小秋看过放下,两块挨在一起。再有客人来挑布,小秋看一眼客人手里的样子,在牛皮纸上点一处,唐师傅就去库房找摸起来该落在那一处的料子。
这叫对比对齐:两种模态各用自己的编码器,靠同一事物的成对样本来训练。在一批数据里,从哪一边出发,都要在另一边的候选中找到自己的配对,正确配对的相似度调高,同批其余样本的调低。练完以后,两种表示落在同一个空间里,配对的彼此靠近。
对比对齐
两种模态可以各自编码,再靠已知的配对关系学会比较彼此的表示。故事里,触觉与视觉各有一套辨认布料的办法,同卷布上的线头提供了配对依据,牛皮纸上的位置则让两套表示可以比较。下面采用图像与文本来说明这套机制:配对依据换成照片及其对应描述,比较的位置换成向量空间。
给定一批图像及其描述,先解决“哪段文字与哪张图配对”。CLIP 用图像编码器和文本编码器分别得到向量,再以双向对比损失训练它们。Radford 等人,2021,§2.2 与图 3给出批内配对目标和实现伪代码。
先把图像和文本转换成可以比较的向量。设一批有 对数据,第 对为 ,其中 是图像, 是对应文本。图像编码器产生 ,文本编码器产生 。两个编码器的输出维度可以不同,因此分别用投影把它们变成相同宽度。
本节向量按行存储,投影矩阵 、 将它们送到同一个 维空间,然后各自作 L2 归一化:
归一化后,比较向量的方向就能衡量图文的相似程度。分母非零时, 均为单位行向量,内积就是余弦相似度;实现中用很小的正数保护零范数。把所有行堆成 ,用温度 缩放:
是文本特征矩阵,与批量标量 区分。矩阵的行是图像,列是文本;对角线来自原始配对,称为正对;其他位置按不配对的负对参与本批次训练。温度控制分数差异经过 softmax 后被放大的程度,温度越低,概率越集中在高分候选上。CLIP 实现用可训练标量 表示逆温度 ,与两个编码器及投影一起更新。
双向损失
双向损失让每张图找对应文本,也让每段文本找对应图像。对第 张图,沿第 行做 softmax,把正确文本的列号 作为分类标签。反过来,对第 段文本,沿第 列做 softmax,把正确图像的行号 作为标签:
每个方向先把 个分类损失相加并除以 ,总损失再取两个方向的平均。两个方向共享分数矩阵,却各自计算 softmax 的分母:图像到文本沿行归一化,文本到图像沿列归一化。因此,同一对图文在两个方向上的配对概率通常不同。
两对合成数据就能看出行、列归一化的区别。令 ,图像向量 、;文本向量 、,它们都已归一化。取 ,得到
| 图像与文本 | 文本 1 | 文本 2 |
|---|---|---|
| 图像 1 | ,正对 | ,负对 |
| 图像 2 | ,负对 | ,正对 |
图像 1 选对文本的概率为 ,图像 2 为 。因此
按列计算,文本 1 选对图像的概率为 ,文本 2 为 :
文本 2 找图像时,图像 1 的分数 与正确图像的 很接近;图像 2 找文本时,错误文本的分数为 ,与正确文本相差更大。因此,文本 2 反找图像比图像 2 找文本更难,双向训练会分别处理这两种混淆。
损失通过分数的梯度调整图文表示。单个方向对分数的梯度是“预测概率减正确标签”,再除以批量;正确配对的标签为 1,其余为 0。总损失还需乘两个方向平均的 。
下面的实现中 image_features、text_features 已完成各自线性投影,形状均为 。log_inverse_temperature 就是上面的 ;训练循环应让梯度继续回到两个编码器:
import torch
import torch.nn.functional as F

def clip_loss(image_features, text_features, log_inverse_temperature):
    a = F.normalize(image_features, dim=-1)
    b = F.normalize(text_features, dim=-1)
    scores = a @ b.T * log_inverse_temperature.exp()
    labels = torch.arange(scores.shape[0], device=scores.device)
    return (F.cross_entropy(scores, labels)
            + F.cross_entropy(scores.T, labels)) / 2
批内负样本的质量会直接影响配对训练。两张照片若是同一种鸟、描述也都正确,非对角位置也可能是合理配对;把这些分数一概压低,就会产生假负样本。重复文本、同一图像的多个描述可以通过整理配对数据或允许多个正例的目标处理。批量大小还决定了候选数量: 时两次 softmax 都只有一个候选,损失恒为零。
检索与分类
学会图文配对后,可以用文字查找图像。检索时预先编码候选图像,再用查询文本的向量逐个打分,返回最高分的图像。
分类也可以写成配对问题:零样本分类把候选类别写成文本描述,编码后与图像比较;新增类别可改变候选文本集合,而不必立即增加一个固定类别输出层。“零样本”是说没有用这次分类任务的训练标签继续拟合,模型依赖的仍是先前的图文训练。
相似度回答的是“这些候选里哪一个更匹配”。例如候选文本只有“鸟”和“铃铛”,CLIP 就给它们排序;softmax 概率也随候选集合改变,表示候选之间的相对匹配程度。要进一步生成“左边有两只鸟”这样的回答,需要把图像信息接入一个预测下一个文本 token 的模型,并用语言生成目标训练这条路径。
视觉 token 与连接器
一张全局图像向量适合做整体匹配,但回答“左边是什么”需要保留不同位置的特征。以 LLaVA 原论文 v2 §4.1的路径为例:取 CLIP 视觉编码器的网格特征,经过可训练线性连接器,形成与语言嵌入同宽的视觉 token,再交给语言模型。
先沿着图像进入模型的过程核对张量形状。以下是一组用于复算的配置:批量 ,输入 RGB 图像缩放到 ,视觉 patch 为 ,视觉宽度 ,语言宽度 ,词表大小 ,对应 ViT-L/14 加语言解码器的连接方式。
每张图有 个 patch;每块含 个像素分量。共享的线性 patch 投影把 变成 。视觉编码器还加入位置编码;若实现包含一个 CLS token,内部长度会是 257。本例在输出网格特征时去掉 CLS,保留 。
连接器负责把每个位置的视觉特征转换成语言模型接收的宽度。记网格特征为 ,连接器采用无偏置线性投影 :
投影后仍有 256 个位置,每个位置的特征从 1024 维变成 4096 维。这样的连续向量就是一个视觉 token,可以直接作为语言模型的输入嵌入。
参数量由输入、输出宽度决定: 有 个可训练参数;若实现带偏置,还要加 4096 个。
例如把宽度缩成 ,单个网格向量 与
相乘得到 。这个小例子展示了连接器如何把一个位置的两个特征分量组合成三个分量;实际配置对每个位置都应用同一投影。
进入语言模型
视觉和文字要共同参与回答,就要把两者的嵌入放进同一条序列。将系统提示、用户问题和必要的角色分隔符编码为 个文本 token ID,查语言嵌入表 得到文本嵌入 。本例把视觉 token 放在文本之前:
分号表示沿序列轴拼接。20 已含本例所需的文本特殊标记,额外的图像起止标记也要计入长度。对话模板也可以把图像放在用户文本中间,长度和标签位置随之改变。
| 步骤 | 张量形状 | 信息或运算 |
|---|---|---|
| 图像输入 | 连续像素 | |
| patch 展开 | 256 个空间块 | |
| 视觉编码器输出网格 | 已结合图像上下文的特征 | |
| 连接器 | 与语言模型输入宽度相同 | |
| 文本 ID 查嵌入 | 系统与问题等文本 | |
| 拼接前缀 | 视觉与文本占不同序列位置 | |
| 因果语言模型 | 后面的位置可使用前面的视觉信息 | |
| 词表线性层 | 每个位置预测下一个文本 token | |
| 首次生成取末位置 | softmax、选择 token ID、追加输入 |
语言模型用序列末尾的隐藏状态预测回答的下一个 token。它的词表投影为 ,因此末层隐藏状态乘 得到词表 logits。每次只用当前末位置预测下一 token,选择后查嵌入表,追加到序列中继续解码;输出 ID 最终由 tokenizer 解码为文字。视觉编码和连接器通常在一次图像输入时计算一次,其结果进入前缀的 KV cache,后续步骤复用缓存。
视觉信息能否被某个文本位置使用,取决于注意力允许它访问哪些位置。视觉编码器内部采用图像块之间的双向注意力,所以输出的视觉 token 已结合整张图的上下文。进入本例的因果语言模型后,各位置只访问其左侧和自身;所有问题和回答位置都在视觉前缀之后,因此可以访问全部视觉 token。带 padding 的批次还要屏蔽填充位置。
连接器还要学会把对象和空间关系表示成语言模型能用于回答的向量。随机初始化时,它尚未学到这种对应关系;接下来用正确回答作为训练目标,让答案损失经过语言模型传回连接器。
视觉指令学习
视觉指令学习用问题指定要从图像中提取的信息。一条训练样本应包含图像 、问题或指令 、目标回答 。例如图像中有两只鸟,问题是“左边那只是什么颜色?”,回答是“蓝色。”。同一图像也可以配计数或整体描述问题,这些问题选择了图像中的不同信息,因此训练数据需要同时覆盖描述、计数和局部属性等请求。
LLaVA v2 §3 使用图像描述与边界框等符号信息,让当时的纯文本教师生成对话、详细描述和推理数据。教师以文字与框标注为输入生成指令,数据审查时要把生成内容与标注核对,剔除自行补出的细节。原文 §3、§4.2还区分了连接器预训练与指令微调:
| 阶段 | 数据和预测目标 | 视觉编码器 | 连接器 | 语言模型 |
|---|---|---|---|---|
| 连接器预训练 | 图文对转成描述请求,预测描述 | 冻结 | 更新 | 冻结 |
| 视觉指令微调 | 图像、问题、回答,预测助手回答 | 冻结 | 更新 | 更新 |
原始 LLaVA 先让连接器学习如何把视觉特征交给已有的语言模型,再让连接器和语言模型一起适应回答指令。其他方案也有解冻视觉编码器或改用多层连接器的。
第一阶段冻结语言模型,是把它的权重固定下来;连接器仍要根据回答损失更新。连接器改变视觉输入后,固定权重的语言模型会产生不同的答案概率。反向传播需要计算答案损失对视觉输入的梯度,再沿 传到 ,连接器才知道怎样调整输出。
因此,冻结语言模型权重时,要保留经过它的计算图。把整个语言模型前向包进 no_grad() 会切断从回答损失到连接器的梯度路径。视觉编码器则位于可训练连接器之前:第一阶段只需拿它的输出 计算连接器的梯度,所以冻结后可以预计算这些特征。
回答损失与掩码
训练时使用 teacher forcing:把真实回答也放入输入序列,让模型根据图像、问题和已经给出的正确回答前缀,预测下一个回答 token。
设回答及停止标记共 个 token,本例总长度为 ,隐藏状态和 logits 分别为 、。
损失只监督模型需要生成的回答。在移位后的下一 token 标签中,只对助手回答及其停止标记计损失;视觉位置、用户问题、系统消息和 padding 的标签均忽略。
令 标记批次样本 中第 个移位标签是否应训练, 为该标签 ID, 为预测它的 logits。损失把批次中所有有效回答 token 的负对数概率相加,再除以这些 token 的总数:
标签的移位必须配合输入位置:最后一个问题位置的 logits 预测回答的第一个 token;第一个回答位置的 logits 预测第二个回答 token。因果遮罩让每个位置只使用它之前和当前位置的真实 token,下一位置的目标 token 留作预测。多轮对话中可对各轮助手回答计损失,用户轮保持忽略。
若一个回答只有两个被监督 token,其目标概率为 和 ,则平均损失为 。假如另有 20 个问题 token 被忽略,分母仍为 2。把分母误写成整段长度会让较长问题稀释相同回答的训练信号。
回答中的词就能为视觉特征提供训练信号。答案损失通过注意力把梯度传到所用的视觉特征,因而训练可以直接使用图像、问题和回答,无需逐个给视觉 token 标注对象。模型也可能从问题的常见答案中找到捷径,例如把“天空是什么颜色”总答成“蓝色”。评价时改变图像而保持问题不变,就能检查回答是否随视觉信息变化。
评价问题
检索和生成回答的输出不同,评价也应分开。检索先固定候选库,用 Recall@K 检查正确配对是否进入前 名,并说明一个查询是否允许多个正确配对。回答任务需要可检查的答案或事实单元:计数看数字,空间关系看对象及左右顺序,描述则逐项核对所述对象是否存在。
对回答任务,可以保持问题不变,只改变图中的数量、位置或可见信息,检查模型是否跟着调整答案:
| 输入变化 | 固定的问题 | 核对内容 |
|---|---|---|
| 同场景从两只鸟改为三只 | “共有几只鸟?” | 答案是否随数量改变 |
| 交换红杯与蓝杯的左右位置 | “左边杯子是什么颜色?” | 颜色词是否随空间关系改变 |
| 图中没有狗,问题暗示“这只狗” | “这只狗在哪里?” | 是否指出图中未见狗,而非编造位置 |
| 同问题换成不相关图或移除图像 | 保持文字完全一致 | 正确率下降和答案变化,作为视觉依赖的诊断 |
| 缩小图片导致小字不可辨 | “标签写了什么?” | 是否说明无法辨认,是否凭常见文字补全 |
移除图像会改变输入分布,诊断视觉依赖时应结合原图、替换图和无图的结果,比较答案与正确率怎样变化。
测试集还应与训练集隔开原始图像及其近重复。划分时先按图像分组,再把整组分入训练集或测试集,使同一张图的不同问法留在同一组,避免训练记忆混入评价。对合成指令,则核对答案是否包含教师从文字描述之外补出的细节。
裁剪掉目标物体、连接器没学会传递位置、语言模型忽略图像,都可能产生相同的错误答案;逐步查看预处理后的输入、对照问题与生成结果,才能确定下一步应改数据、表示还是训练范围。任务指标的选择与划分原则见评价与泛化。