
同一批训练设备,可以训练更大的模型,也可以让较小的模型读更多文本。两者花掉同样的计算预算,在验证集上的损失却可能不同:模型需要足够的参数来学习,也需要足够的训练数据来调整这些参数。分配预算时,要一起考虑参数量和训练 token 数;采用专家模型后,还要区分模型拥有的全部参数与单个 token 经过的模块所包含的参数。
计算预算
估算训练预算,先要知道模型处理一个 token 需要多少运算,再乘以训练期间处理的 token 总数。令 是稠密语言模型的参数数目, 是训练期间实际处理的 token 总数, 是训练浮点运算次数,单位为 FLOPs;一次乘法和一次加法各计一次运算。 包括重复读取:同一份十亿 token 的语料读两遍,处理量就是二十亿 token,语料本身仍只有十亿 token。
如果主要计算花在输入与参数矩阵相乘上,就可以先按参数量估算成本。一次前向每 token 约需 FLOPs,反向求输入和权重梯度约需前向的两倍,得到
这是Chinchilla §3.3、附录 F使用的预算近似,适合先比较稠密模型的不同训练配置。估算实际成本时,还要计入长序列注意力、词表投影、激活重计算、优化器更新和通信;稀疏专家模型则需要按选中的专家另算。把运算量 换成训练时间,还需要设备的有效吞吐,即每秒实际完成的 FLOPs,它受显存访问与硬件利用率影响。
例如预算为 FLOPs,下列三组稠密配置具有相同的 :
| 参数 | 训练 token | |
|---|---|---|
三组配置的预算相同,但模型大小和训练数据量各有取舍,下一节将用损失模型比较它们。先把这笔预算换成时间:如果设备合计有效吞吐为 FLOPs/s,纯计算时间估计为 秒,约 6.94 天;有效吞吐减半,时间就翻倍。
本章用“最优”表示给定训练预算下损失最低的配置。若考虑整个服务周期,还要加入训练完成后的推理费用:当模型需要服务大量请求时,较小的部署模型可以节省长期推理开销,因此可以考虑为它投入更多预训练计算。
规模规律
规模规律用一组训练实验来估计:改变模型参数量 和训练 token 数 ,损失会怎样变化。对自回归语言建模,比较之前要固定分词器、数据分布、上下文长度与评估方式,使各次实验的损失具有相同含义。
本节用验证集衡量训练后模型的预测表现。损失 定义为验证集上每个有效目标 token 的平均负对数概率,使用自然对数,单位为 nat/token。这个平均值越低,模型给正确 token 分配的概率总体上越高。固定分词器尤其必要,因为分词器会决定一个 token 包含多少信息,进而影响损失的数值尺度。
为了分别描述参数量和训练数据量的影响,常用的拟合形式把损失写成三项:
是预测损失。 是拟合中的渐近项,表示在这个模型里,参数量和数据量持续增大时损失趋近的数值。其余两项描述有限规模带来的损失: 控制两项的大小,规模指数 控制它们随规模增长而下降的速度。这五个量都是从实验估计的标量。
Hoffmann 等的原论文 §3分别研究训练曲线包络、等 FLOPs 曲线和参数化损失拟合。其 §3.3 取前两类实验的最终损失,在对数损失上做稳健拟合;本节则用固定验证集来说明损失的定义。比较实验时,训练日程也要配合训练长度:原论文把学习率衰减长度与训练 token 数配合,让每次运行在结束前完成衰减。若提前截断一条原本计划训练很久的曲线,就会把尚未完成衰减的损失混入比较。
实际拟合时,先在同一数据配方下选择几档模型和几档训练长度,为每次运行记录 。用其中一部分运行的记录估计系数,再用预先保留的其他运行检验预测,观察预测损失与实测损失的差值是否随规模系统性增大。数据去重、语种比例、训练稳定性和学习率日程改变后,要重新检验这些系数。拟合区间之外的结果是外推预测。CS336 第 9 讲第 38–39 页讨论用小模型预测规模变化,也提醒下游任务的变化可能更难预测。
固定预算的分配
有了损失预测式,就能比较同一预算下的不同配置。在 下,选定 也就确定了能处理的 token 数 。将它代入损失式,消去 :
增大 会降低第二项,却提高第三项,因为每个 token 的计算变贵后,同一预算能处理的 token 更少。最优点出现在这两种影响相互抵消的位置。将对 的导数设为零,有
从而
星号表示这个连续近似问题的最优点,可作为选择实际配置的参考。实际模型的宽度、层数只能离散选择,训练 token 也受数据供给限制。
最优配置如何随预算增长,取决于拟合得到的两个规模指数。当两个指数相等时, 与 都按 增长;若不相等,增长速度也不同。所以“数据与模型大致同比扩大”来自特定的拟合结果。
用一组教学系数算一次。定义无量纲规模 、,并假定
上节的 FLOPs 预算使 。按表格从上到下的顺序,三组配置的预测损失分别为 2.56066、2.50000、2.56066 nat/token,中间一组最低。把预算扩大四倍,则最优 ,模型和训练 token 都翻倍,损失为 。
深夜热线
市广播电台有一档深夜热线,听众打进来问生活里的难事。以前直播间里只坐两位顾问,一位律师,一位退休医生,什么电话都由他们俩接。
今年台里又请来六位:会计、兽医、水电师傅、退休的银行职员、心理咨询师、房产中介。导播方姐的做法没变,电话照旧转进那两条老线,新来的六位在隔壁喝了一个月茶。有人问猫三天不吃饭,律师只能说“去看看兽医吧”。
台长找方姐谈过以后,她换了接法。每个电话先在她这里停几秒,她听完第一句,从八位里挑两位接进直播间,其余六位的话筒不开。挑中的两位也不平分时间:问租房押金的,中介讲大半,律师补几句;问孩子半夜哭闹的,心理咨询师和医生接,咨询师讲得多。主持人把两段话收成一个回答。同一个晚上,前后两个电话,接进来的常常是完全不同的两个人。
一开始她也挑错过。问楼上漏水的电话,她全给了水电师傅,其实听众想问的是这钱该谁出。她每晚听节目回放,哪通答到了点子上,哪通答偏了,下回同样的电话就换人接。几个月下来,第一句听完,她就知道该转给谁。
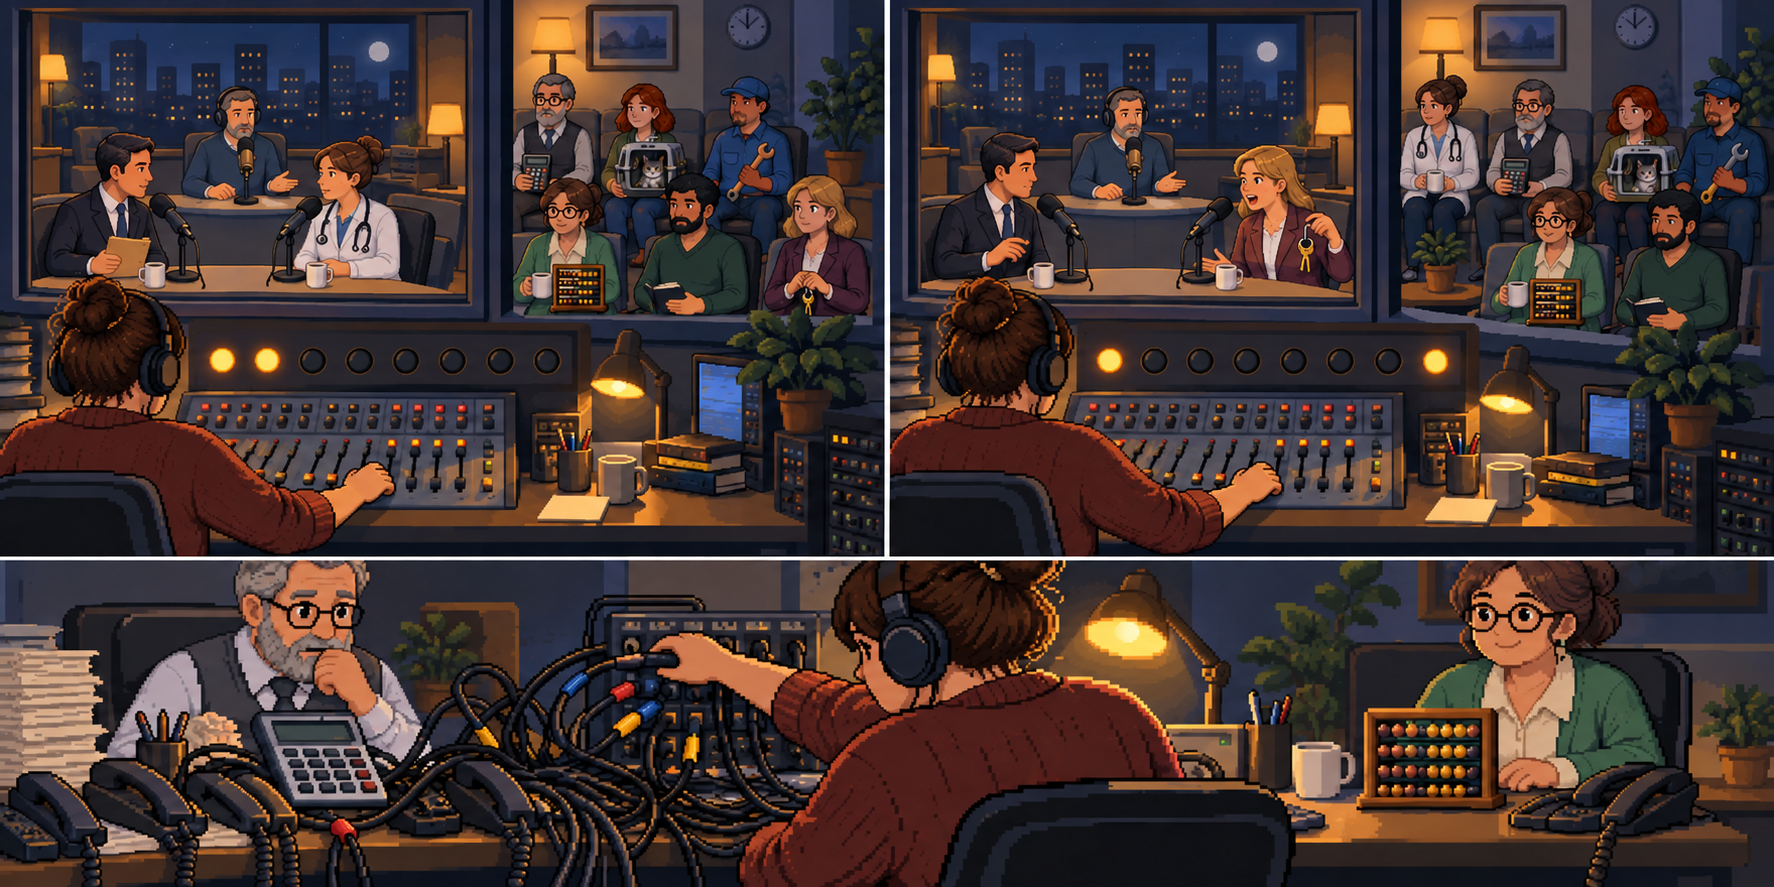
到了三月报税季,问个税的电话一晚上来了几十个,个个都挑会计。会计那条线排起长队,听众等到挂断,隔壁几位又闲了下来。方姐把一部分电话改转给排第二、手头又空着的银行职员,又给会计多开了一条线。
混合专家模型里,方姐这个位置叫路由器:逐个 token 挑出 top-k 个专家,按权重合并它们的输出,其余专家不参与计算。挑法是训练出来的;挑得太集中时,要靠负载均衡。
混合专家
稠密模型扩大参数量时,每个 token 的计算量也随之增加。稀疏混合专家(Mixture of Experts,MoE)通过只调用部分参数来增加模型容量:它把某些 Transformer 层的单个前馈网络替换为多个可训练前馈网络,每个 token 只交给其中少数几个处理。
这些前馈网络称为专家,选择专家的模块称为路由器。它根据当前 token 的表示打分,选出专家,再按权重合并输出,就像深夜热线里的导播挑选顾问并分配发言时间。注意力仍负责 token 之间的信息交换,专家处理各位置的通道变换。Mixtral §2.1给出每层每 token 选两个 SwiGLU 专家的实例。
先看一个专家如何处理输入。取单个 token 的列向量 , 为模型宽度,共有 个专家。第 个专家使用中间宽度为 的 SwiGLU:先把输入投影成两个中间向量,用其中一路控制另一路各分量的大小,再投影回原来的宽度。对应运算为
其中 ,;,输出 。 表示逐元素乘, 逐元素作用。
三个矩阵各含 个参数,所以省略偏置时,每个专家共有 个参数。各专家的矩阵互不共享,能够在训练中学到不同的变换。
路由器要同时决定调用哪些专家,以及各专家的输出占多大权重。路由器矩阵 给出分数 ,每个分量对应一个专家。令 为分数最高的 个专家编号,。选好专家后,在选中集合内用 softmax 归一化分数,再合并输出:
是标量,选中权重之和为 1。合并结果 保持输入宽度,因此仍能接回原来的 Transformer 层。节省计算依靠的是先选择、再计算:实现时只运行被选中的专家。
把单个 token 的操作扩展到一批序列时,需要保留每个位置的分派结果,才能在计算后将输出放回原位置。令 为批次大小、 为每条序列的位置数,批次输入 可展平为 个位置:路由分数为 ,编号与权重为 ,专家计算后按原位置加权合并为 。
Top-2 算例
用四个专家中选两个的例子,可以同时看到选择和加权这两步。设 ,路由分数是 ,因此选择专家 1、2,其权重为
专家 1 的分数较高,所以它在合并结果中占更大的权重。设两个专家对当前输入的输出分别为 、,将两个向量分别乘以上面的权重再相加,得到
归一化的范围会影响输出大小。若先对四个分数 softmax,再取前两个而不重新归一化,保留下来的总权重约为 0.880797,输出会整体缩小。因此实现本节公式时,要让被选中的两个专家权重之和为 1;分数并列时,还要固定选取规则,使结果可以复现。
路由器和专家都通过训练调整参数。top-k 的编号选择是离散操作;在本节 top-2 的选中集合不变的局部区域内,损失可以通过 回传给路由分数,也通过 更新选中专家。这两条梯度路径分别调整专家的输出和合并输出的权重。未选专家在该 token 上没有这条专家计算的梯度,但可能被同批其他 token 选中。各专家处理什么输入,由训练中的路由和参数更新逐渐决定。
参数、存储与通信
只选择少数专家后,需要分别统计模型保存了多少参数,以及单个 token 经过的模块包含多少参数。设 是所有非专家共享参数的数量,包含注意力、嵌入和路由器;共有 层 MoE,每层专家数和尺寸相同。每层保存 个专家、每个 token 选择 个专家,因此两种计数分别为
这里按 token 经过的模块统计 ,共享模块整体计入。嵌入查表每次只读少量行;一整个 batch 的 token 则可能分走不同专家,合起来触及所有权重。
取 ,并给定 。每专家有 个参数,总计 ,单个 token 经过的模块包含 个参数。
权重常驻存储要按总参数量计算,因为未被当前 token 选中的专家也需要保留。以每权重 2 字节常驻存储计算,总权重需要 字节,约 51.81 MiB;把 乘 2 得到的约 27.81 MiB 只覆盖选中模块的权重大小。训练另需梯度、优化器状态和激活,推理另需 KV cache 与临时缓冲。
计算量则取决于当前 token 选中了多少专家。单专家三次矩阵向量乘法约为 FLOPs,因此本例两个专家前向约为 FLOPs/token,另有路由 、门控、合并及其他模块成本。四专家全算的专家部分会翻倍。增加专家数而保持 不变,主要专家算术量不变,但路由与存储仍增长。
专家分布在不同设备时,选择专家还会带来通信:输入向量需要发到专家所在设备,计算结果需要传回才能合并。设 个 token、每元素 字节,按每份分派都跨设备且输入输出宽度相同的简化口径,逻辑传输量约为 字节。本例若 ,是 8 MiB/层;本地专家能减少实际网络传输,协议开销与反向通信又会增加成本,实际延迟取决于这些通信成本与矩阵计算成本的共同作用。
负载均衡
路由还需要避免工作过度集中,否则繁忙专家会让其他设备等待。热线故事里报税电话都涌向会计,MoE 中也会出现类似的排队问题:八个 token 都选同样两个专家时,四专家的分派数是 ,尽管平均每专家只有四份工作,最忙的专家仍要处理八份。如果固定容量缓冲按每专家四份分派分配,最忙的专家就会溢出。可以扩大容量、改派或使用支持不均匀分组的计算内核;若丢弃超容量的分派,对应专家的贡献也会从实际计算中消失。
除了处理已经发生的拥塞,还可以在训练时鼓励路由器分散工作。Switch Transformer §2.2在 top-1 路由中使用辅助均衡损失。下面用每个 token 只选一个专家的 top-1 情形说明这个损失。
均衡损失把实际分派比例与路由概率结合起来。对 个位置, 是位置 在所有 个专家上的 softmax 概率; 是实际选中专家 的位置比例; 是其平均概率。辅助项为
控制均衡损失的权重。反传时把实际分派比例 当作固定计数,通过可微的平均概率 调整路由:分到越多 token 的专家,其概率对应的惩罚越大。
四专家均匀时该项为 ;若 、,为 ,给高负载专家施加更大的抑制压力。top-2 实现要另行规定分派比例的分母与归一化。
均衡项与语言建模损失共同决定训练中的路由选择。权重太小,专家仍可能拥塞;权重太大,路由器又可能为了分散工作而少选适合当前 token 的专家。调节这个权重时,要结合验证集损失、各专家分派数、溢出率和实际吞吐,观察预测表现与工作分配如何一起变化。
参考文献
- Hoffmann et al. Training Compute-Optimal Large Language Models. 2022,arXiv:2203.15556v1,§3、附录 F。
- Jiang et al. Mixtral of Experts. 2024,arXiv:2401.04088v1,§2.1。
- Fedus et al. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. arXiv:2101.03961v3,§2.2。