
Transformer 已能用因果注意力预测下一个 token。继续搭建语言模型时,还需要决定:位置信息怎样进入注意力,残差分支怎样归一化,前馈层怎样变换通道。这些构件可以分别选择,再组合成一个解码器层。
现代解码器
一个解码器层先用注意力汇集各位置的信息,再用前馈网络(FFN)变换每个位置的特征。两个子层都先归一化输入,再把计算结果加回残差主路,写成
是本层输入, 是注意力子层之后的表示, 是本层输出。它们都满足 ,其中 是批量大小, 是序列长度, 是模型宽度。子层输出保持这个形状,才能与残差主路逐元素相加。
两个 Norm 各自学习归一化参数;注意力只读取当前位置及过去位置,以便预测下一个 token。多个解码器层堆叠后,末尾再做一次归一化并投影到词表,训练目标仍是下一 token 交叉熵。
LLaMA(2023)§2.2把来源不同的位置处理、归一化和前馈构件组合进同一个解码器。
给输入嵌入加上位置表后,网络还需要从位置表示中学出两个 token 相距多远。若让位置差直接参与 query 与 key 的比较,注意力分数就能同时反映内容是否匹配、位置相距多远。
操场上的转身
体育课上,周老师带全班玩一个配对游戏。每个孩子戴一顶帽子,帽檐上画一个箭头,方向自己挑。大家沿跑道上的白线站成一排,再按脚下的线转身:站第一条线的转一格,第二条线的转两格,往后每多一条线多转一格。转完之后,两个人帽檐上的箭头越朝同一边,配合分越高。
以前她用名单配对,上面写着“三号线和五号线一组”。有一次操场东头积水,全班挪到十号线以后去站,三号线上根本没人,名单只能作废。
换成转身以后,积水又来了一回。全班往后挪了七条线,每个人都多转了七格。阿哲和小禾原来隔着两个人,现在还是隔着两个人,两顶帽子之间差的角度没变,配合分和上周一样。后来小禾自己换到了队尾,两人之间差的格数变了,帽檐对不上,分数才跟着变。
隔得一样远,分数也不一定一样。阿哲和小禾原本画的箭头就差不多,转完仍然挨得近;另一对同样隔两个人,一个画朝北,一个画朝南,转完还是对不上。
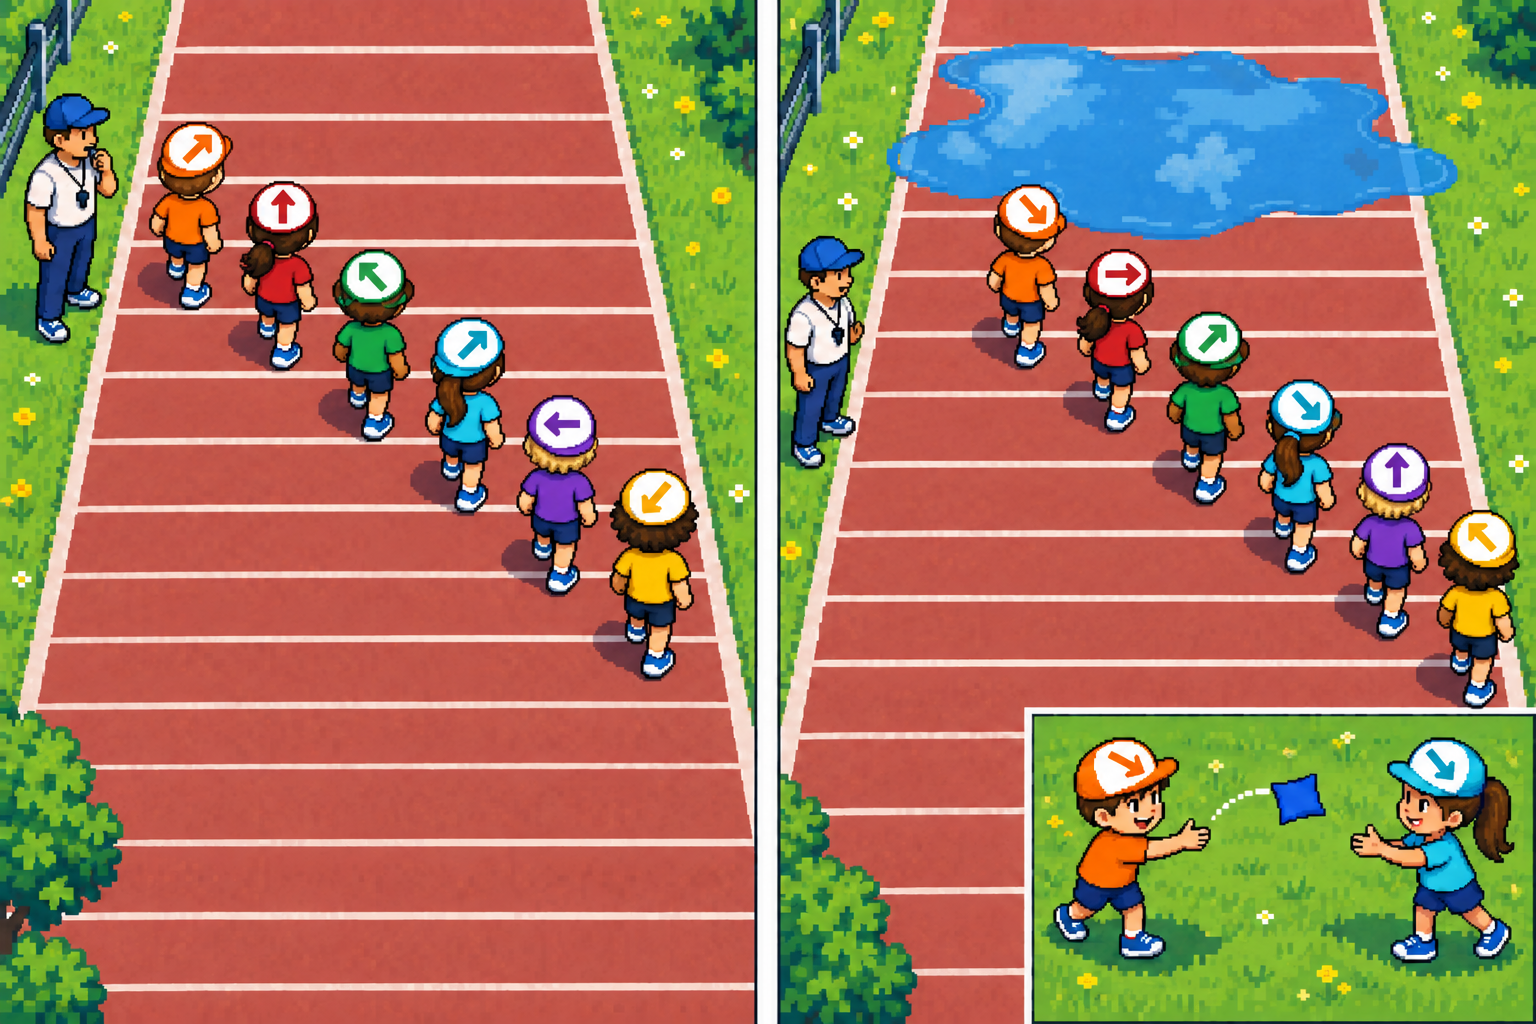
配好对的两个人要互相扔沙包。沙包从手里递出去,用不着跟帽子一起转。
旋转位置编码(RoPE)也是这样:query 和 key 各按自己的位置旋转一个角度再做内积,整体平移不改变结果,value 不参与旋转。
旋转位置编码
旋转位置编码(rotary position embedding,RoPE)让 query 和 key 按各自的位置转过一个角度,再计算内积。故事中帽檐原有的箭头方向对应内容向量,脚下的线决定旋转角度;两者共同决定配合分。传递的沙包对应注意力要汇集的 value,它保持原样。
旋转发生在每个注意力头的 Q/K 投影之后。用列向量 表示旋转前的内容,其中 是从 0 开始的位置, 是单头宽度。为了把通道两两配成平面,要求 为偶数;本节的 value 不旋转。
先看二维。逆时针转过角度 的矩阵是
乘以 后,两项分别为 和 。这两个坐标的平方和仍为 ,所以旋转改变方向,同时保持向量长度。
在位置 使用角度 ,其中 是每移动一个位置增加的弧度:
把二维操作推广到整个注意力头时,将向量分成通道对 ,每对各自旋转。第 对使用的角频率为
是频率基数,RoFormer 的设置取 。频率按单头的通道数分配,因此指数中的 使用单头宽度。每对独立旋转后再拼回原向量,相当于乘一个分块对角矩阵
不同通道对转速不同,给位置差提供多种尺度。频率是预设的,不引入可训练的位置参数。RoPE 放在 Q/K 投影之后,输入端不再叠加原 Transformer 的正弦位置表。RoFormer §3.2给出了二维及分块形式。
相对位置内积
两个位置分别决定旋转角度,而内积中留下的是两者的角度差。这来自旋转矩阵的两条性质:转置使角度取反,同一平面内连续旋转使角度相加。因此
将它代入内积:
结果中的 正是相对位移,其正负号来自列向量和逆时针旋转的约定。保持内容向量不变,将两个位置同时加上偏移量 ,就有 ,内积也保持不变。这对应全班一起换站位后,两顶帽子的夹角保持不变。令 ,两次旋转完全抵消,恢复 。
整个注意力头的内积等于各通道对内积之和,因此二维结论可以逐对使用。记 为第 个通道对,再除以注意力的缩放因子 ,得到分数
即使位置差相同,不同内容向量也可以得到不同分数,正如故事中原本箭头方向不同的孩子会得到不同配合分。RoFormer §3.1与§3.2将这种内积关系作为构造目标。
二维算例
取教学角频率 ,它用于方便手算;标准频率表的第一项是 1。令 ,。旋转后
直接计算旋转后的内积,得到 。按相对位移公式,也可只把 转过相对角度 :,再与 点乘,得到 。
旋转前内积是 4,旋转后为 3,说明这组内容向量的匹配分数随位置差发生了变化。用于注意力时还要除以头宽的平方根,得到 。
把位置改成 ,差值仍为 1,内积仍是 3。两向量的平方范数都为 5,旋转后也保持为 5。
四维算例
四维向量包含两对通道,可以检查不同频率如何共同影响分数。取 ,得到 。令
对 的两对通道分别旋转 1 和 0.01 弧度;对 则旋转 3 和 0.03 弧度:
内积约为 ,除以 后为 。另一条计算路径将 的两对分别旋转 2 和 0.02 弧度,再与原 点乘,得到相同内积。各通道对分别满足二维内积关系,相加后便得到整个向量的相对位置内积。
实现与缓存
实现时要让每个位置、每个通道对取到对应的角度。张量按 排列,其中 是头数;NumPy 数组的末维保存向量坐标,旋转公式沿末维逐对执行。positions 的长度必须等于本次输入长度,正弦余弦表从 广播到 。
import numpy as np

def rope(x, positions, base=10000.0):
    # x: (B, h, T, dh),positions: (T,)
    x = np.asarray(x, dtype=np.float64)
    positions = np.asarray(positions, dtype=np.float64)
    dh = x.shape[-1]
    assert x.ndim == 4 and dh % 2 == 0
    assert positions.shape == (x.shape[2],)
    freq = base ** (-np.arange(0, dh, 2, dtype=np.float64) / dh)
    angles = positions[:, None] * freq[None, :]
    c = np.cos(angles)[None, None, :, :]
    s = np.sin(angles)[None, None, :, :]
    even, odd = x[..., 0::2], x[..., 1::2]
    out = np.empty_like(x)
    out[..., 0::2] = even * c - odd * s
    out[..., 1::2] = even * s + odd * c
    return out

q = np.array([1., 2., 3., 4.]).reshape(1, 1, 1, 4)
k = np.array([2., 1., 0., 1.]).reshape(1, 1, 1, 4)
left = np.sum(rope(q, [1]) * rope(k, [3]))
right = np.sum(q * rope(k, [2]))
np.testing.assert_allclose(left, right, atol=1e-12, rtol=1e-12)
代码用 0::2 和 1::2 配对相邻的偶数、奇数通道。有些实现先存所有第一分量,再存所有第二分量,使用前半/后半配对。两种布局差一个通道置换,加载权重时要连同投影通道的排列一起对上。
逐 token 生成时,KV cache保存已经旋转的 K 和未旋转的 V,供后续 query 复用。若前缀已处理 3 个 token,新 token 就使用位置 3 的角度,以便与缓存中的旧 K 保持正确的位置差。旧 K 已包含各自的位置信息,每一步直接读取即可。
可以用整段计算与逐 token 计算的输出是否一致,检查缓存中的位置处理是否正确。下面比较同一个单层、单头注意力的两条路径。一次计算所有位置时加因果 mask;逐 token 路径每次只查询已追加的缓存。固定教学 Q/K/V,关闭随机操作,两个输出应逐项一致。
# 与上一个代码块连用
rng = np.random.default_rng(7)
q0, k0, v0 = [rng.normal(size=(1, 1, 4, 4)) for _ in range(3)]

def softmax(x):
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

qr, kr = rope(q0, np.arange(4)), rope(k0, np.arange(4))
scores = np.einsum('bhtd,bhsd->bhts', qr, kr) / 2.0
allowed = np.arange(4)[None, :] <= np.arange(4)[:, None]
full = np.einsum('bhts,bhsd->bhtd',
                 softmax(np.where(allowed, scores, -np.inf)), v0)

kc = np.empty((1, 1, 0, 4))
vc = np.empty((1, 1, 0, 4))
outputs = []
for pos in range(4):
    qt = rope(q0[:, :, pos:pos+1], [pos])
    kt = rope(k0[:, :, pos:pos+1], [pos])
    kc = np.concatenate([kc, kt], axis=2)
    vc = np.concatenate([vc, v0[:, :, pos:pos+1]], axis=2)
    s = np.einsum('bhtd,bhsd->bhts', qt, kc) / 2.0
    outputs.append(np.einsum('bhts,bhsd->bhtd', softmax(s), vc))
cached = np.concatenate(outputs, axis=2)
np.testing.assert_allclose(full, cached, atol=1e-12, rtol=1e-12)
最后缓存 K/V 各为 ,输出也是 。多层模型为每一层分别维护缓存;修改旧前缀、旋转频率配置或位置映射后,受影响的缓存要重新构造。
长度外推
把 RoPE 用到训练窗口之外,就是长度外推。旋转公式可以继续代入更大的位置数,但训练只覆盖了有限的位置范围。相对距离增大后,各通道对会出现训练中未见过的旋转角度组合;上下文变长也会改变内容表示、检索目标和干扰项数量。
从二维式子可以看出,固定内容向量时,内积中的正弦和余弦项会随距离振荡。模型要利用这些分数完成长文本任务,就需要适应扩展窗口后的角度变化。
位置插值把更长的目标窗口压回原先的位置尺度。设训练窗口长度为 ,目标窗口长度为 ,使用
例如 ,位置 3000 映为 1500,原先相距 100 的两处映为相距 50。压缩降低了远距离的相位变化,也改变了相邻 token 的角度间隔,所以通常还要配合适配训练和评价。位置插值论文 §2讨论了直接外推的问题与这一映射。
扩展窗口后的评价要覆盖具体任务:长文本困惑度衡量 token 预测,单点检索检查能否找到证据,跨段推理检查能否结合多处信息作答。分别改变文本长度、证据位置和干扰数量,可以检查这些能力怎样变化;保留短上下文任务,则能观察位置压缩对原有使用场景的影响。
位置表和三角函数还涉及数值精度:较大位置在低精度类型中可能无法逐个区分,所以先用足够的精度构造位置与角度,再转换成模型使用的类型。长度增长带来的缓存与计算成本,由分组查询和分块注意力处理。
RMSNorm
位置处理决定了注意力如何比较 token,归一化则控制进入子层的向量尺度。LayerNorm先减均值,再按标准差缩放;RMSNorm 用各分量的均方根直接缩放输入,以控制每个位置的向量幅度。对一个位置的特征向量 ,本章采用带可训练缩放、不带偏置的形式:
是可训练参数, 防止零输入除零。
输入为 时,RMSNorm 只沿最后一维求均方,得到形状为 的统计量,再广播回各通道。每个样本的每个位置单独计算,训练和推理都使用当前输入的统计量,采用同一公式;实现时省去了 BatchNorm 所维护的运行统计量。RMSNorm §4给出均方根归一化及其不变性分析。
取 、,暂忽略微小的 ,均方根为 ,输出为 。同一输入的无仿射 LayerNorm 输出为 。在这组 的设置下,RMSNorm 保留了输入各分量的正负关系,输出均值仍为正。给输入统一加 1,输出会变为 ,说明整体平移会改变归一化结果。
对整体缩放,RMSNorm 则有不同的响应。忽略 时,将非零输入乘正数 ,分子与分母同乘 ,输出保持不变。这解释了它如何消除输入整体幅度的影响;保留有限的 后,这一性质近似成立。
SwiGLU
归一化后的特征进入前馈网络,完成同一位置内部的通道变换。普通 FFN 先把输入扩宽,经过激活函数,再投回原宽度。SwiGLU 在扩宽时生成两条分支:内容分支产生待传递的特征,门控分支根据当前输入为各通道生成乘数。两条分支逐元素相乘后,再投回模型宽度。
SwiGLU 用 SiLU 激活函数计算门控乘数;SiLU 将输入 与它的 sigmoid 值 相乘。下面采用行向量记法,;对批量张量则在最后一维执行同样操作:
是两条上投影, 是下投影, 为中间宽度, 表示逐元素乘法。本例省略偏置。门控乘数的范围由 SiLU 决定,可以为负,也可以大于 1,因此它既能改变内容分支的幅度,也能改变符号。GLU Variants Improve Transformer 的式 (6)给出了该 FFN 形式。
取 ,令
两条投影分别得到 和 。SiLU 后为 ,逐元素相乘得到 ,再乘单位阵即为输出。这一计算只发生在同一位置的通道之间,跨位置通信仍由注意力完成。
前馈网络的参数预算
SwiGLU 使用三个投影矩阵,因此比较参数量时需要一起考虑中间宽度。没有偏置时,普通 FFN 中间宽度 的参数量为 ,SwiGLU 为 。若都使用同一个中间宽度,后者参数更多;要对齐这部分参数预算,应取 ,再按实现需要处理整数及硬件对齐。下面的教学配置取 ,两者恰好都是 384 个参数。
一层的尺寸与参数
将 RoPE、RMSNorm 和 SwiGLU 放回第一节的残差结构,可以逐步检查每次变换的尺寸,以及残差相加是否匹配。取 ,使用标准多头注意力、无偏置投影和两个 RMSNorm:
| 运算 | 输入或权重 | 输出 |
|---|---|---|
| RMSNorm 1 | ,缩放 | |
| Q/K/V 投影 | 三个 矩阵 | 各 |
| 拆头并旋转 Q/K | 2 头,头宽 4 | Q/K/V 各 |
| 因果注意力 | 分数 | |
| 拼头、输出投影、残差 | ||
| RMSNorm 2 | 缩放 | |
| 两条上投影 | 各 | |
| SiLU、逐元素相乘、下投影 | ||
| 残差相加 | 加回 |
注意力投影共 个参数,SwiGLU 有 个,两个归一化共 个,总计 656 个。这个总数只统计一个解码器层,嵌入、堆栈末端归一化及词表头需另外计算。RoPE 使用预设频率,训练参数量为零;K/V 缓存由当前输入计算得到,所占空间随序列长度增长。
前馈分支还可以按 token 选用不同的专家,被选中的专家内部做的仍是这样的通道变换。