
KV cache通过保存旧 token 的 key 和 value,省去了它们的重复投影。随着序列变长,需要保存和读取的历史 K/V 也越来越多。训练长序列时,每个注意力头还会产生 的分数矩阵,占用临时存储。缩小 K/V 缓存和减少中间矩阵的存取,分别对应这两处开销。
计算这些开销时,本章把一个注意力头的 query/key 宽度及 value 宽度都取为 。 为一个批次中的序列数, 为当前序列长度, 为层数。
分组查询注意力
分组查询注意力通过让几个 query 头共用一套 K/V 来缩小缓存。标准多头注意力为每个 query 头保存独立的 K/V;改成共享后,各个 query 仍用自己的查询向量与 key 比较,因此可以从同一组 value 中读出不同的结果。
先将 query 头均匀分组。设 query 头数为 ,K/V 头数为 ,满足 可被 整除,每组便有 个 query 头。
分组后的 K/V 投影只需生成每组共用的向量。设输入特征宽度为 ,输入 中每个 token 以行向量表示,分别右乘以下投影矩阵:
投影后,把特征轴拆成头数与头宽,并把头数轴移到序列轴之前,得到 Q 的形状 和 K/V 的形状 。对从 0 开始编号的 query 头 ,用 找到所属组,再读取该组的 K/V:
是因果或 padding 掩码,用来排除当前位置不可见或用于补齐长度的位置。softmax 沿 key 位置轴归一化,得到当前 query 对各个 value 的加权比例;加权求和后, 的形状为 。各头输出拼成 ,再由输出矩阵投影回宽度 。
共享 K/V 后,位置编码仍作用于参与比较的 query 和 key。若采用旋转位置编码,所有 query 头及每个实际保存的 key 头分别按位置旋转。K/V 头数决定了共享的范围:
| K/V 头数 | 名称 | 共享关系 |
|---|---|---|
| 多头注意力(MHA) | 每个 query 头独享 K/V | |
| 分组查询注意力(GQA) | 每组 query 共用 K/V | |
| 多查询注意力(MQA) | 所有 query 共用 K/V |
GQA §2.2用分组方式统一了这三个配置。从 MHA 改为共享 K/V 会改变投影结构,需要通过训练让各个 query 头适应共用的 key 和 value。
头与投影
用一组小尺寸可以看清分组后的投影。取 ,Q 投影矩阵为 ,K/V 投影各为 。query 头 0、1 读取 K/V 头 0,query 头 2、3 读取 K/V 头 1。四个 query 头各输出宽度为 2 的向量,拼头输出宽度仍为 8,输出投影为 。
参数量的减少来自 K/V 投影矩阵变窄。省略偏置,按 Q、K、V、输出投影的顺序计数,这组注意力有 个投影参数;同尺寸 MHA 为 256 个,MQA 为 160 个。query 数量保持不变,每个 query 仍要与可见的历史 key 比较。
共享 K/V 的两个 query 可以给历史位置分配不同的权重。为方便计算,另取 ,两个历史 key 为 ,value 为 ,两个 query 分别是 0 和 1。query 为 0 时,分数为 ,两个 value 各占一半,输出为 15。query 为 1 时,softmax 权重约为 ,输出约为 17.310586;它给第二个 value 分配了更高的权重。
缓存字节
缓存大小取决于实际保存了多少个 K/V 头。每层 K 和 V 各有 个标量;若每个标量占 字节,再乘上层数,全模型缓存为
最前面的 2 来自 K 与 V 各存一份。固定层数、批量、长度和头宽后,缓存随 K/V 头数成比例变化,因此与 MHA 相比,缓存比例为 。
沿用 ,另取 ,得到
这对应每层 48 字节。保持其他尺寸不变,长度增长到 4 时,全模型缓存增至 128 字节。回到长度为 3 的条件,MHA 占 192 字节,MQA 占 48 字节。
实现时,缓存应保持 的形状,读取时通过分组索引或支持分组的算子复用。若把每个共享头复制 份并长期缓存,缓存头数就回到了 query 头数,无法节省上述空间。Stanford CS336 推理讲义的缓存核算与GQA部分也将 K/V 占用与参数占用分别计算。
K/V 缓存缩小后,注意力计算还会产生分数与概率矩阵。接下来考虑怎样边计算边汇总,让这些中间结果只占用一小块临时空间。
补给站放在哪
城市马拉松办完,志愿者队要给明年加一个补给站。三千多张跑者反馈表堆在仓库里,每张写一个公里数,再打一个一到十的分,表示有多想在那里喝到水。规则早定好了:补给站放在所有公里数的加权平均处,分数每高一分,那张表的分量翻一倍。
去年算这件事的是阿宽。他借了体育馆,想把表全摊在地板上,先找出最高分,再一张张算分量、加总。地板摆不下,他抱着成箱的表在仓库和体育馆之间来回跑,花了两天,大半时间在路上。
今年只有帐篷里一张折叠桌,桌面放得下一箱。林姐在一张小纸条上记三个数:到目前为止的最高分;按这个最高分折算的总分量,最高分的表算一份,每低一分减半;每张表的公里数乘上分量后的累加。一箱算完,更新这三个数,箱子搬回去,再拿下一箱。
第五箱里冒出一张比之前最高分还高三分的表。原来的“一份”现在只值八分之一份,林姐没有回头翻前四箱,把纸条上的总分量和累加各除以八,接着往下算。
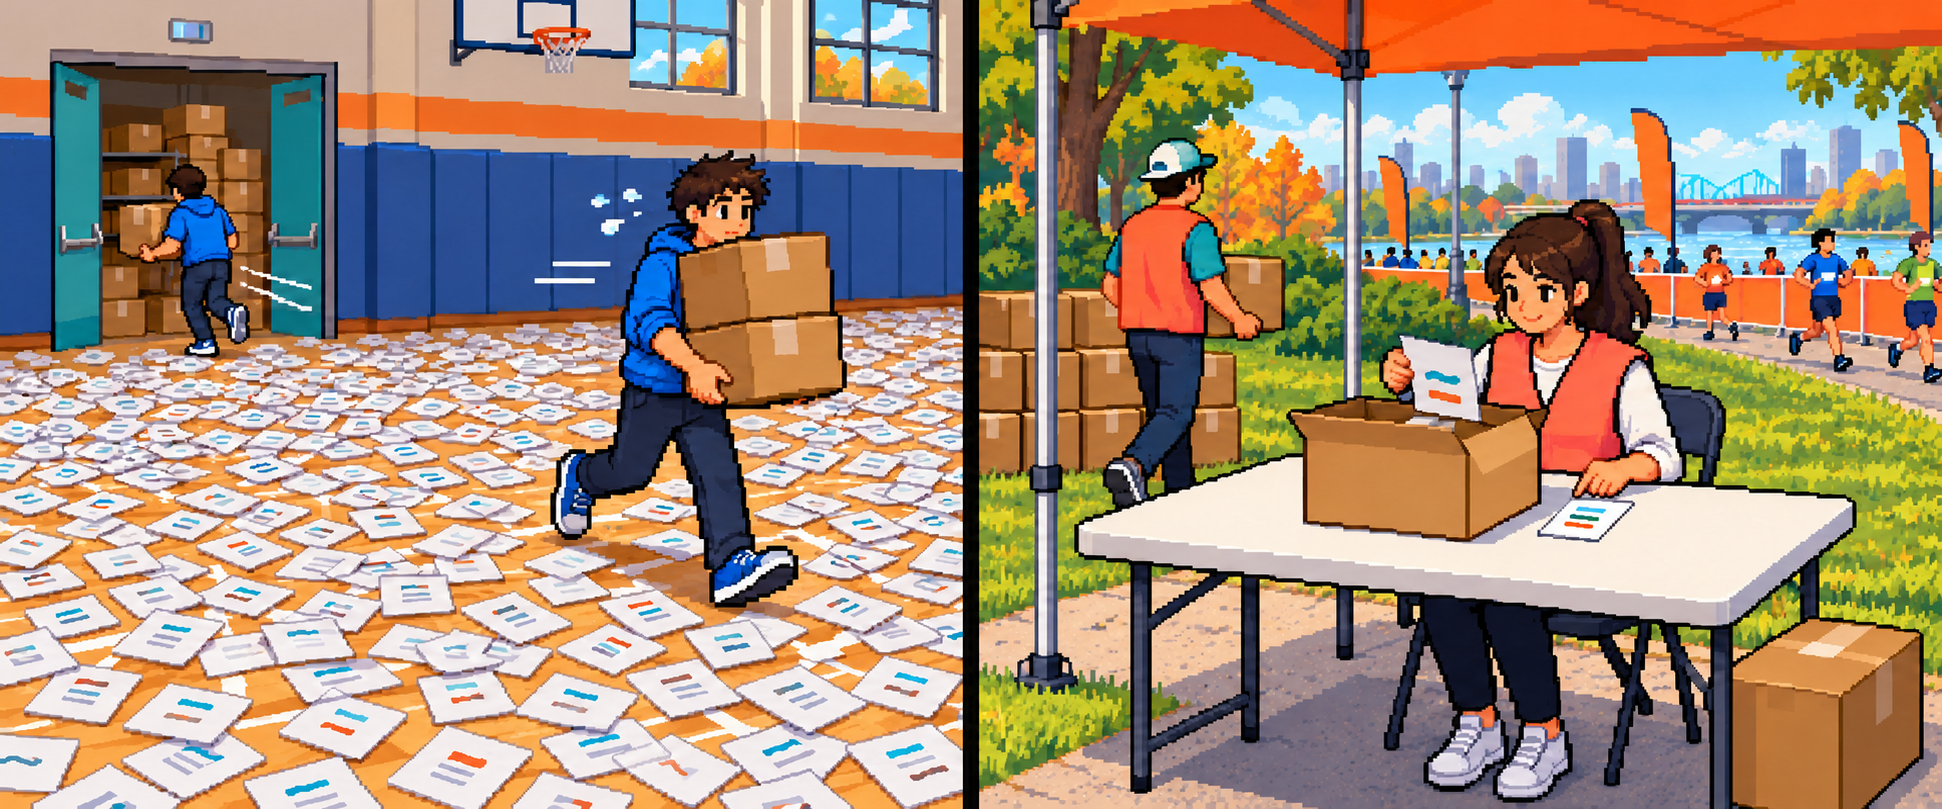
最后一箱算完,累加除以总分量,得出三十一点四公里。阿宽不放心,照去年的办法在体育馆又算一遍,结果一位不差。每张表照样都算了一次,省下的是地板和来回搬箱子的路。
FlashAttention 计算注意力也是分块的:每次只把一小块 key/value 读进快速存储,用在线 softmax 记住最大值、归一化和与加权和,遇到更大的分数就把旧的累计量重新缩放。
分块注意力
注意力的最终输出是 value 的加权和;要算出这个加权和,普通实现会先保存所有位置对的分数和概率。对单个头,省略批量维度,设 ,计算过程为
保存分数, 保存归一化后的权重,两者都是 ;最终输出 的形状为 。GPU 的高带宽显存(HBM)容量大,片上 SRAM 容量较小、访问更快。如果把完整的 写回 HBM,再读出做 softmax,随后又存取 ,就会为这些中间矩阵付出大量搬运开销。
FlashAttention 将 Q、K、V 分块载入片上存储,在块内算分数,并把各块的贡献累计到输出中。这样做需要解决一个问题:softmax 的分母是所有可见 key 的指数分数之和,各块必须使用统一的归一化尺度。故事中林姐用小纸条保存累计结果,最高分变化时就重新折算旧的分量;分块注意力也通过保留统计量来完成这种折算。FlashAttention §3.1与算法1给出了具体方法。
在线 softmax
在线 softmax 在读入新分数时更新累计量,读完所有块后再完成归一化。固定一条 query,设第 个 key 的缩放分数为 ,value 向量为 。对已经处理过的位置集合 ,保存三个量:
是已读分数的最大值, 是按这个最大值折算后的权重总和, 是 value 乘权重后的累计和。它们分别对应补给站故事中的最高分、总分量和公里数的加权累计;公式使用自然指数 来折算权重。 为标量, 为宽度 的向量,最终输出为 。
减去最大值可以让指数的参数不大于 0,避免大正数溢出。由于分子与分母都乘了同一个缩放因子,最终的加权平均保持不变。
读入新块时,先把新旧累计量换到同一基准,再相加。设新块的位置集合为 ,块最大值为 ,新的共同基准便是 。旧项从基准 改成 时,每项都多乘 ,于是
更新式把旧位置与新位置的求和分开:旧位置的贡献已包含在 中,只需整体缩放;新位置的贡献则逐项算入。这正是处理完一块后可以丢弃该块分数的原因。
累计从 开始,遇到第一块有效 key 后建立有限的最大值。全被 mask 的块应跳过,否则计算 会产生非数。
同时处理多条 query 时,每条 query 各自维护一组统计量。若一块包含 条 query, 的形状为 , 为 。设 key 块大小为 ,当前分数块便是 ;将它的贡献合入统计量后,就可以复用这块空间。
两块算例
用四个位置可以核对分块累计与一次性计算是否一致。令四个分数为 ,其中 为自然对数,标量 value 为 。一次性 softmax 得到权重 ,输出
分成两块后,先处理前两个位置:,指数权重为 ,所以 。
第二块带来了更大的分数,需要先缩放旧累计量。第二块最大值为 ,新的基准是 ,旧累计量需乘 。新块的指数权重为 ,于是
各块的权重总和不同,因此不能把各块的输出等权平均。若先单独归一化,两块的输出分别为 与 ,简单平均约为 2.619048;局部归一化丢掉了各块分母的相对大小,因而偏离了正确结果 3。
下面的代码把一条 query 的累计过程写成循环:m 保存最大值,total 对应权重总和,acc 对应 value 的加权累计。传入的分数已完成缩放和 mask,允许用负无穷屏蔽位置,并要求至少一个有效 key。
import numpy as np

def online_attention(scores, values, block=2):
    scores = np.asarray(scores, dtype=np.float64)
    values = np.asarray(values, dtype=np.float64)
    assert scores.ndim == 1 and values.ndim == 2
    assert values.shape[0] == scores.size and block > 0
    assert np.all(np.isfinite(scores) | np.isneginf(scores))
    assert np.all(np.isfinite(values))
    m, total = -np.inf, 0.0
    acc = np.zeros(values.shape[1])
    for start in range(0, scores.size, block):
        s = scores[start:start+block]
        v = values[start:start+block]
        keep = np.isfinite(s)
        if not keep.any():
            continue
        s, v = s[keep], v[keep]
        new_m = max(m, s.max())
        old_scale = 0.0 if total == 0.0 else np.exp(m - new_m)
        weights = np.exp(s - new_m)
        acc = old_scale * acc + np.einsum('t,td->d', weights, v)
        total = old_scale * total + weights.sum()
        m = new_m
    if total == 0.0:
        raise ValueError('query has no visible key')
    return acc / total

scores = np.log(np.array([1., 2., 3., 4.]))
values = np.arange(1., 5.)[:, None]
np.testing.assert_allclose(online_attention(scores, values), [3.])
FlashAttention 将这种累计计算与块的加载、算子融合结合起来,减少显存读写。训练时还会保存必要统计量,在反向阶段重算局部分数,让整张概率矩阵无需一直保留到反向传播。
资源变化
分块计算把分数的临时存储从整张矩阵缩小到当前块。取 ,覆盖所有头的完整分数张量有 个元素,float32 占 16 MiB。若 query/key 块都为 64,单头当前分数块只有 4096 个元素,占 16 KiB。安排块大小时,还需为片上的 Q/K/V 块和累计输出留出空间。
分块减少了中间矩阵存储和 HBM 读写,稠密注意力对全部可见位置对的比较仍要进行,主要算术量为 。各块累计得到的是同一个 softmax 注意力结果;浮点运算顺序变化可能产生小误差。原论文定理1及§3.2分别讨论算术量与 IO 复杂度。
GQA 与 FlashAttention 可以一起使用:GQA 减少需要保存的 K/V 头数,FlashAttention 则安排这些 K/V 的分块读取和计算。两者配合后,历史 K/V 的长度仍随序列增长。要让流式推理的记忆保持固定大小,还可以改变保存历史的方式。
状态空间模型
状态空间模型把已经读过的输入汇总进一个固定大小的状态,每到一个新 token 就更新它。这沿用了递归状态的思路。先考虑标量输入 、标量输出 和状态 ,其中 表示当前步, 是状态维数。离散线性状态空间模型(state space model,SSM)的一种基本形式是
状态更新由保留旧信息和写入新信息两部分组成: 变换旧状态, 把当前输入映射到状态空间,再由 从更新后的状态读出输出。三个矩阵的形状分别为 、、。
横线表示这些系数已用于离散步进,也就是可以按 token 一步步更新。给定系数后,当前步只需旧状态与新输入;在学习模型里,这些系数由可训练参数构造。
用一个状态数就能看到旧输入如何影响后续输出。取 ,输入依次为 :
| 步骤 | 状态计算 | 输出 |
|---|---|---|
| 1 | 2 | |
| 2 | 1 | |
| 3 | 1.5 |
每一步都把旧状态乘以 0.5,再加上当前输入,因此旧输入的影响不断衰减,推理时只需保留一个状态数。但同样的衰减也会发生在无关输入到来时:如果第二个输入是应当忽略的占位,旧状态仍会减半。要让模型更少受到这类输入的影响,保留旧状态的程度就需要随输入变化。
选择性状态
Mamba 的选择性 SSM 让当前输入参与决定状态如何更新和读出。具体来说,步长、输入映射和输出映射随当前输入变化,再用适合硬件的扫描算法计算整段递推。
步长控制连续状态转移如何转换成当前一步的离散转移。原论文中的连续状态转移参数 是固定的可训练参数,而步长与输入有关,因此得到的离散转移也随输入变化。Mamba §3.2及算法2列出了这些量的尺寸与依赖。
用一个标量门控递推,可以直接看出输入怎样控制保留与写入。令门值 表示当前输入的写入比例,旧状态的保留比例便是 :
由当前输入的可训练函数产生:值越小,写入的新输入越少,保留的旧状态越多。原论文 §3.5.1 给出了一个标量 SSM 与该门控形式的联系。
沿用初始状态 和输入 ,直接给定用于演示的门值 ,得到
减小第二步的门值,使输入 0 到来时能保留更多旧信息。若三个门都为 0.5,状态依次为 ;第二步的门降到 0.1 后,该步状态从 0.5 变为 0.9,第三步也继承了这部分差异。
完整的 Mamba 将状态扩展到多个通道,并结合投影、局部卷积与门控分支。通道数和每个通道的状态维数共同决定了递归状态需要多少空间。
设一层模型的内部宽度为 ,即有 个通道,每个通道保存 个状态分量。批量为 时,递归状态共含 个标量;固定这些尺寸后,状态大小就不随已读长度 增长。
递推的计算量还取决于状态转移矩阵的结构。采用对角或结构化状态转移时,这部分扫描的算术量可为 ;若每步使用任意稠密的 矩阵,矩阵与状态相乘就会带来 成本。几种方法保存和使用历史信息的方式可归纳如下:
| 方法 | 推理时保留什么 | 新输入怎样用过去信息 |
|---|---|---|
| MHA/GQA | 各层历史K/V,随T增长 | 当前query分别比较历史key |
| FlashAttention | 不改变模型的持久缓存约定 | 分块计算同一注意力结果 |
| 递归SSM | 固定尺寸状态,完整模块还可能有短卷积缓存 | 将过去压进状态,再更新和读出 |
注意力保存各位置的 K/V,便于当前 query 逐个比较历史 key;SSM 则把历史汇总进有限维的状态,适合用固定大小的记忆持续处理输入。选择性状态让模型根据当前输入调整保留与写入的比例,使这份有限的记忆能有所取舍。