决策树
决策树(decision tree)用一系列特征条件将样本分流,最终在叶节点输出类别或数值。训练会从数据中选择条件与切分位置。
例如,按花瓣长度分开样本,再按宽度继续划分,沿分支到达叶节点,得到预测类别。
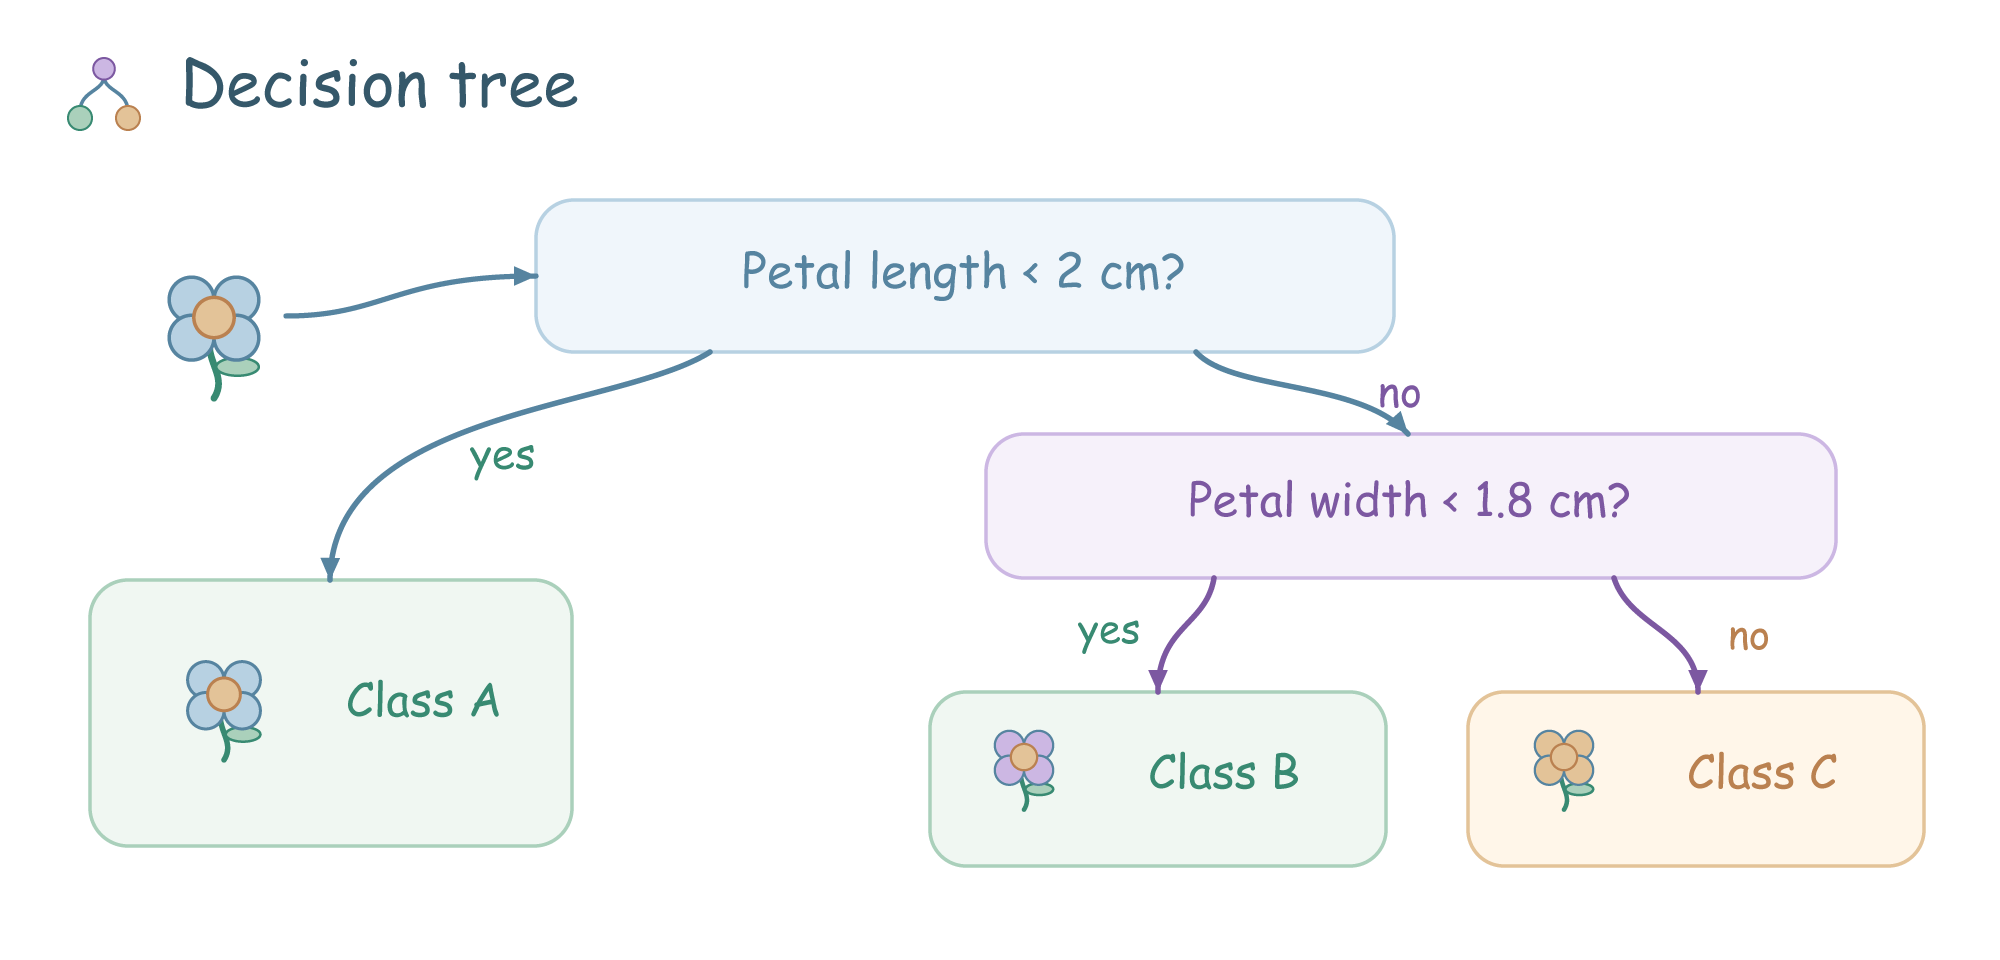
分类树选择切分时,会让各分支中的样本尽量属于同一类。
树过深容易拟合训练数据中的偶然波动。练习:在葡萄酒分类项目的数据上,用验证集比较 max_depth=2 和 max_depth=5 的表现。
随机森林
随机森林(random forest)组合多棵通过随机抽样训练的决策树。各树通常对样本有放回抽样,每次分裂也只考虑随机抽取的部分特征,从而产生差异。
预测时汇总各树的结果。在 scikit-learn 中,分类森林平均各树的类别概率,再选择概率最高的类别;回归森林平均预测数值。这种汇总可以降低单棵树的波动。
练习:用 RandomForestClassifier(n_estimators=100, random_state=42) 与单棵树比较,保持相同的数据划分,记录验证成绩和训练耗时。
K-means 聚类
聚类(clustering)按特征相似程度分组,不使用已知类别标签。K-means(K 均值)用 K 个中心表示各组,交替分配样本和更新中心。
得到的组号只是编号,与物种等真实类别没有自动对应关系。
K-means 需要指定组数 K。算法交替执行两步:把各点分给最近的中心,将中心移动到组内点的平均位置。它优化的是点到所属中心的距离平方和,适合较紧凑的团状分布,对离群点和特征尺度较敏感。
例如六个一维点 1、2、3、8、9、10,K=2,初始中心为 1 和 8。分组后,两组分别为 [1, 2, 3] 和 [8, 9, 10],更新后的中心为 2 和 9。
练习:对鸢尾花的测量值做聚类,用真实类别对照结果。比较不同初始状态和特征缩放对分组的影响。
切分标准与树的约束
不纯度(impurity)衡量节点内类别的混杂程度,切分倾向于降低子节点的不纯度。剪枝(pruning)删除收益较小的分支,以限制树的复杂程度。
基尼不纯度为 , 是该节点第 类的比例。两类各半时为 0.5;全部同类时为 0。算法比较候选切分,选择子节点按样本数加权后不纯度下降较多的方案。
另一个标准是熵:切分前后的熵下降量称为信息增益。回归树则可按平方误差下降选择切分,叶节点预测训练目标的均值。
max_depth 限制层数,min_samples_leaf 要求每个叶节点保留足够样本。树通常不需要标准化,但单棵树的边界容易随数据波动;回归树也很难对训练目标范围之外的趋势做外推。
梯度提升树
梯度提升树(Gradient Boosting Decision Tree,GBDT)依次训练多棵树,每棵新树拟合当前损失的负梯度,再将预测加到已有模型上。平方损失下,这相当于拟合当前残差。
例如真实值为 10、旧模型预测 7,残差为 3;新树预测修正量 2,学习率为 0.1,则更新后的预测为 。
分类也能用梯度提升逐步改进得分,再转换成概率。
树的数量、深度和学习率共同决定能力。学习率较小通常需要更多树;验证成绩停止改善时,可以提前停止。不同的提升树实现,在切分、类别特征处理和训练效率等方面各有设计。
自助采样集成、投票与堆叠
集成学习(ensemble learning)组合多个模型的预测。Bagging 是 Bootstrap Aggregating(自助采样聚合)的简称;Voting 指投票,Stacking 是 Stacked Generalization(堆叠泛化)的简称。
模型需要有一定差异;把同一个模型复制十遍,预测不会更可靠。
| 方法 | 组合方式 | 主要考虑 |
|---|---|---|
| Bagging | 对有放回抽样的数据分别训练,再平均或投票 | 降低高方差模型的波动;随机森林还随机选择特征 |
| Boosting | 后续模型修正已有模型的不足 | 顺序训练,控制复杂度以避免拟合噪声 |
| Voting / Averaging | 直接组合不同模型的类别或数值预测 | 各模型的错误是否互补 |
| Stacking | 用一个新模型学习如何组合基础模型输出 | 组合器需要使用折外预测训练 |
折外预测是某条样本由“训练时没见过它”的基础模型给出的预测。若组合器使用基础模型在自身训练集上的成绩,很容易高估某个模型,形成泄漏。
层次聚类、高斯混合、主成分分析与异常检测见无监督学习。