线性回归
线性回归(linear regression)用输入的加权和加上截距来预测数值。只有一个输入时,写成 。
是输入, 是预测, 决定斜率, 决定截距。训练根据已有样本确定 和 ;预测则把新输入代入公式。
例如,虚构的三条记录为:学习 2、4、6 小时,对应分数 60、70、80。直线 穿过这三个点,输入 3 小时得到 65 分。这是预测关系,不能据此认定增加学习时长一定能提高分数。
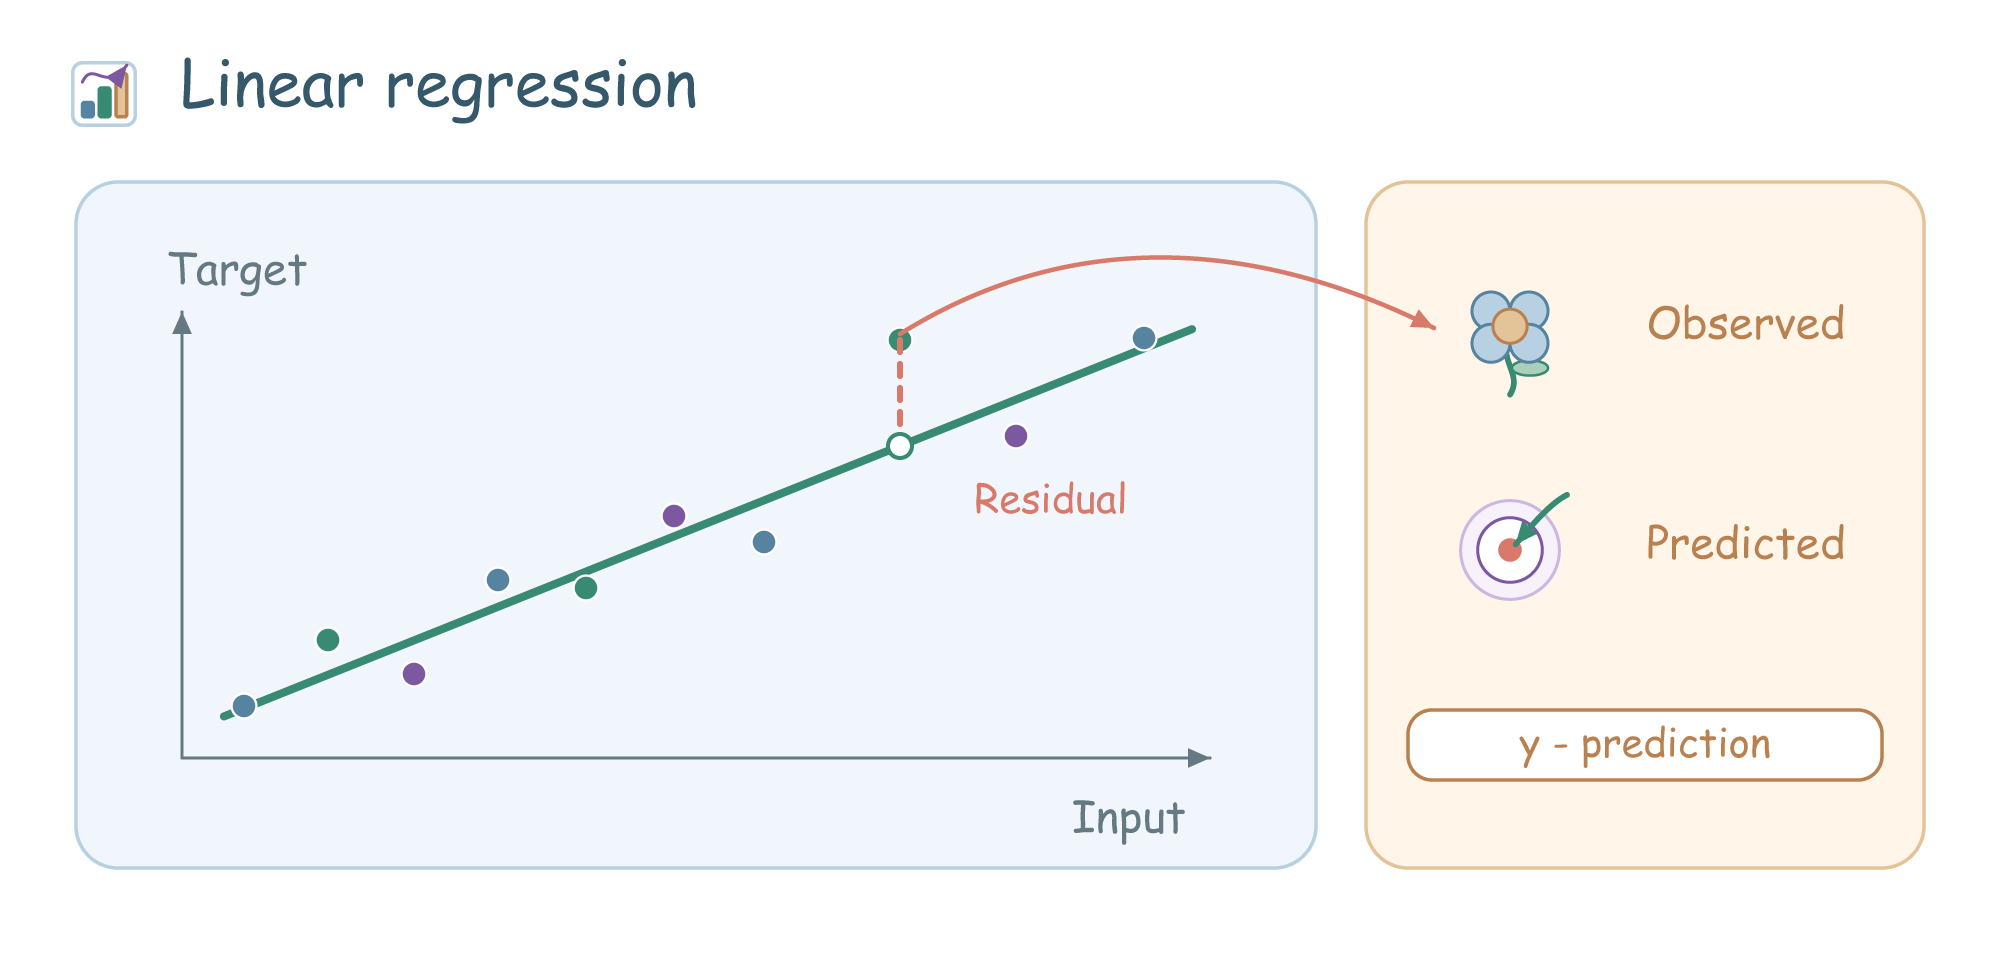
残差取“实际值减预测值”,对应同一输入位置上点与直线的竖直差。
损失函数
损失函数(loss function)用数值衡量预测与实际结果的差异。均方误差(Mean Squared Error,MSE)将误差平方后平均;平均绝对误差(Mean Absolute Error,MAE)将误差取绝对值后平均。
MSE 对大误差的惩罚更重;MAE 的单位与预测目标相同。
actual = [60, 70, 80]
predicted = [62, 68, 86]
errors = [p - y for p, y in zip(predicted, actual)]
mse = sum(e ** 2 for e in errors) / len(errors)
mae = sum(abs(e) for e in errors) / len(errors)
print(round(mse, 2), round(mae, 2))  # 14.67 3.33
练习:将最后一个预测从 86 改为 92,比较 MSE 和 MAE 的变化。
梯度下降
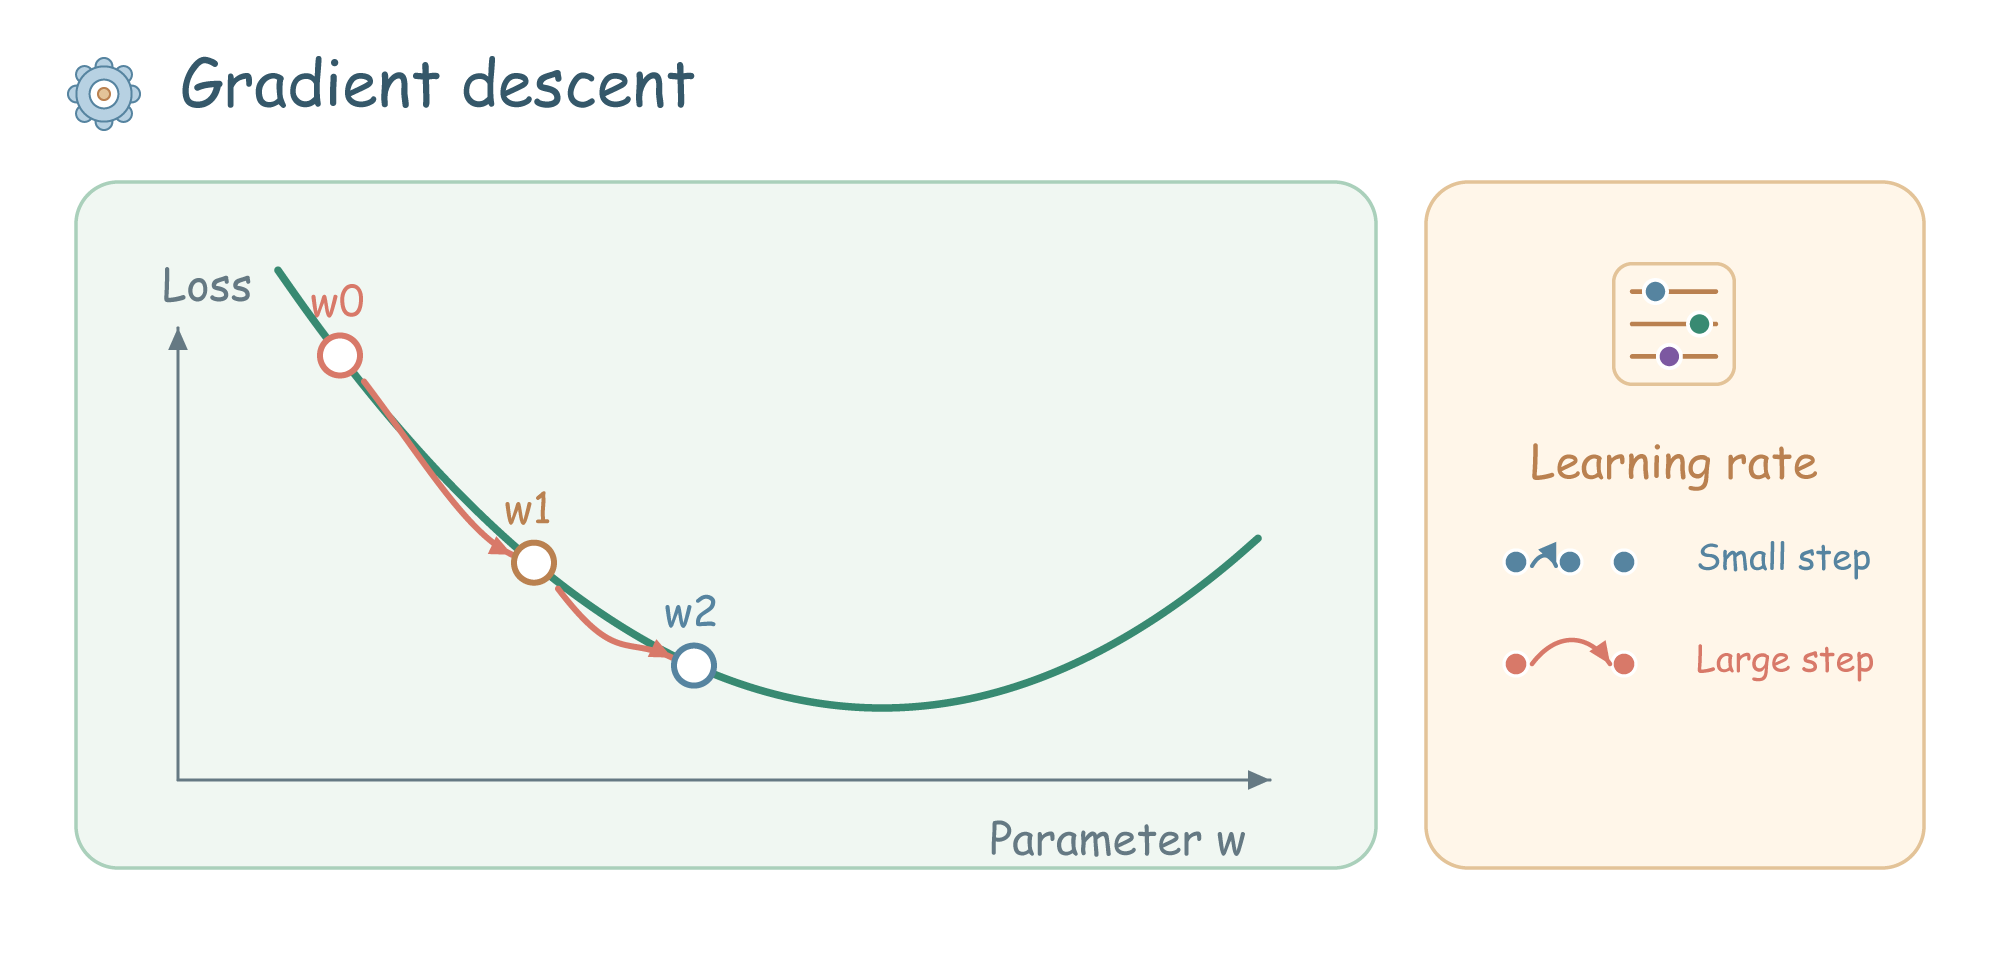
导数描述一个量发生微小变化时,另一个量如何变化。固定其他参数求得的导数叫偏导数;将各参数的偏导数排成向量,就是梯度。梯度下降(gradient descent)沿梯度反方向更新参数,以减小损失。
梯度指向当前位置上升最快的方向。学习率控制更新幅度:过小会使收敛缓慢,过大可能引起振荡或发散。
以 为例,导数为 。从 出发,学习率取 ,一次更新得到 ,损失从 16 降到 10.24。
逻辑回归
逻辑回归(logistic regression)是分类模型。二分类时,它将输入的线性得分通过 sigmoid 函数转换为正类的概率估计,再用阈值得到类别。
模型计算 ,再计算 。得分为 0 时,概率为 0.5;得分越大,概率越接近 1。训练常用二元交叉熵 , 取 0 或 1,它惩罚分配给真实类别过低的概率。
例如三封邮件的垃圾邮件概率估计为 0.2、0.6、0.8。阈值取 0.5 时,后两封被拦截;取 0.7 时,只有最后一封被拦截。阈值会影响误拦和漏拦的数量,需要结合精确率与召回率评价。
特征缩放
特征缩放(feature scaling)调整各列数值的尺度。标准化(standardization)是一种常用方式:减去训练均值,再除以训练标准差。
不同特征的数值尺度可能相差很大。缩放会影响梯度下降的优化过程,也会影响正则化对不同特征的约束。
训练数据的均值为 4、标准差为 2 时,数值 6 转换为 。
均值和标准差只从训练集计算,验证集与测试集沿用这套数值。交叉验证时,每一折分别拟合预处理,具体见数据泄漏。
向量与多特征回归
向量是一组有序数值;矩阵是按行列排列的数值。两个等长向量的点积,将对应位置相乘后相加。多特征线性回归用特征向量与权重向量的点积产生预测。
例如 表示学习 2 小时、完成 3 次练习,权重 。点积为 ,加截距 50 得到预测 66。
把多条记录逐行排放得到矩阵 。若有 条记录、 个特征, 的形状是 , 有 个元素; 同时算出 个预测。转置符号 表示交换行与列。
加入 等新特征,可以拟合弯曲关系。模型对权重仍是线性的,但高次项过多时容易过拟合。高度相关的特征也会让单个系数不稳定,因此不能仅凭系数大小认定某个因素的重要性。
Softmax 与交叉熵
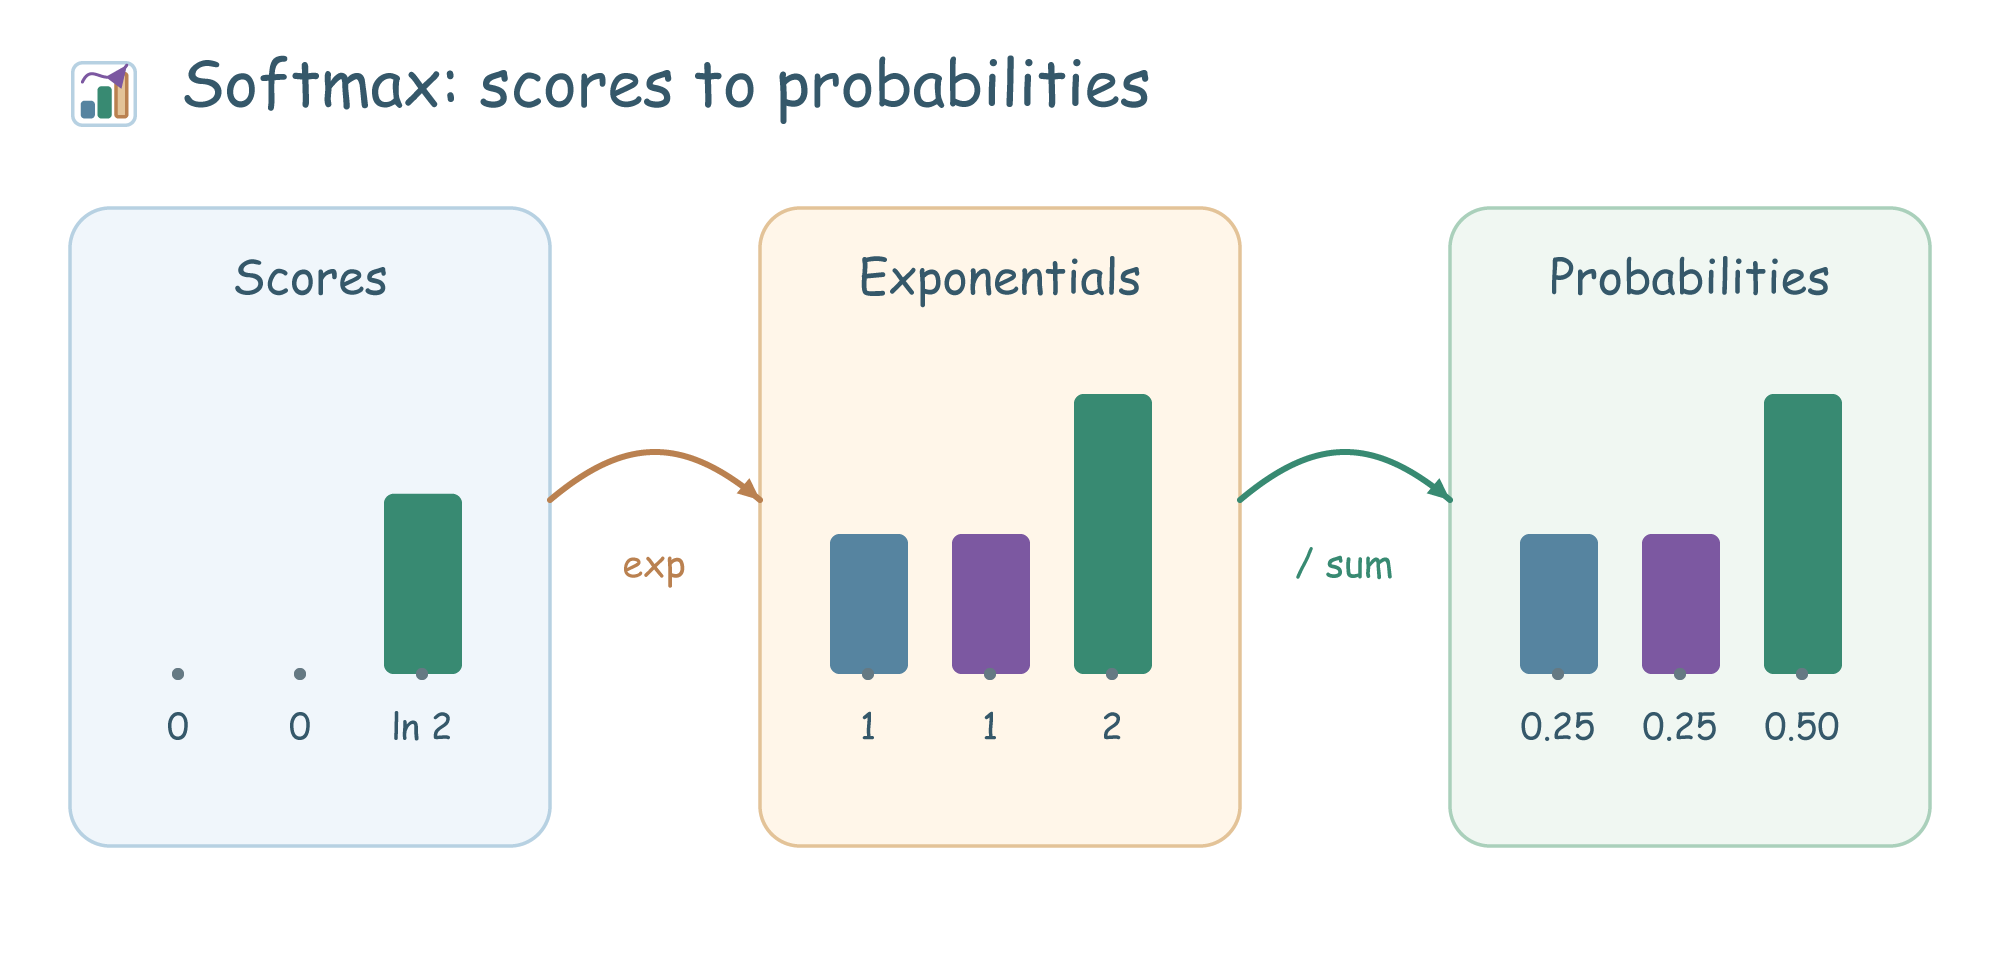
Softmax 把多个类别得分转换为和为 1 的概率。交叉熵(cross-entropy)衡量预测分布与真实分布的差异;对标签明确的分类样本,它等于真实类别预测概率的负对数。
三个互斥品种对应三个得分 ,第 类的概率为:
例如得分为 时,指数为 ,概率就是 。预测选择概率最高的一类。实际代码通常先减去最大得分,避免指数溢出;结果不变。
对一个类别明确的样本,交叉熵损失为 。真实类别的概率从 0.1 提高到 0.8,损失从约 2.30 降到 0.22。信心很高却猜错,会产生很大的损失。
熵 衡量分布的不确定性。抛公平硬币比每次都得到正面的硬币更不确定。交叉熵用预测分布去描述真实分布;交叉熵减去真实分布的熵,得到 Kullback–Leibler 散度(KL 散度),衡量这两个分布的差异。KL 不对称,不能当成普通几何距离。
互斥分类适用 Softmax;一张图片可以同时有“猫”和“室内”等多个标签时,通常为各标签分别使用 sigmoid。
L1、L2 与正则化强度
正则化(regularization)通过约束模型复杂度减少过拟合。L1 正则化惩罚权重绝对值之和;L2 正则化惩罚权重平方和。它们分别对应向量的一范数、二范数平方,名称中的数字表示范数阶数。
训练目标为 ,在平均损失之外加入参数惩罚。 越大,约束越强;它通过验证数据选择。
岭回归(Ridge regression)使用惩罚 。较大的权重受到更重约束,通常将权重缩小,但不会精确变成零。多个相关特征共同参与预测时,L2 有助于稳定结果。
Lasso(Least Absolute Shrinkage and Selection Operator,最小绝对收缩与选择算子)使用惩罚 。优化结果可以让部分权重精确为零,从而得到稀疏模型。相关特征很多时,留下哪一个可能随数据变化。
弹性网(Elastic Net)结合 L1 与 L2,兼顾稀疏性和稳定性。除了总体强度,还需选择两种惩罚的比例。
例如同样的训练误差下,权重 的 L2 惩罚为 2, 为 4。正则化偏好前者。特征单位不同会改变惩罚的含义,因此这些模型通常配合标准化。截距一般不参与上述惩罚。