准确率、精确率与召回率
准确率(accuracy)是全部样本中预测正确的比例;精确率(precision)是预测为正类的样本中真正正类的比例;召回率(recall)是真正正类中被模型找到的比例。正类是当前重点检测的类别。
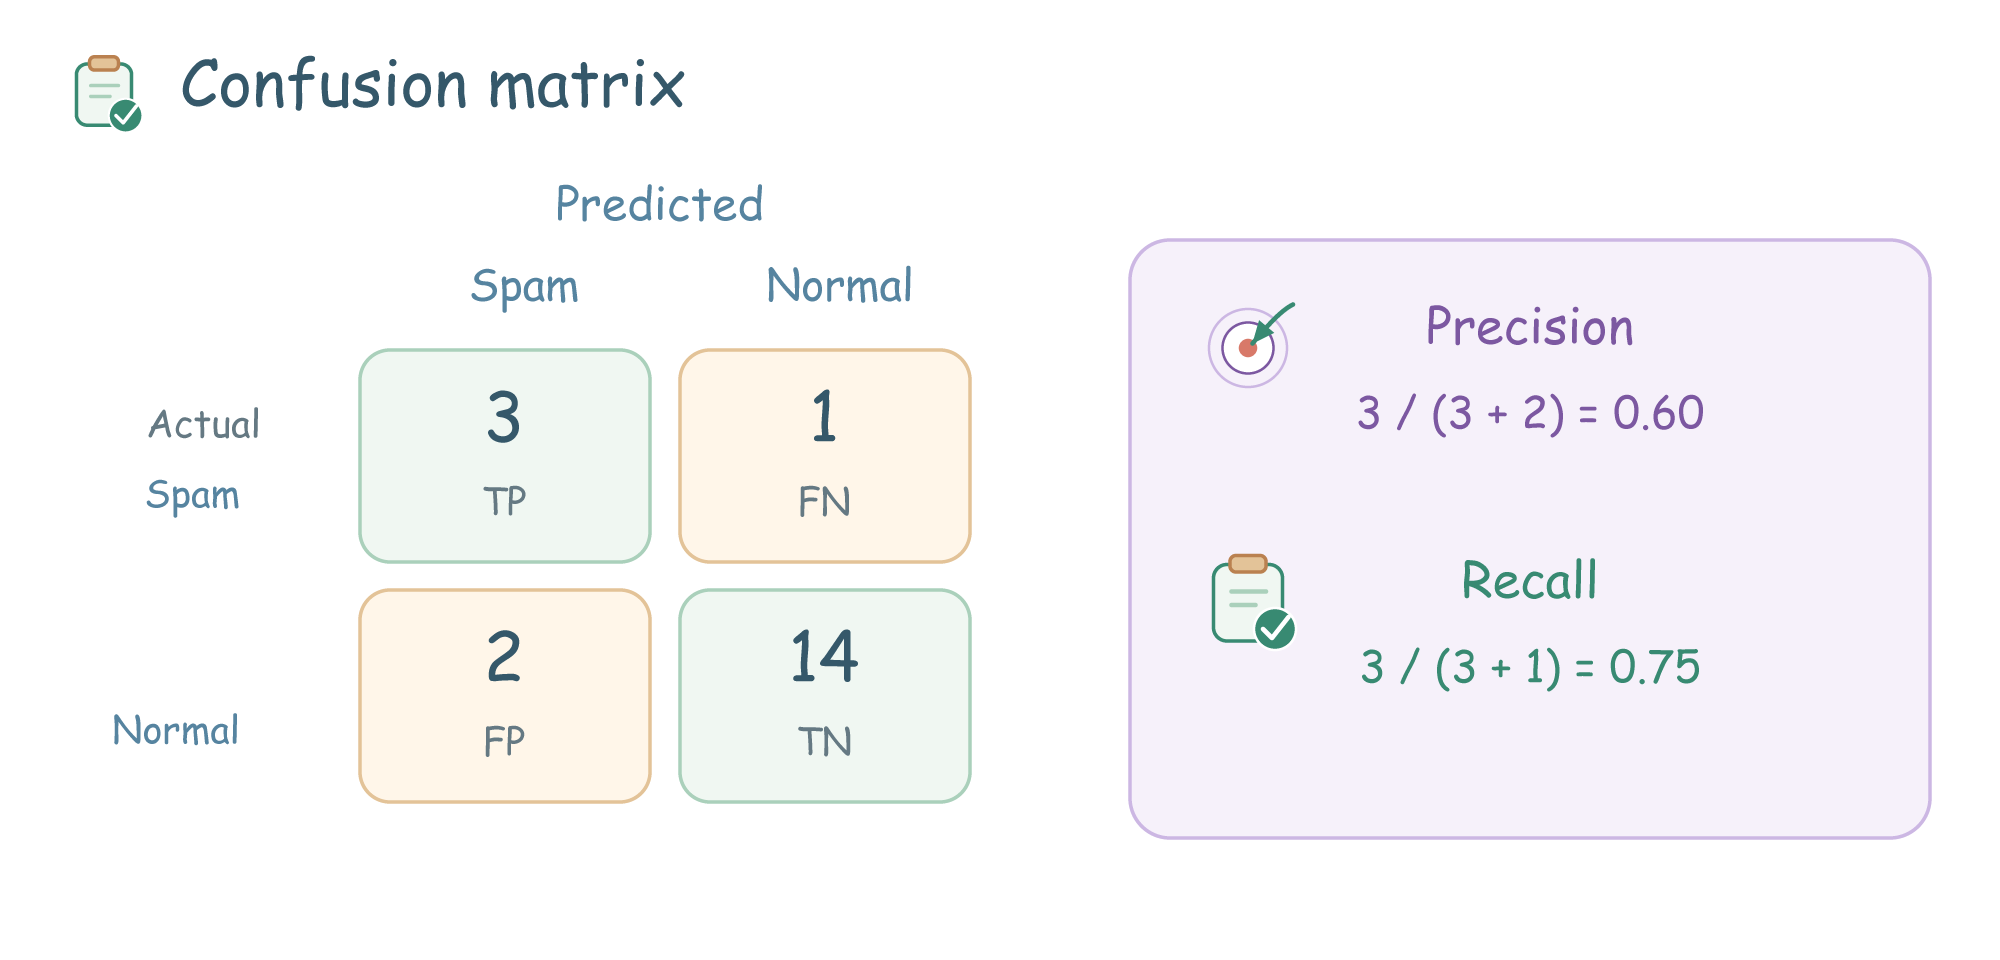
以垃圾邮件作为正类。下面是一组虚构的分类结果,共 20 封邮件:
| 实际情况 | 预测为垃圾邮件 | 预测为正常邮件 |
|---|---|---|
| 垃圾邮件 | 3(True Positive,TP,真正例) | 1(False Negative,FN,假负例) |
| 正常邮件 | 2(False Positive,FP,假正例) | 14(True Negative,TN,真负例) |
- 准确率(accuracy):所有邮件中判断正确的比例,。
- 精确率(precision):被拦截的邮件中,真正垃圾邮件的比例,。
- 召回率(recall):所有垃圾邮件中,被找到的比例,。
若全部放行,准确率仍有 80%,召回率却为 0。类别不均衡时,准确率可能掩盖模型对少数类的漏判。没有正类预测时,精确率分母为零,报告结果需说明工具的处理方式。
验证集与交叉验证
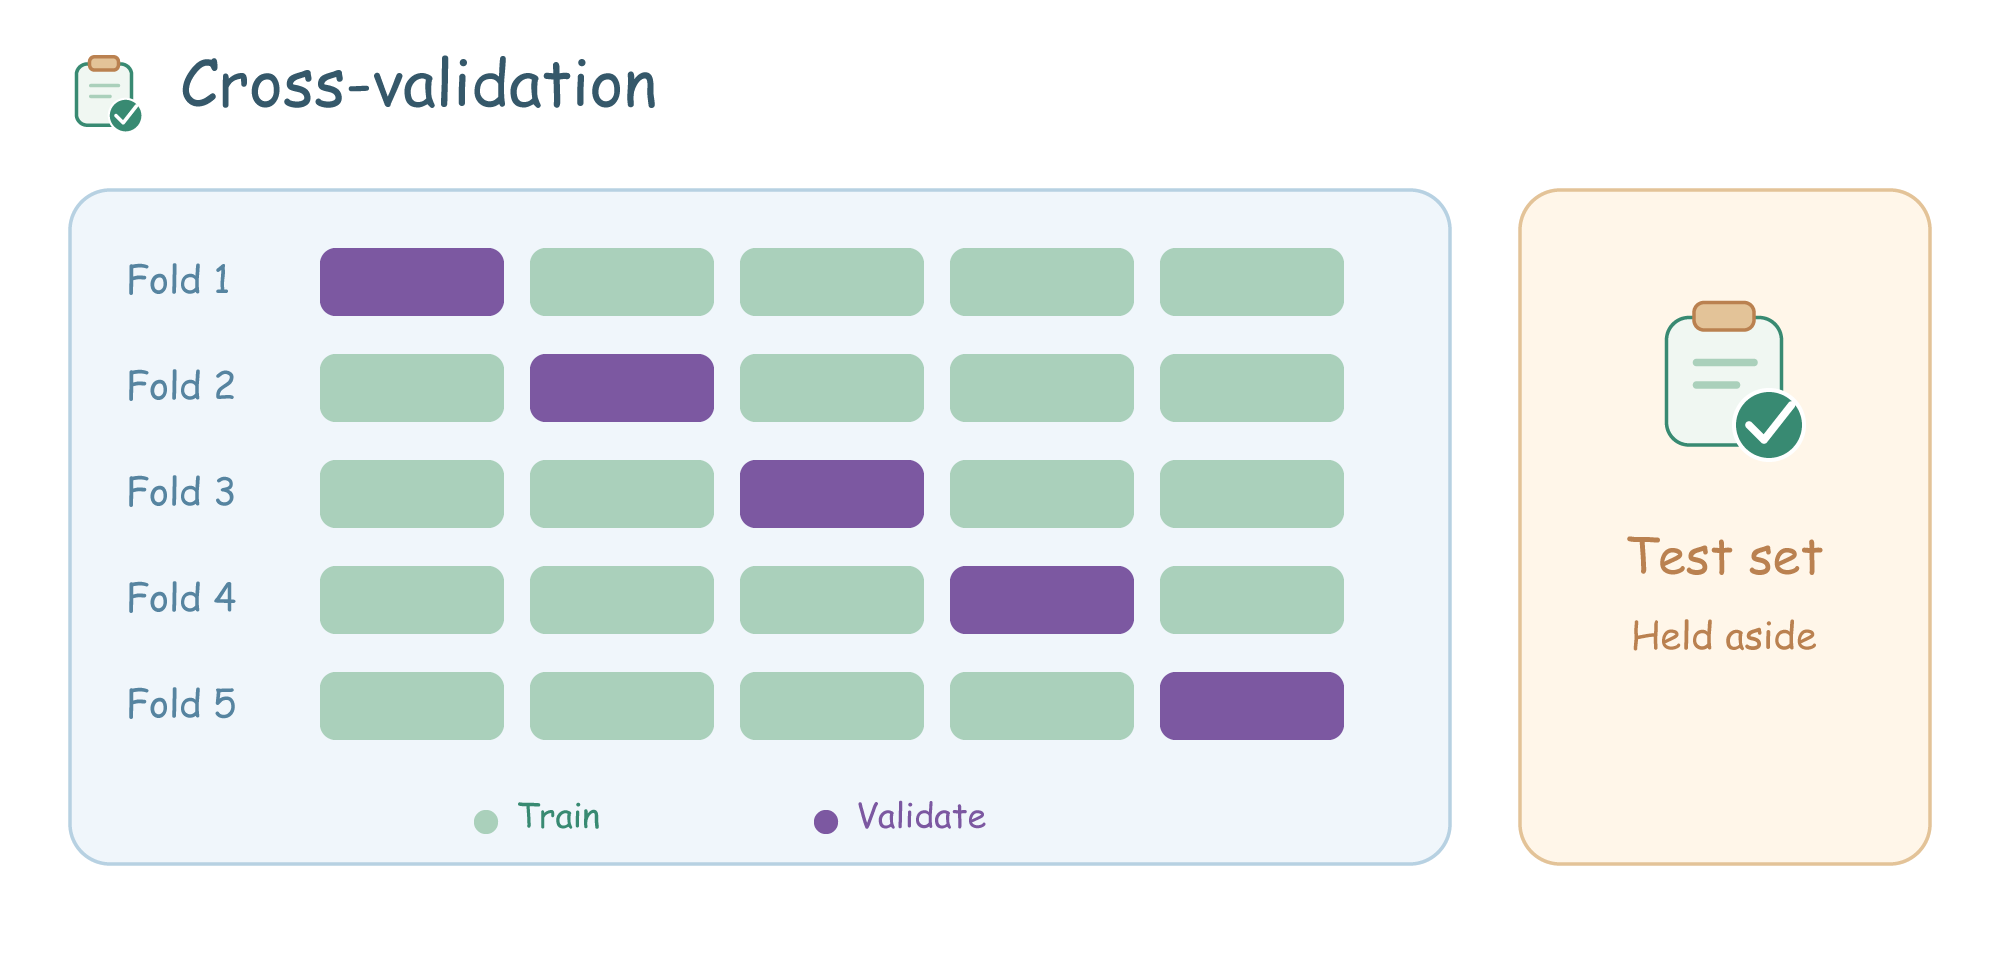
交叉验证(cross-validation)轮换使用不同的数据子集进行训练和验证,用多次成绩评价一个方案。验证成绩用于选择模型、参数和阈值;测试集留到方案确定后使用。
5 折交叉验证将非测试数据分成五份,每次用四份训练、一份验证,轮换五次。根据平均验证成绩选择方案,用全部非测试数据重新训练,得到最终模型。各折成绩的差异也反映了结果对数据划分的敏感程度。
时间序列通常按时间划分;同一人的重复记录可以按人分组,避免相似记录同时出现在训练和评价两侧。
欠拟合、过拟合与正则化
欠拟合(underfitting)指模型未充分学到训练数据中的规律;过拟合(overfitting)指模型过度适应训练样本,在未见数据上表现变差;正则化通过约束模型复杂度缓解过拟合。
用直线描述明显弯曲的关系可能欠拟合;将训练样本中的噪声也拟合进去,可能过拟合。
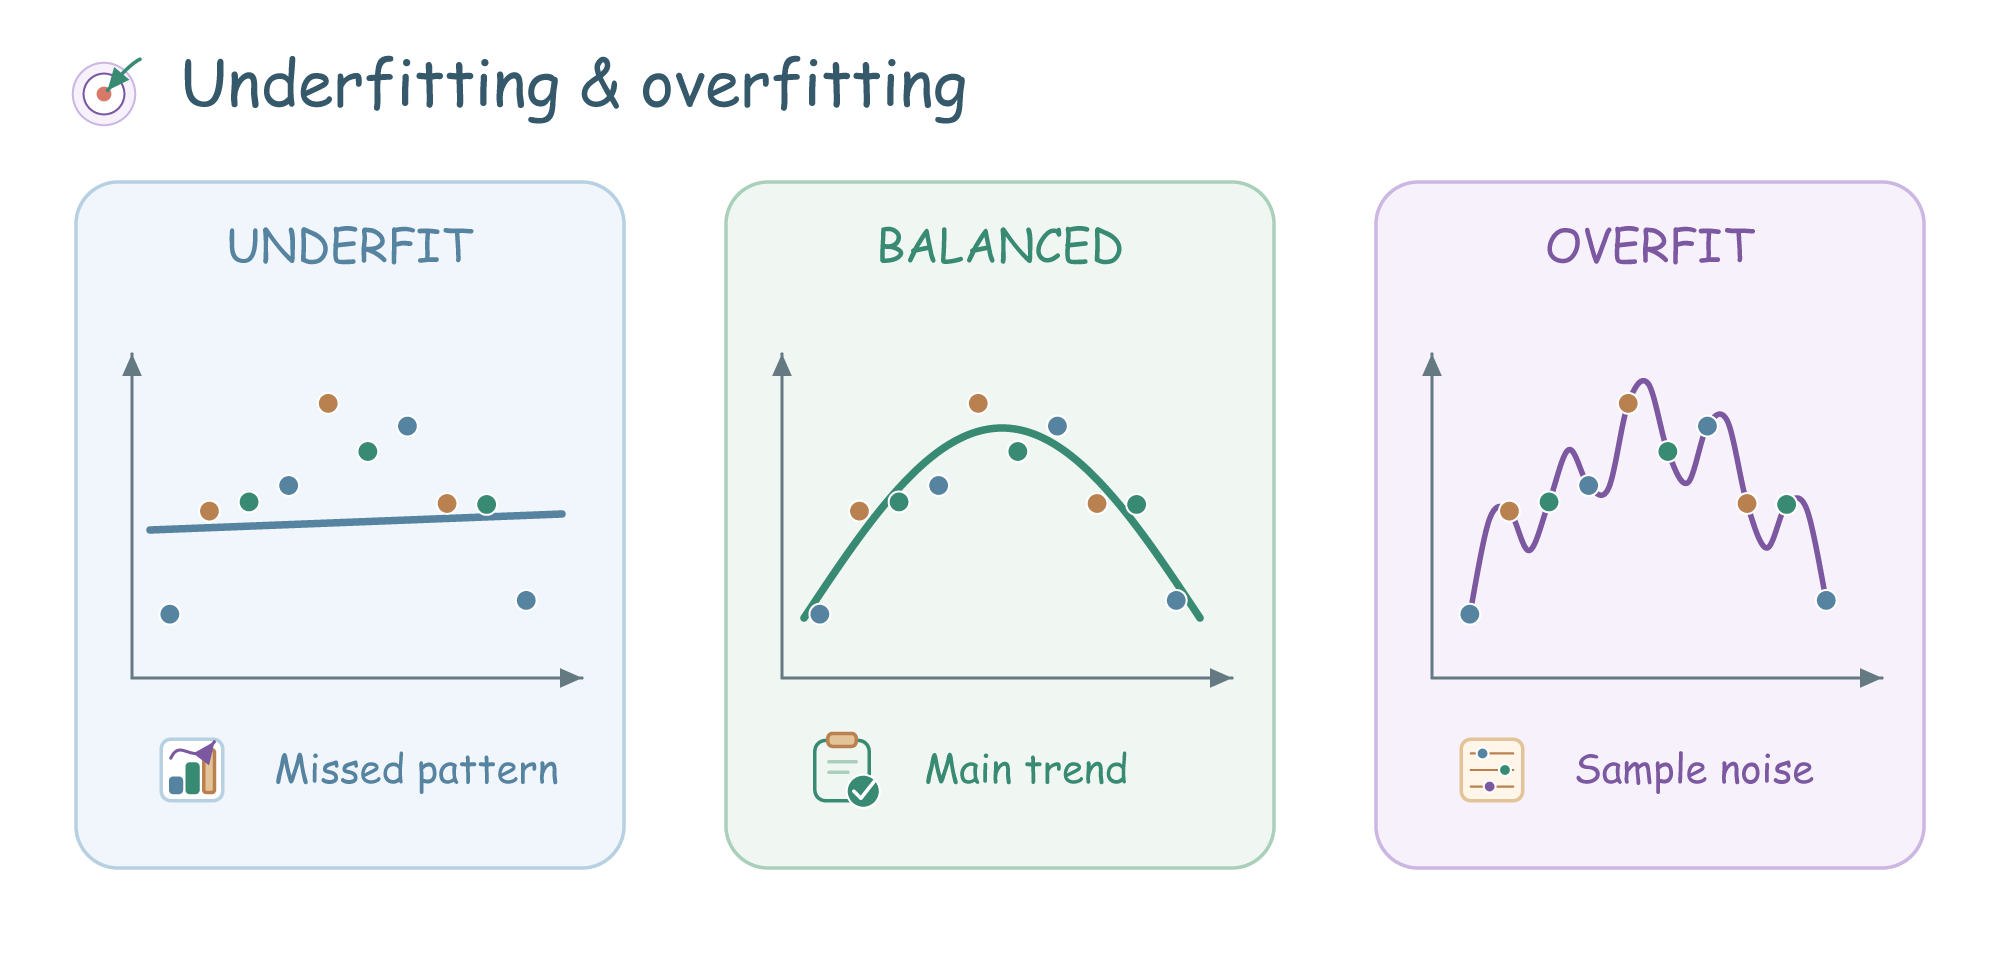
判断过拟合要比较训练与验证误差。曲线看起来复杂,本身不足以说明过拟合。
正则化通过约束模型复杂程度减少过拟合。例如 L2 正则化在训练目标中加入权重平方和的惩罚。约束太强也可能欠拟合,强度由验证结果选择。
练习:在回归项目中改变岭回归(Ridge regression)的 alpha,记录训练与验证平均绝对误差(Mean Absolute Error,MAE),观察二者如何变化。
数据泄漏
数据泄漏(data leakage)指训练或模型选择使用了评价数据、未来信息等本不该获得的信息,导致评价过于乐观。
例如,用全体数据计算标准化参数后再划分数据集,就让测试数据影响了训练过程。
数据划分后,预处理只对训练部分 fit,验证和测试部分只做 transform。缺失值填补、特征选择也遵循这一原则。交叉验证中,每一折都在该折训练部分拟合预处理。
流水线(Pipeline)将预处理与模型封装在一起,配合交叉验证可以保持这一流程。输入特征还需排除预测发生后才产生的信息。
综合分类指标与回归指标
F1 分数是精确率与召回率的调和平均。ROC(Receiver Operating Characteristic,受试者工作特征)曲线展示不同阈值下的假阳性率与召回率;AUC(Area Under the Curve)表示曲线下面积。AP(Average Precision,平均精确率)汇总精确率—召回率曲线。
F1 的公式是 , 为精确率、 为召回率。上面的邮件例子得到约 0.67;任一项很低都会拉低 F1。多分类的 macro-F1 对每类分别计算后平均,少数类与多数类权重相同;weighted-F1 按各类样本数加权。
分类概率可在不同阈值下产生不同结果。ROC 曲线的横轴是假阳性率 ,纵轴是召回率。ROC-AUC 衡量排序能力:随机取一个正例和一个负例,模型将正例排在前面的概率,平分时计一半。它不直接说明某个业务阈值是否合适。正类很稀少时,还应观察精确率—召回率曲线;AP 是常用的曲线汇总指标。
| 回归指标 | 含义 | 阅读结果时看什么 |
|---|---|---|
| MAE | 绝对误差的平均 | 单位与目标相同,容易解释 |
| 均方根误差(Root Mean Squared Error,RMSE) | 均方误差(Mean Squared Error,MSE)的平方根 | 单位与目标相同,更重视大误差 |
| 1 表示预测完全吻合,可以为负 |
对应直接预测该评价集目标均值的结果。可部署的均值基线仍只能用训练集均值;两者不要混为一谈。目标全部相同时, 分母为零,需说明实现的处理方式。
偏差与方差
对同一来源反复抽取训练集并训练模型,偏差(bias)是模型平均预测与真实规律的差距;方差(variance)是换一批训练数据后,预测发生变化的程度。
用直线拟合弯曲关系,可能每次都在同一个位置错得较远:偏差较大。让深树记住每个点,换几个样本预测就大变:方差较大。在平方误差及常见噪声假设下,期望预测误差可分为偏差平方、方差和不可约噪声。
增加模型能力通常能减小偏差,却可能增大方差。更多数据、正则化、集成可降低部分波动,但它们不能消除观测中固有的随机性。训练误差与验证误差是诊断线索,不能只凭一次划分精确算出偏差和方差。
训练和验证误差都很大,意味着什么?
可能是模型能力不足,也可能是特征缺少信息、标签质量差或优化未收敛。若训练误差很小、验证误差明显较大,再检查过拟合和分布变化。两种情况需要不同的改进方式。