K 近邻
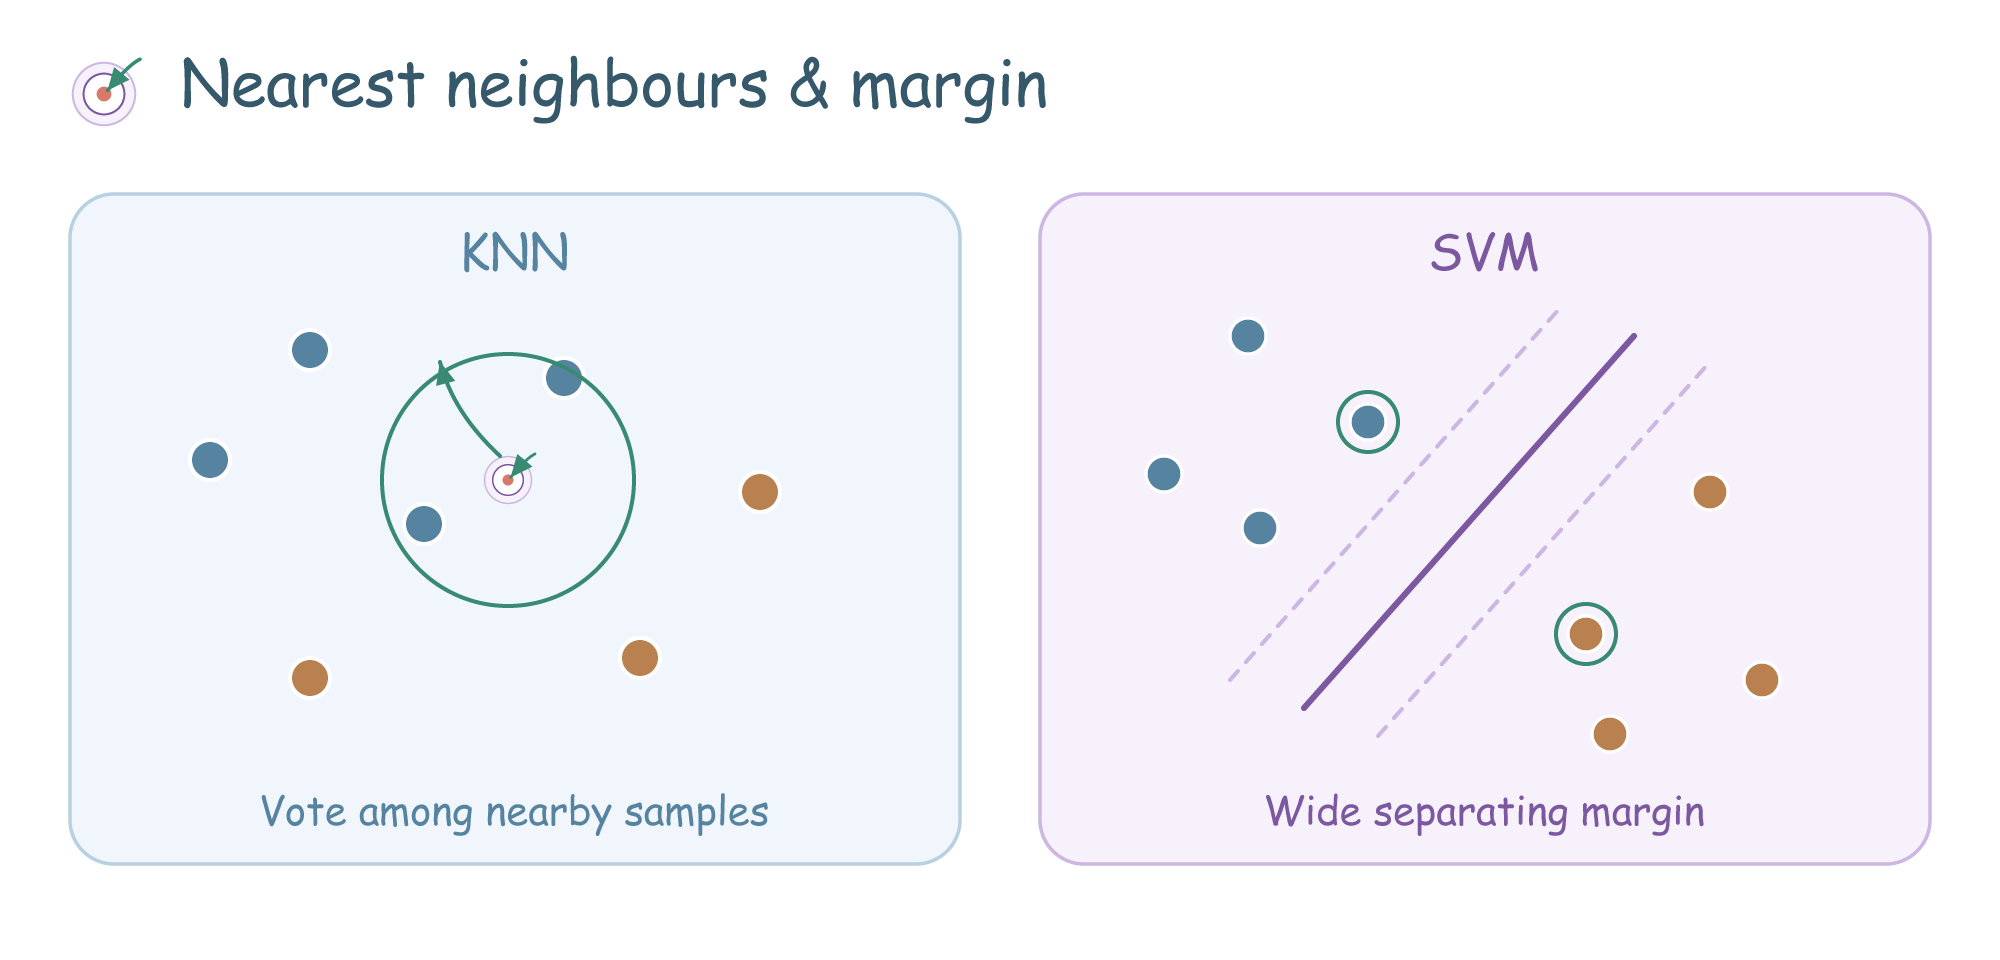
K 近邻(K-Nearest Neighbors,KNN)根据距离最近的 K 个训练样本预测新样本。分类通常按邻居类别投票,回归取邻居目标的平均,也可给较近的邻居更高权重。
例如一朵花最近的五个邻居中,三个是 A 类、两个是 B 类,K=5 的普通投票预测 A。K=1 对局部变化敏感,K 很大则会抹平小范围差异。K 用交叉验证选择。
两点 的欧氏距离为 ,即各维差值平方求和再开根号。例如 到 的距离为 5。某列以千为单位、某列只有零点几时,前者容易主导距离,因而常需标准化。
KNN 几乎没有拟合参数的过程,预测却要检索训练数据。样本多时查询成本较高;维度很高时,“近”和“远”的区分也可能变弱。
感知机
感知机(perceptron)是线性二分类模型,用输入加权和 的正负判断类别,训练时通过纠正误分类来更新参数。
标签记作 。训练遇到分错或恰好在边界上的样本时,更新 、,将边界向能正确分类该样本的方向移动。 是学习率。
例如 、,正类样本 位于边界。取 更新后,、,该样本得分为 6,成为正类。
线性可分数据上,标准感知机算法会在有限次错误更新后找到分隔边界。异或这样的数据无法用一条直线分开,单层感知机便无解;带非线性激活的多层网络可以表达更复杂的边界。
支持向量机与间隔
支持向量机(Support Vector Machine,SVM)寻找使两类之间间隔较宽的分类边界。间隔是边界与两侧最近样本之间的距离;决定边界的关键样本称为支持向量。
一条边界可能刚好避开所有训练点,却紧贴其中几个点。二维边界是直线,高维中是超平面。
现实数据常有重叠。软间隔 SVM 允许部分点进入间隔或被分错,通过 平衡这些错误与间隔宽度。较大的 更重视减少训练中的违规;较小的 约束更强。线性 SVM 常用合页损失(hinge loss):。分类正确且离边界足够远时,损失才为零。
例如一个异常标注点落在另一类内部,允许少量违规可以避免边界为它大幅扭曲。是否改善验证结果仍需实际比较。SVM 的原始输出是得分,概率估计需要额外校准。
核方法
核方法(kernel method)用核函数计算转换后的特征空间中的点积,无需显式构造全部新特征。它使一些线性算法能表达原始空间中的非线性关系。
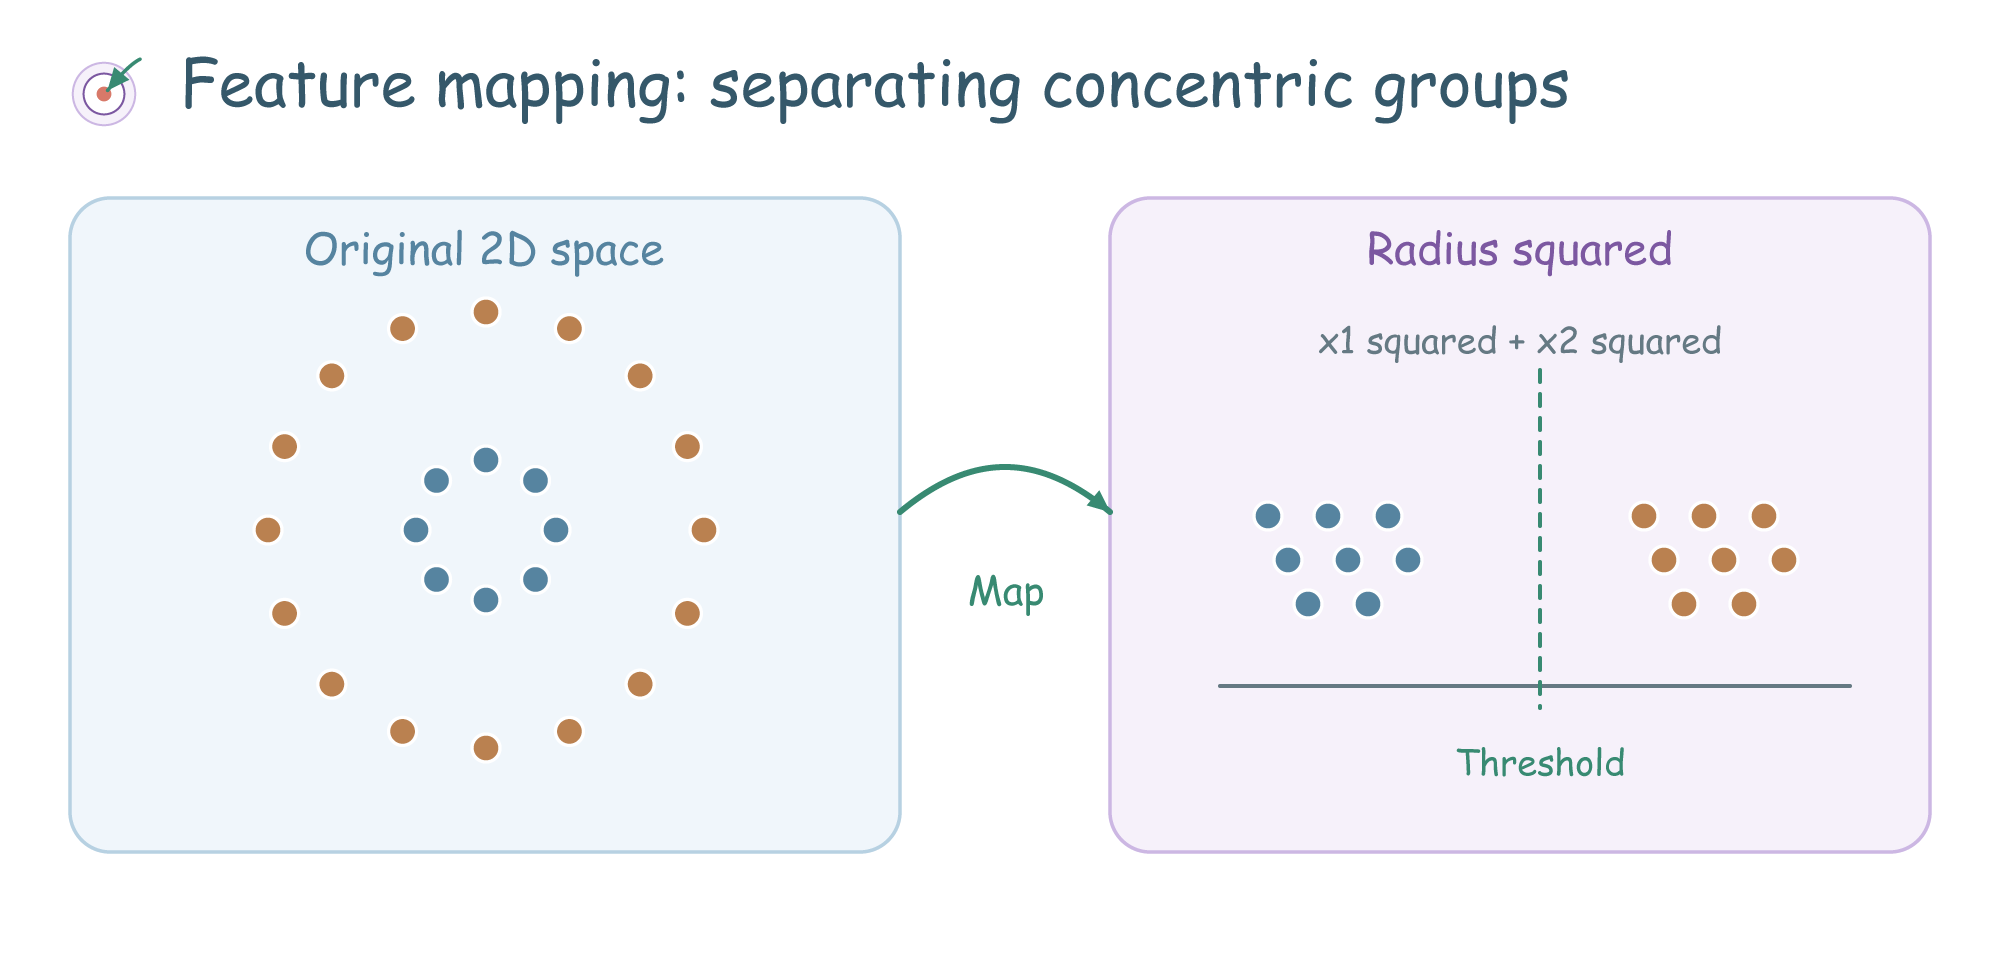
中心一圈点与外侧一圈点无法用直线分开。如果增加特征 ,按半径设置阈值就能区分;核方法推广了这种“转换特征后再比较”的思路。
常见的径向基函数(Radial Basis Function,RBF)核为 。两点越近,值越接近 1;越远,值越接近 0。 大时,每个点的影响范围较小,边界可以更细碎。 与 通常一起调节。
核可以让 SVM 得到非线性边界,但计算训练样本之间的关系有成本。大数据集上,线性模型或近似核往往更易扩展;特征缩放也会直接影响 RBF 的距离。