遮住一列,看看能估多准
翻成分表时,坤坤又盯上了酒精这一列:其他指标都知道,能不能把它估出来?他另存了一份表,把 alcohol 列取出来当答案,剩下 12 列交给岭回归。跑完以后,把实测值和预测值并排放着看。光看一长列数字很费眼,画成残差图,偏得远的样品就显出来了。
回归预测连续数值;基线是用来比较的简单规则。岭回归(Ridge regression)在线性回归中加入权重平方惩罚。残差是实际值减预测值,用来观察预测偏高还是偏低。
数据包含 178 条葡萄酒记录。将 alcohol(酒精)列作为预测目标,另外 12 项指标作为输入。
相关知识:线性回归、损失函数、特征缩放、正则化、交叉验证、数据泄漏。
下载与运行
下载 食品实验室完整项目包,按运行环境安装并启动。在左侧选择“酒精含量预测”。
本实验的练习文件:projects/wine_regression/exercises.py。先运行演示,再填写函数;保存后点击“检查练习”,通过后切到练习模式运行。
看图与实验
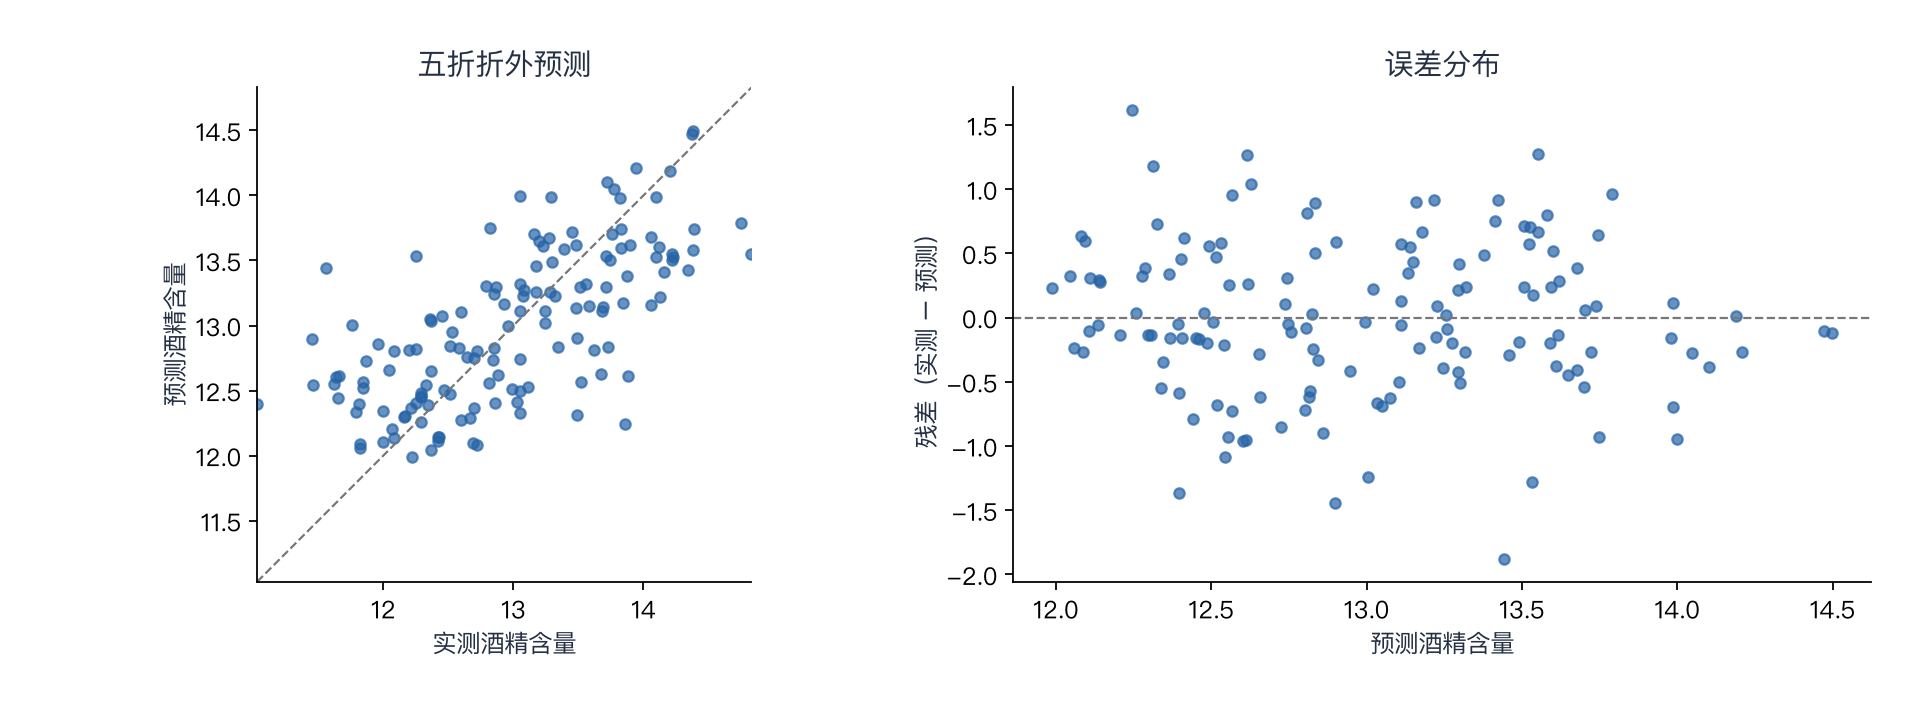
先看实测—预测图:虚线是理想预测。残差为实测减预测,零线上方表示低估。选择偏差大的点,查看原始成分。再比较 alpha 曲线和标准化系数。
alcohol 是预测目标,从输入中移除后留下12项成分。每折单独拟合标准化与模型,比较平均绝对误差(Mean Absolute Error,MAE),选择平均验证误差最小的 alpha。
实测—预测图的虚线表示理想预测。残差定义为实测减预测:正值表示低估,负值表示高估。开发数据上的图使用五折折外预测,每个点都由没有训练过该点的模型预测。
参数图使用对数横轴;误差越小越好。系数曲线对应标准化后的输入,观察正则化加强时系数怎样变化。选定配置后,再查看留出的测试集。
填写函数
split_target
目标列必须从输入中移除,保留相同索引。
接口提示
X=data.drop(columns="alcohol");y=data["alcohol"]。
errors
残差保留正负号,绝对误差去掉符号后求平均。
接口提示
np.asarray(actual)-np.asarray(predicted);np.abs(...).mean()。
build_model
每折训练内部都要重新拟合标准化。
接口提示
用 make_pipeline(StandardScaler(), Ridge(alpha=alpha)) 返回未拟合模型。
select_alpha
只比较 valid_mae,不能按训练误差选择。
接口提示
idxmin() 找到最小验证误差所在行,再取 alpha。
进阶与记录
只选两三项成分,再恢复全部12项,比较五折验证误差和波动。说明岭回归与均值基线、普通线性回归的差异,最后用测试集评价选定配置。
“实验记录”保存当前会话中的参数、种子、指标和结果表,可下载 CSV 或 JSON。修改代码或训练参数后,旧结果会提示待更新;查看图中样本不会重新训练。完整参考实现放在 solutions/wine_regression.py。