坤坤收到一批葡萄酒样本。检测表上有酒精、酸度等成分,瓶子上的类别标签却被遮住了。他想用这些数字认出酒的类别,也想知道:如果少测一项酒精含量,能不能靠其余成分估计出来?
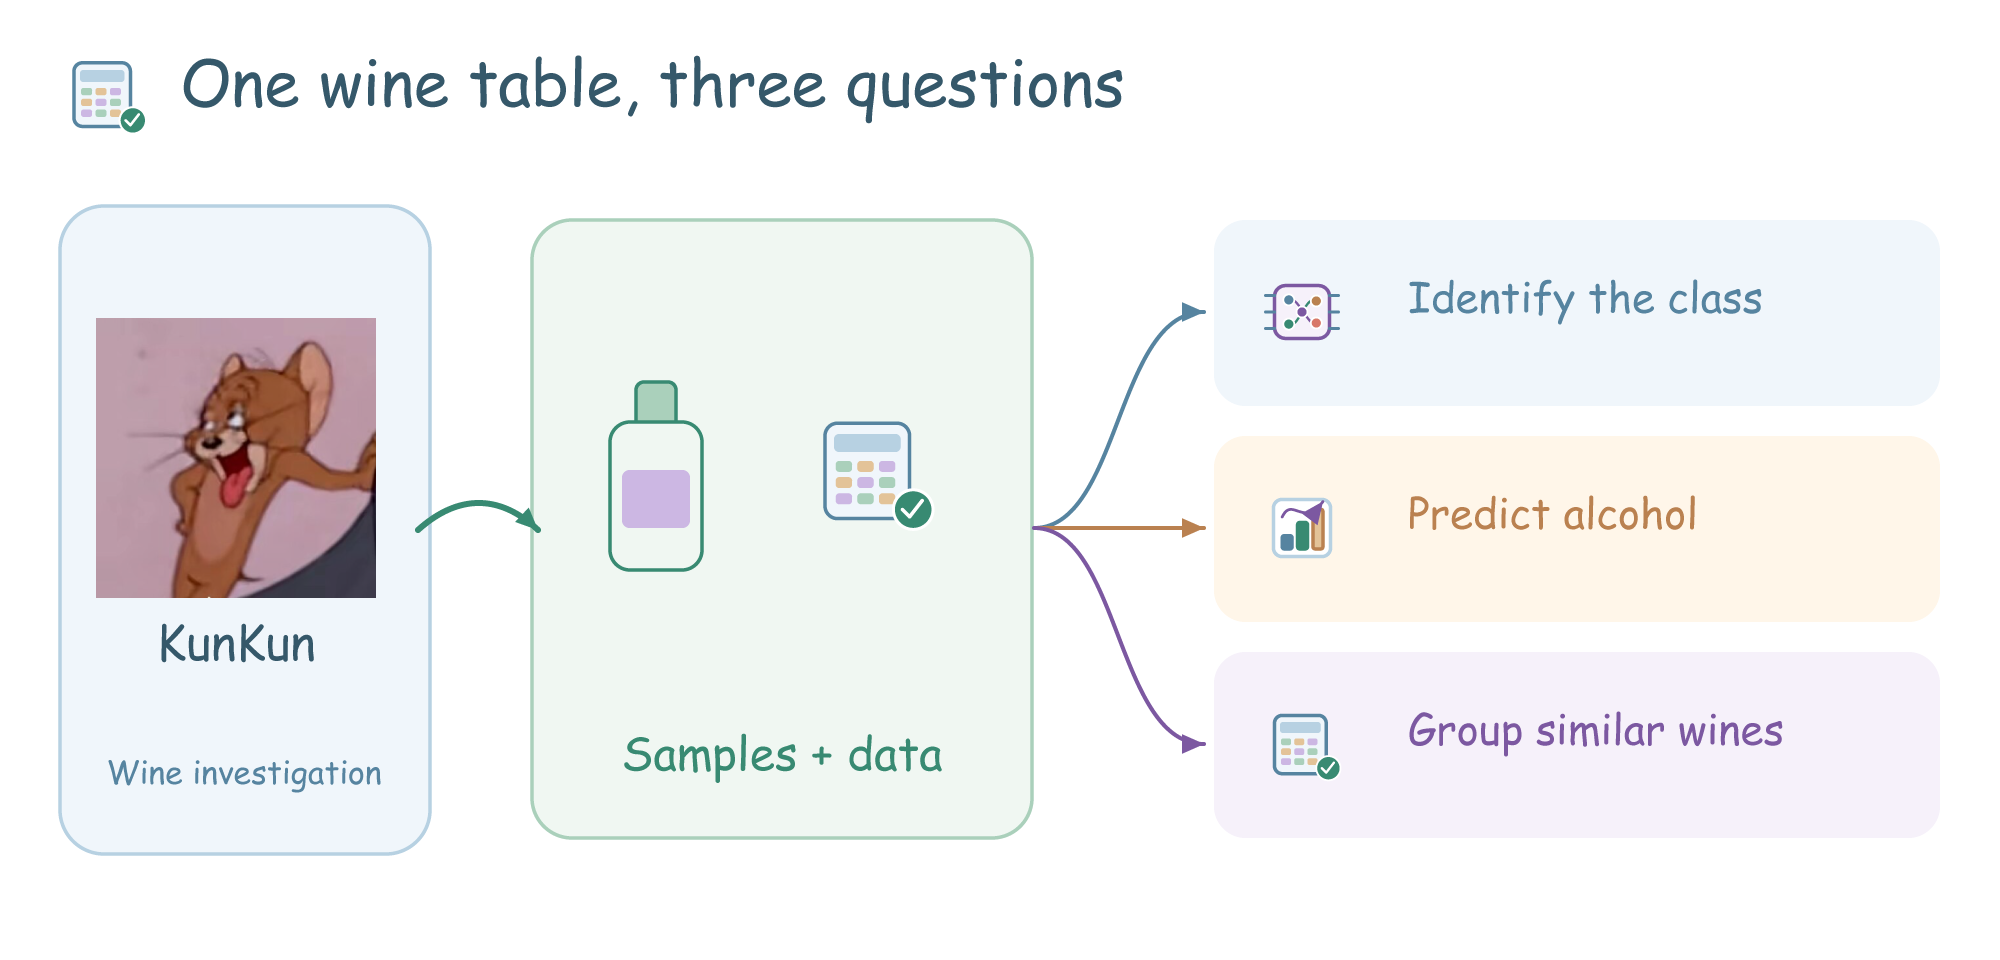
围绕同一批葡萄酒完成三项调查:根据成分判断类别,用其余指标预测酒精含量,以及遮住标签后给相似的酒分组。把结果放在一起,看看模型认出的区别与真实类别是否一致,预测误差又落在哪些样本上。
相关知识
- 特征与标签和特征缩放:读懂成分表,并理解不同量纲为什么会影响模型。
- 分类与回归:分清“判断酒的类别”和“预测酒精含量”这两种任务。
- 线性回归与L2 正则化:理解含量预测和 Ridge 模型的基本思路。
- K-means与主成分分析(PCA):给相似的酒分组,再把多维成分投影到二维观察。
- 分类与回归指标和数据泄漏:为不同任务选对评价方式,避免把待预测的答案带进输入。
打开项目后选择「葡萄酒研究室」。运行方法见包内 GETTING_STARTED.md,原理讲解和练习引导在实验页面里。