样本、特征与标签
样本是一条观测记录;特征是供模型使用的输入;标签是监督学习中希望模型预测的结果。
一朵花的测量记录可以写成表格的一行:
| 花瓣长度 / 厘米 | 花瓣宽度 / 厘米 | 品种 |
|---|---|---|
| 1.4 | 0.2 | 山鸢尾 |
这朵花是一个样本,长和宽是输入特征,品种是要预测的标签。代码通常用 X 保存特征,y 保存标签;上例的 X 有两列。
特征必须在预测时能够获得。例如预测考试成绩,可以使用考前练习记录;考后生成的总评已经包含结果信息,会造成数据泄漏。
回归与分类
回归(regression)预测数值,例如气温、用电量。分类(classification)预测类别,例如花的品种、邮件是否为垃圾邮件。
类别可以编码为 0、1、2,这些数字只用于区分类别,没有数量大小的含义。
同一份学习记录也能对应不同任务:“明天学多久”是回归,“明天是否达到 30 分钟”是分类。
训练集、验证集与测试集
训练集用于学习参数,验证集用于选择模型和设置,测试集用于方案确定后的独立评价。
根据测试成绩反复修改模型,会让测试集参与选择,失去独立评价的作用。
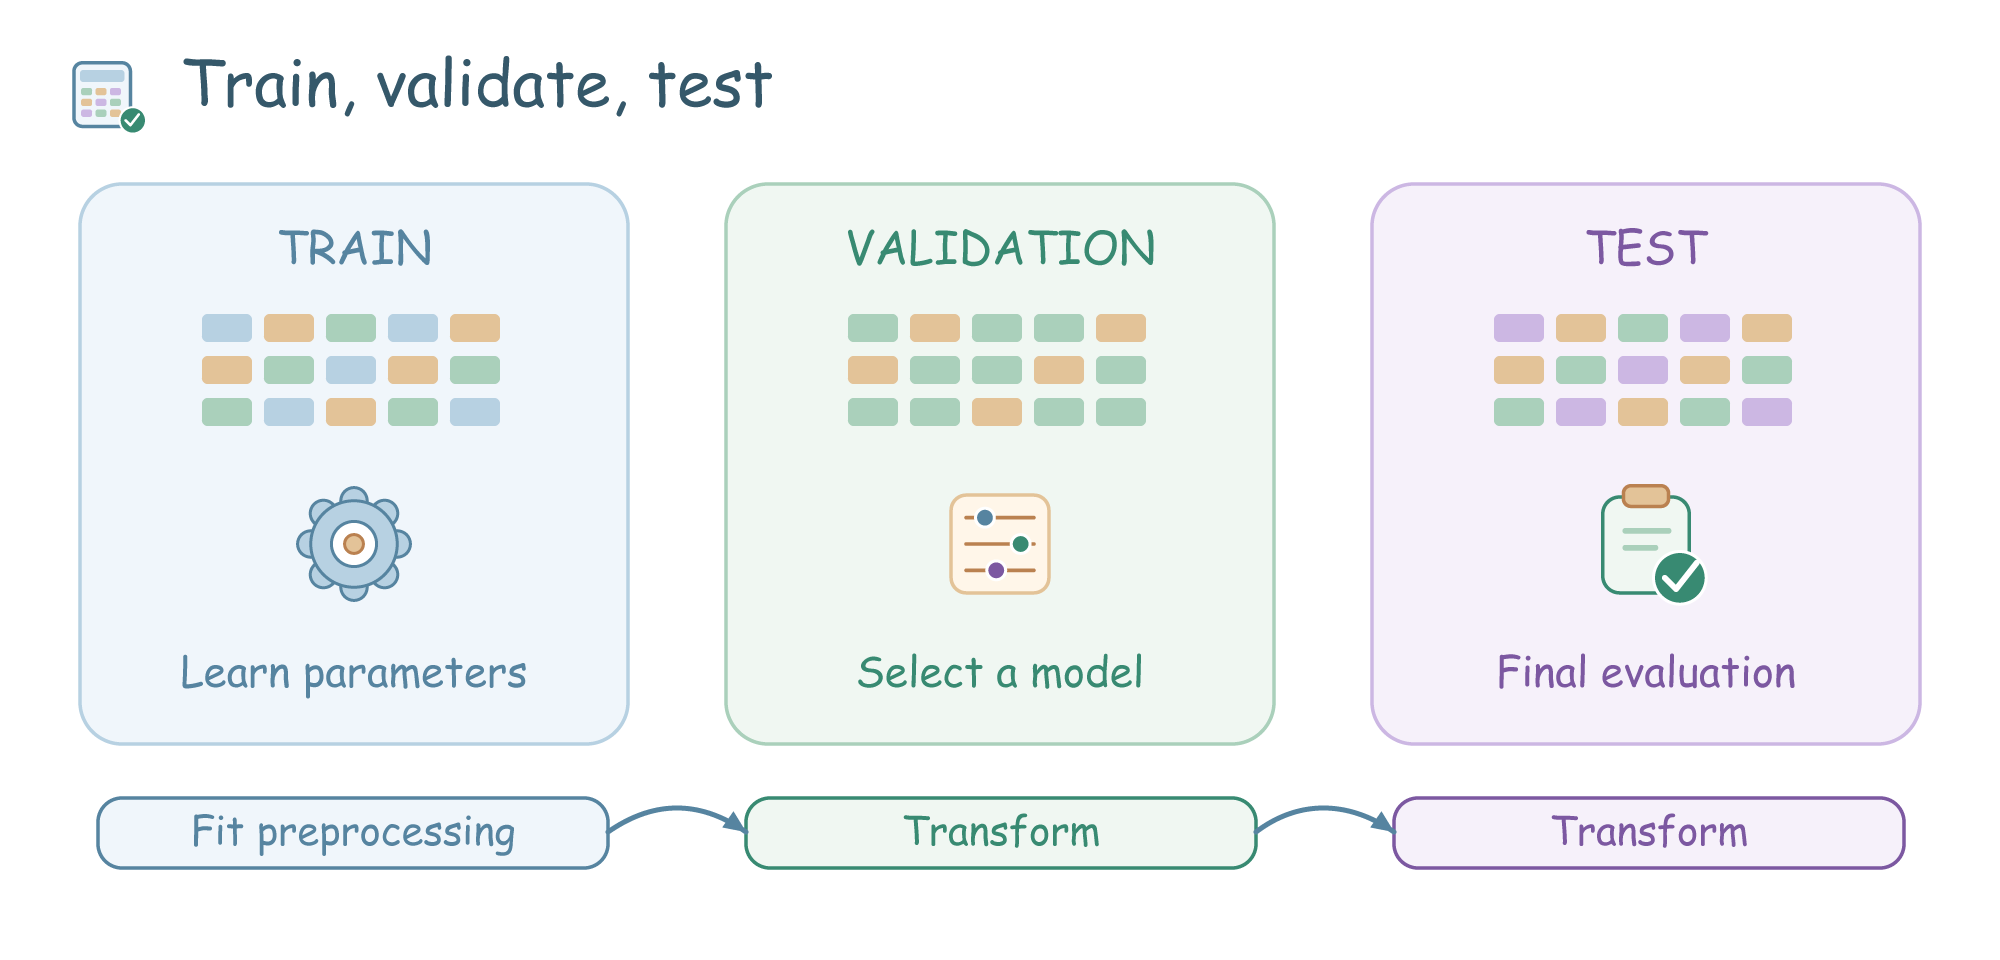
150 条花朵记录可以分为 90 条训练、30 条验证、30 条测试。比例依任务而定;分类任务通常保持各部分的类别比例,固定随机种子便于复现。预测未来的任务按时间划分,避免未来信息进入训练。
标准化的均值、标准差等统计量也只从训练集计算,验证集和测试集使用相同的变换。
基线模型
基线模型(baseline)是用于比较的简单预测规则。分类可以始终预测训练集中最多的类别;回归可以始终预测训练标签的均值。
假设训练集和验证集的多数类比例都是 80%,始终猜多数类就能获得 80% 验证准确率。新模型的 82% 应当与这个结果比较,才能看出改进幅度。
基线与模型使用同一份评价数据、同一个指标。均值、多数类等规则从训练集确定。
DummyClassifier,其中 strategy="most_frequent" 对应多数类基线。
经验风险最小化
风险是预测损失的平均水平。经验风险最小化(Empirical Risk Minimization,ERM)通过调整模型参数,减小训练样本上的平均损失。
经验风险写作:
是样本数, 是模型参数, 是第 个预测, 是单个样本的损失。训练寻找让这个平均值较小的参数。例如三次预测的绝对误差为 2、4、6,经验风险就是 4。
真正关心的是新样本上的平均损失,即期望风险。新样本尚未出现,只能用独立验证数据估计。训练误差下降并不保证期望风险下降;模型也可能记住噪声。
用城市夏季数据训练的用电模型,在冬季农村未必适用。训练和使用环境的分布发生变化,即使测试集上的分数很好,也不能直接保证实际效果。
概率、均值与方差
概率描述结果的不确定性;条件概率是在某个已知条件下,结果发生的概率。
若 100 封已标注邮件中有 20 封垃圾邮件,频率估计为 。条件概率 只统计含促销词的邮件,分母随条件改变。
期望是按概率加权的平均值。方差是偏离期望的平方的平均,衡量波动大小;标准差是方差的平方根,与原变量单位相同。
一次测量以相同概率得到 2 或 6,期望为 。方差为 ,标准差为 2。
相关性描述两个量是否一起变化,不能单独证明因果。冰淇淋销量和空调用电量可能同时升高,共同原因是天气炎热。模型可以利用相关性预测,但干预后的结果需要额外分析。