把标签收起来再分一次
分类做完了,坤坤想把这张表再折腾一下。他收起类别标签,让 K-means 只看成分,分成三组。屏幕上的每个点是一份酒样,他把原来的类别也画在旁边,两张图来回对着看。有些样品分在一起,有些换了组;他想找的就是这些不一致的地方,再翻回表里看它们的检测值。
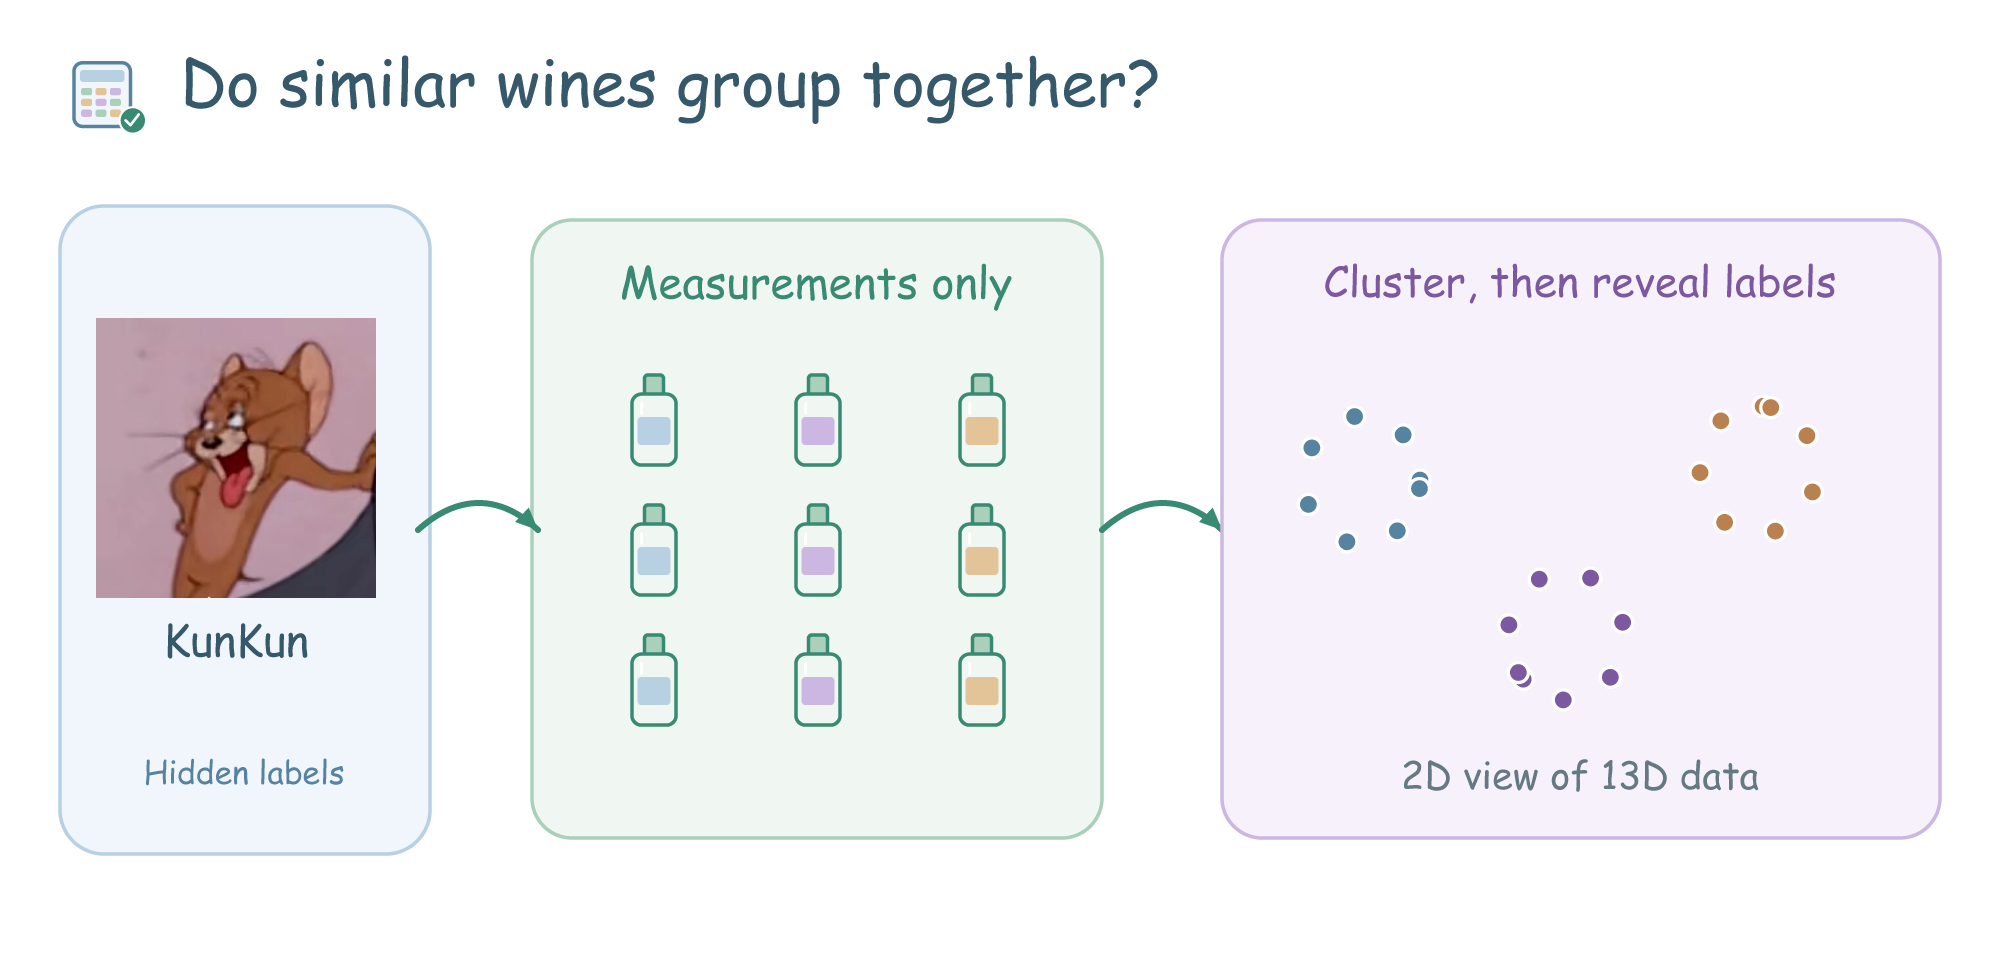
聚类在没有类别标签的情况下按相似性分组。K-means(K 均值聚类)用 K 个中心表示分组;主成分分析(Principal Component Analysis,PCA)将数据投影到保留较大方差的少数方向。
相关知识:标准化、K-means 与聚类评价、PCA。
下载与运行
下载 食品实验室完整项目包,按运行环境安装并启动。在左侧选择“聚类与降维”。
本实验的练习文件:projects/clustering/exercises.py。先运行演示,再填写函数;保存后点击“检查练习”,通过后切到练习模式运行。
看图与实验
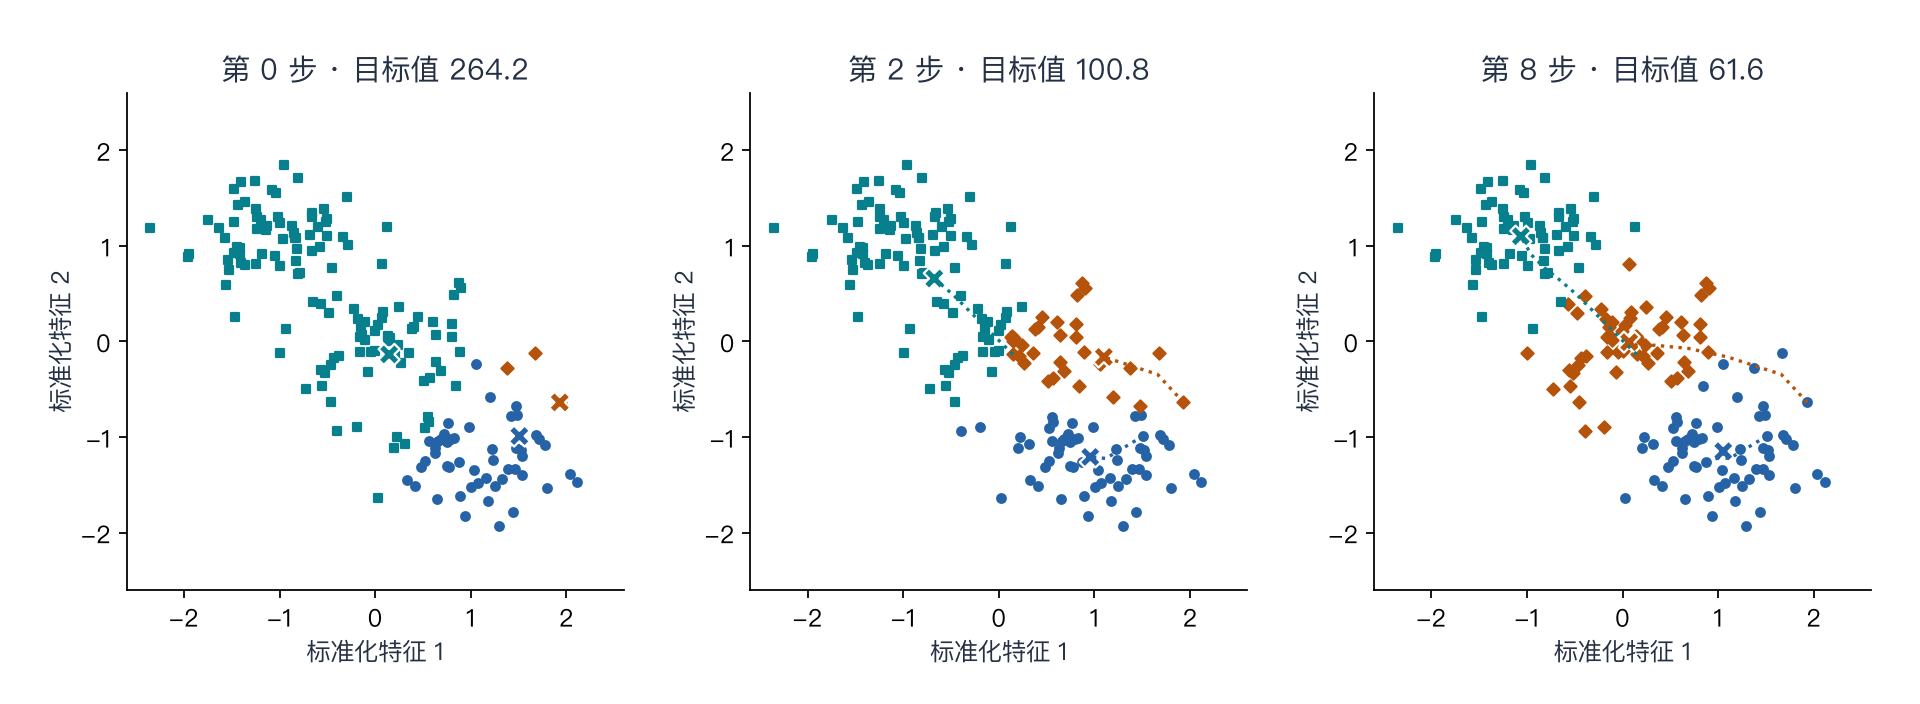
从二维点集开始,拖动步骤条,看“分组—更新中心”如何交替。修改K与种子,比较轨迹和目标值。转到 Wine 后,先观察分组,再揭开标签。
先在二维点集完成“计算距离—分组—更新中心”的循环。点的颜色表示当前分组,叉号是中心,虚线记录中心走过的位置。拖动步骤条可单步查看,也可以播放、暂停、重置。
转到 Wine 后,默认在全部13个成分上聚类,用主成分分析(Principal Component Analysis,PCA)投影展示。切换“先降至二维再聚类”时,算法输入才变成两个主成分。
揭开标签后,用同一组坐标对照真实类别。调整兰德指数(Adjusted Rand Index,ARI)比较样本对是否同组;交换簇编号不改变评价。
填写函数
distances
将每个样本与每个中心相减,平方后对特征维求和。
接口提示
X[:,None,:] 与 centers[None,:,:] 广播;结果为 N×K。
assign_groups
每个样本选择距离最小的中心。
接口提示
对距离矩阵使用 argmin(axis=1)。
update_centers
新中心是该组样本均值;空组保留原中心。
接口提示
先复制 old_centers,再按 groups==i 取行求 mean(axis=0)。
converged
每个中心计算一次移动距离,最大的也不超过阈值才停止。
接口提示
np.linalg.norm(new-old,axis=1);不能只看某一个中心。
best_restart(进阶)
多个初始位置会得到不同局部最优,比较最终目标值。
接口提示
返回 inertias 中最小值的位置,不能直接返回最小值。
进阶与记录
完成多次初始化并和 scikit-learn 比较。分别在13维和二维投影中聚类,查看轮廓系数、组内距离和标签对照;不同输入尺度下的目标值不要直接横向比较。
“实验记录”保存当前会话中的参数、种子、指标和结果表,可下载 CSV 或 JSON。修改代码或训练参数后,旧结果会提示待更新;查看图中样本不会重新训练。完整参考实现放在 solutions/clustering.py。