K-means 与聚类评价
K-means(K 均值)用 K 个中心分组,目标是减小样本到所属中心的距离平方和。轮廓系数(silhouette coefficient)比较组内紧密程度与组间分离程度,用来评价分组结构。
算法交替将各点分给最近中心,再把中心更新为组内均值,直到变化很小。
例如点 1、2、3、8、9、10 分成两组后,中心分别为 2 和 9。不同初始中心可能得到不同结果;多次初始化可减轻这个问题。尺度不同的特征通常要标准化,离群点也可能把均值拉偏。
轮廓系数比较每个点与本组、最近其他组的距离:。 是本组平均距离, 是最近其他组的平均距离。接近 1 表示分组较清晰,负值提示它可能更靠近其他组。K 的选择还需结合用途;指标高不保证分组有实际意义。
聚类编号可以任意交换。算法输出“第 0 组”,并不意味着它对应真实标签 0。若有标签用于事后对照,可用调整兰德指数(Adjusted Rand Index,ARI)等不受编号影响的指标;ARI 比较样本对的同组关系,并校正随机分组的一致性,不能直接比较编号是否相等。
层次聚类
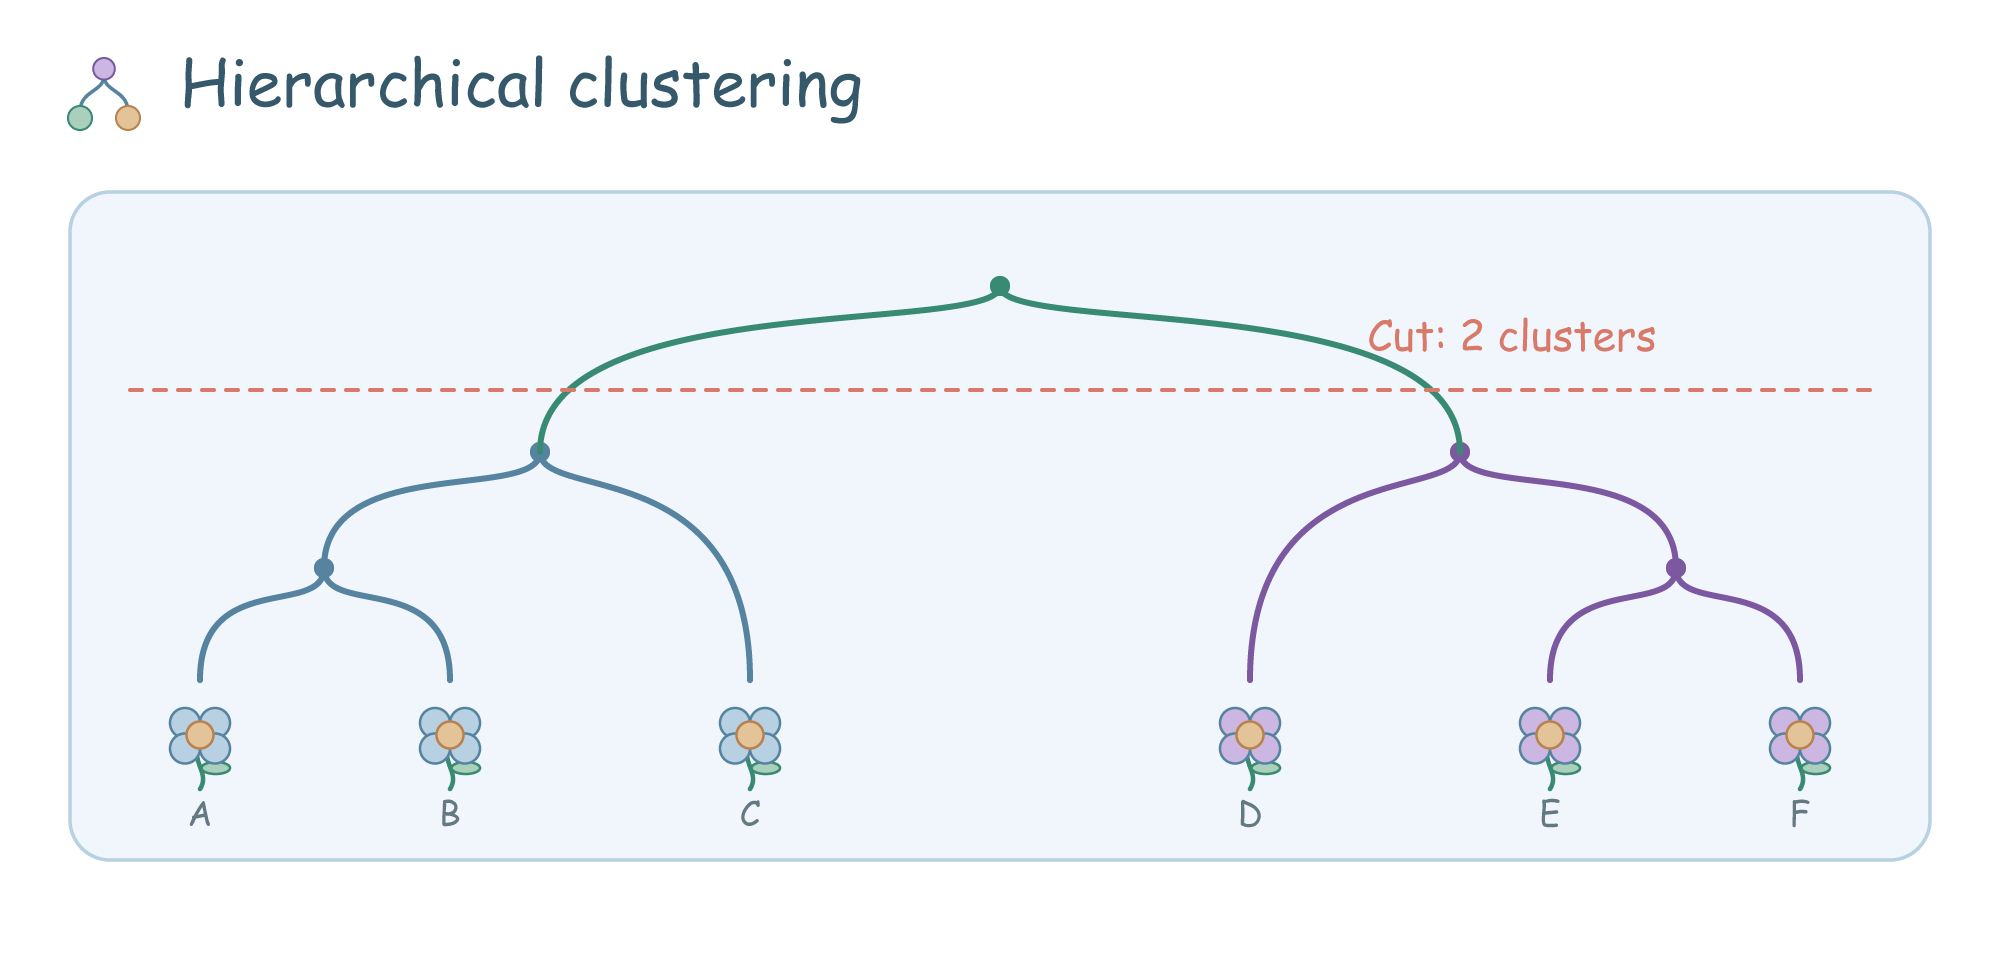
层次聚类(hierarchical clustering)建立具有不同粒度的嵌套分组。凝聚式方法从每个样本各自成组出发,反复合并最接近的两组,形成树状图。
在某个高度切开树,就得到对应分组数,无需重新完成整个合并过程。
“组之间的距离”需要定义。单链接用最近两点的距离,容易把沿细长路径分布的点串成一组;全链接用最远两点距离,偏向紧凑分组;平均链接取跨组距离平均。Ward 方法选择使组内平方误差增加最小的合并,使用欧氏几何。
例如城市按交通特征聚类,低层可能合并相邻的相似城市,高层再合并为区域。树状图展示了不同粒度,但已发生的合并通常不会撤销;噪声与尺度会影响整棵树,样本很多时计算成本也较高。
高斯混合与期望最大化
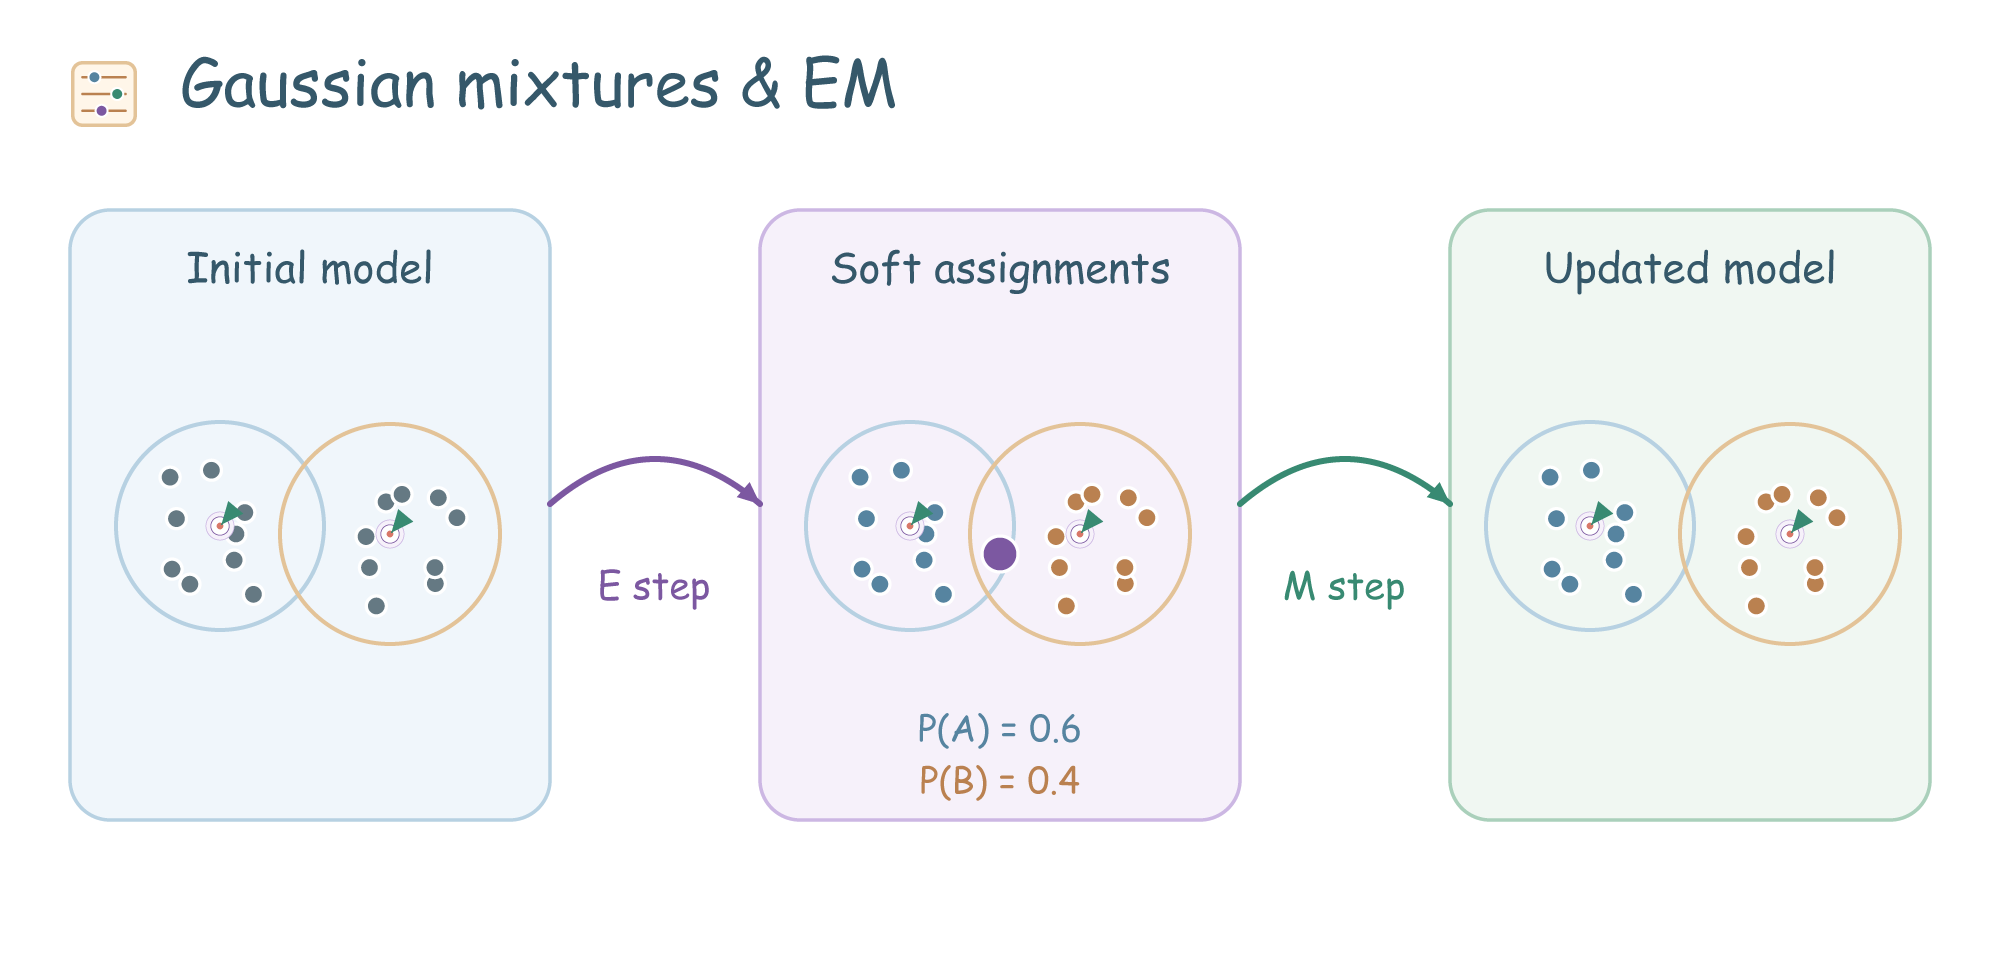
高斯混合模型(Gaussian Mixture Model,GMM)将数据分布表示为多个高斯分布的加权组合。期望最大化(Expectation-Maximization,EM)交替估计隐含分组与模型参数,常用于训练 GMM。
高斯分布呈钟形。每个分量有自己的均值、协方差和混合比例:均值确定中心,协方差描述各方向的扩散及相关性,因此分组可以呈椭圆形。
例如两类产品的重量分布重叠,某件产品可能以 0.7 的概率属于分量 A、0.3 属于 B。GMM 保留这种软分配,也可以选概率最大的分量作为组别。
不知道分组时,参数难以直接估计;不知道参数时,又无法判断分组。EM 在二者之间交替:
- E 步:用当前参数计算各点属于每个分量的概率,称为责任度。
- M 步:用责任度作权重,重新计算均值、协方差与混合比例。
例如 A 对三个点的责任度为 0.8、0.6、0.1,更新 A 的均值时,这三个点分别贡献对应权重。EM 的标准更新不会降低训练似然,但可能停在局部最优;初始化、分量数及协方差约束都要考虑。
主成分分析与线性降维
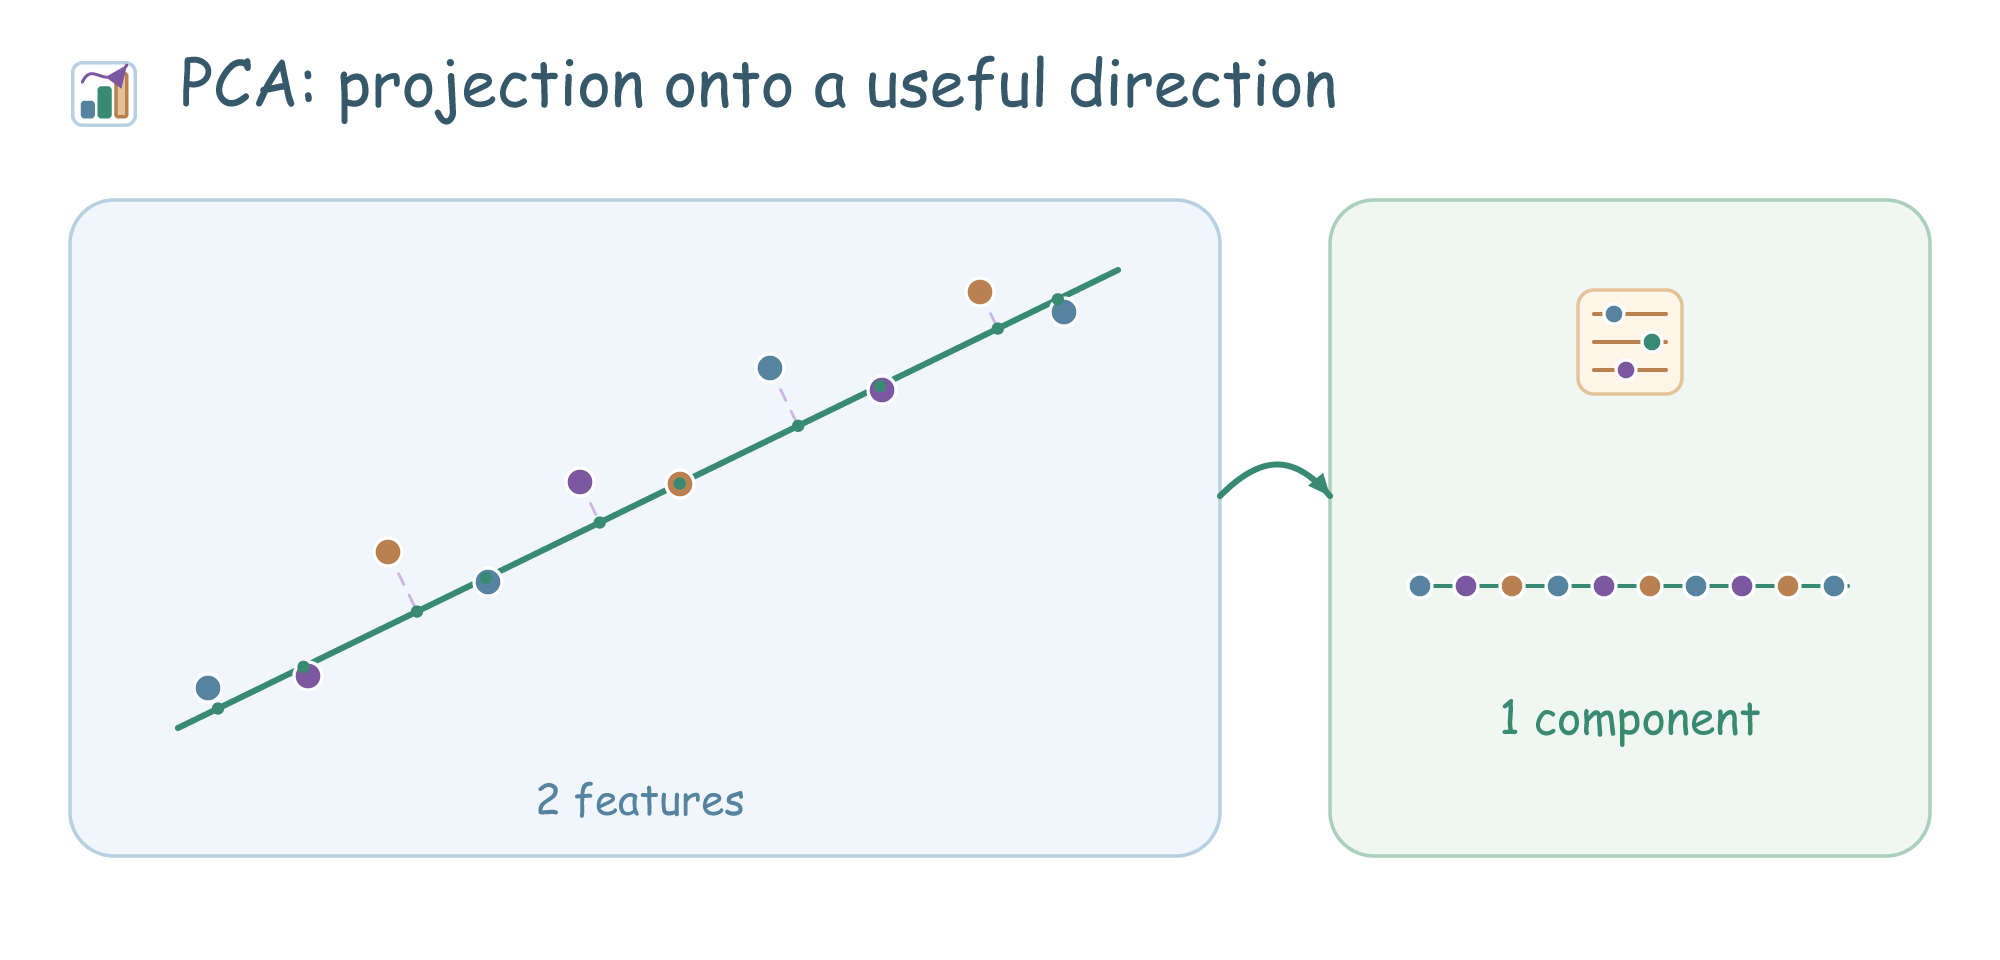
主成分分析(Principal Component Analysis,PCA)依次寻找彼此垂直、尽量保留数据方差的投影方向,用较少坐标表示原数据。它是一种线性降维方法。
例如身高与臂展通常相关,散点沿一条斜线展开。投影到这条轴上,一个坐标就能保留大部分变化。
多维时继续寻找与已有方向垂直、剩余方差最大的方向,得到主成分。数学上,这些方向是中心化数据协方差矩阵的特征向量,对应特征值表示各方向的方差。特征向量经过该矩阵变换后保持在同一直线上,特征值就是它被缩放的倍数。保留前几个主成分便完成降维。
协方差计算两个变量偏离各自均值的乘积平均。经常一起高于或低于均值时,它为正。协方差矩阵将各特征两两的协方差排在一起;对角线是各特征的方差。
“解释方差比为 90%”表示保留了 90% 的总方差,不等于保留了 90% 的预测能力。PCA 不看标签,高方差方向未必最有助于分类。不同单位可能主导方差,因此是否标准化应结合特征含义决定;PCA 本身默认中心化,不会自动统一各列尺度。
特征选择
特征选择(feature selection)从原始特征中保留部分列,去掉无关或冗余信息。它保留原特征含义,而 PCA 会将特征组合成新坐标。
例如从年龄、身高、体重、编号中选出有用变量。常见选择方法有三类:
| 方法 | 如何选择 | 局限 |
|---|---|---|
| 过滤式 | 按方差、相关性、互信息等统计量筛选 | 单列无效的特征,组合后仍可能有用 |
| 包裹式 | 反复训练模型,比较不同特征子集 | 计算成本高,反复试验也会过拟合验证集 |
| 嵌入式 | 利用 L1 或树模型等训练结果选择 | 结果依赖模型与数据,重要性可能偏向某些特征 |
互信息衡量知道一个变量后,另一个变量的不确定性减少多少;它能捕捉部分非线性依赖。用标签筛选特征属于监督步骤,必须放进交叉验证的训练折,不能在全数据上提前完成。
异常检测
异常检测(anomaly detection)寻找与常见模式差异较大的样本。离群点检测处理本身混有异常的训练数据;新颖性检测用相对干净的正常数据训练,再检查新记录。
例如温度传感器通常在 20—30 度之间波动,突然记录 200 度,需要检查设备、单位或真实环境变化。罕见不等于错误,检测结果只是待核查线索。
孤立森林(Isolation Forest)随机选择特征和切分点,将样本逐步隔离。孤立点通常只需较少切分,因此路径较短。局部离群因子(Local Outlier Factor,LOF)比较一个点与邻居的局部密度;即使整体有稀疏区域,也可按附近环境判断异常。单类支持向量机(One-Class Support Vector Machine,One-class SVM)则学习一个包围正常数据的边界。
离群点检测与新颖性检测对数据和接口的要求不同。异常比例、阈值以及误报成本都需要业务依据,不能仅按训练分数自动决定。
流形学习与非线性降维
流形学习(manifold learning)假设高维数据围绕较低维的弯曲结构分布,通过保持邻近关系等信息建立低维表示。
一张卷起来的纸位于三维空间,沿纸面的位置仍只需两个坐标。PCA 只能找平直方向,无法直接展开这张纸。
等距映射(Isometric Mapping,Isomap)在邻居图上计算路径距离,再寻找低维表示,尝试保留沿曲面的距离。局部线性嵌入(Locally Linear Embedding,LLE)让每个点由附近点加权重构,并在低维中保持这种局部关系。t 分布随机近邻嵌入(t-distributed Stochastic Neighbor Embedding,t-SNE)强调近邻关系,常用于把高维特征展示为二维散点。
这些方法依赖邻居范围等设置。t-SNE 图中,两团之间的距离、团的面积和空隙大小通常不能直接解释成原数据的对应关系;二维分得开也不足以证明存在真实类别。降维若用于后续预测,还需确认方法如何处理未见样本,并在训练数据内拟合。