概率模型用分布描述数据和不确定性。例如,同样出现“中奖”两个字,一封邮件属于垃圾邮件的可能性仍取决于发件人、其他词语和垃圾邮件的比例。
条件概率与贝叶斯公式
表示已知 发生时, 发生的概率。
它一般不等于 :垃圾邮件常出现“中奖”,不代表出现“中奖”的邮件一定是垃圾邮件。
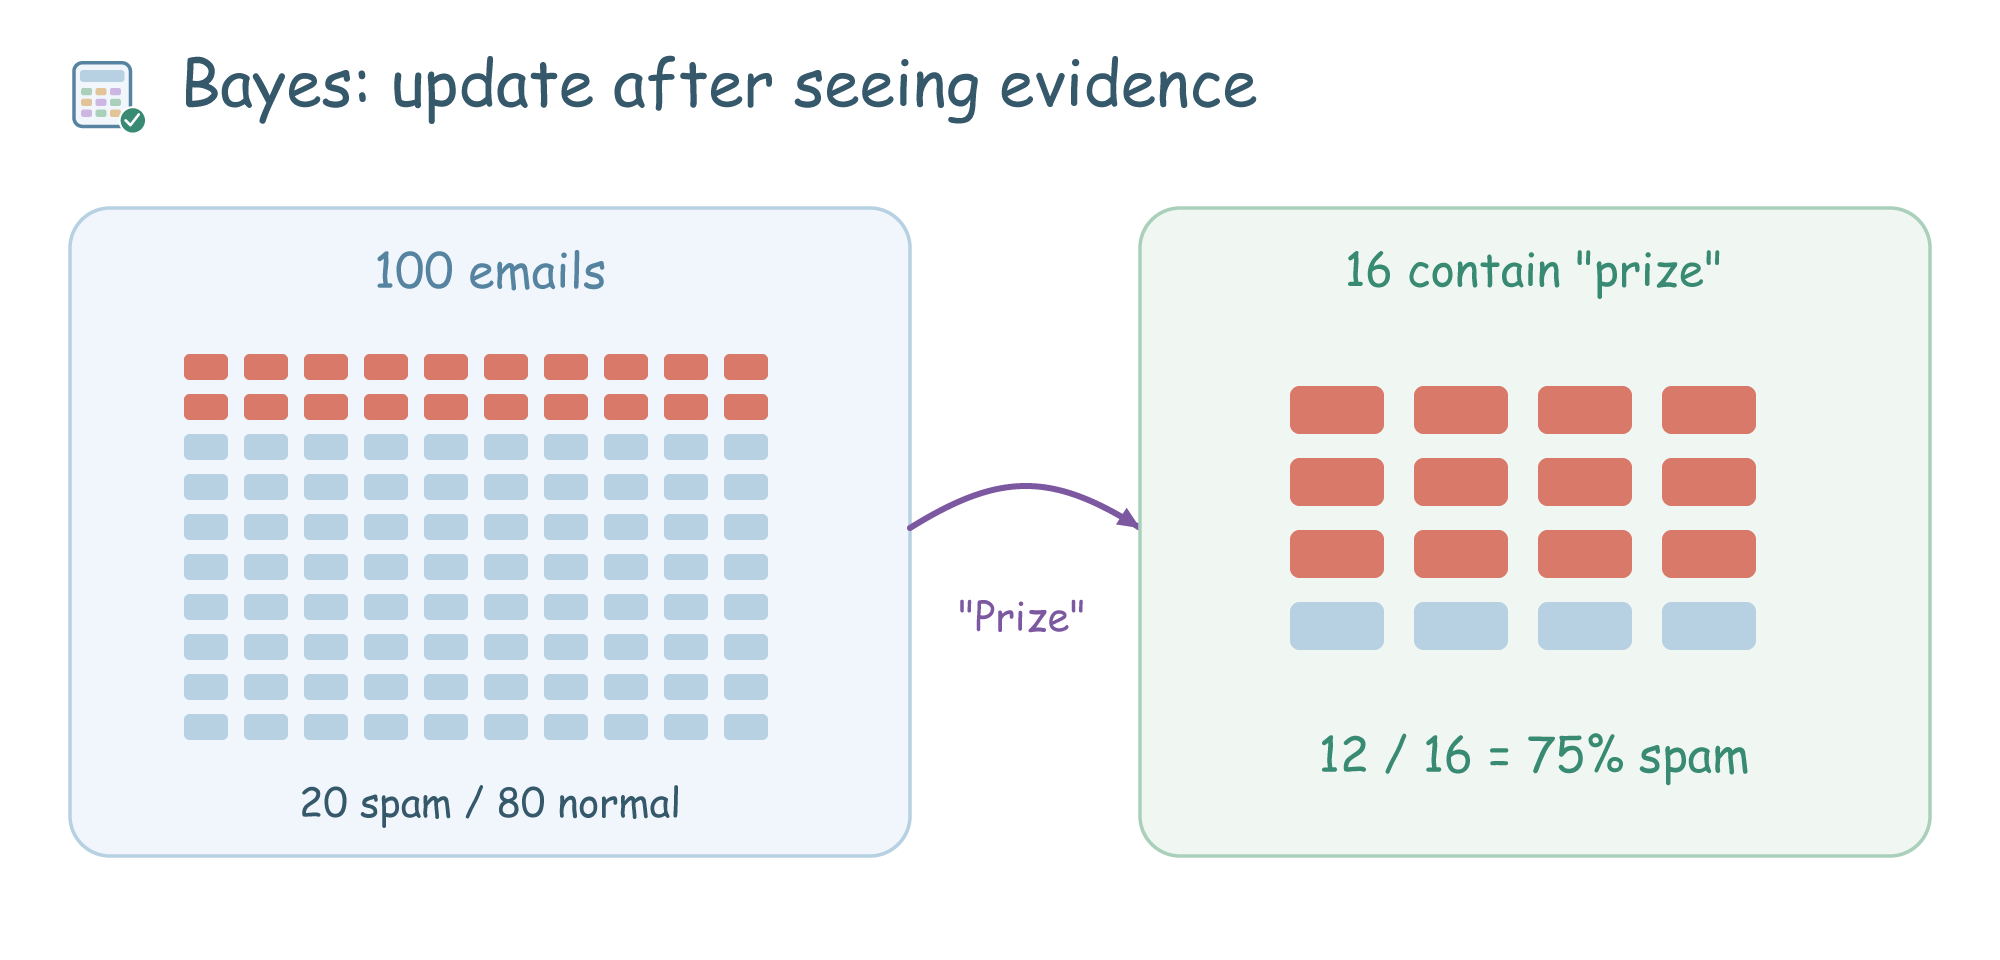
假设 100 封邮件中有 20 封垃圾邮件,其中 12 封含“中奖”;其余 80 封正常邮件中有 4 封含“中奖”。看到这个词时,垃圾邮件的概率是 。
贝叶斯公式把这个计数过程写为:
是观察前的先验, 是观察后的后验。分母 汇总所有可能来源,让各类后验概率加起来为 1。上例中,先验为 20%,观察到词语后变成 75%。
最大似然、最大后验与贝叶斯估计
似然固定已看到的数据,比较不同参数解释这些数据的能力。最大似然估计(Maximum Likelihood Estimation,MLE)选择似然最大的参数;最大后验估计(Maximum A Posteriori,MAP)结合参数先验,选择后验最高的参数。贝叶斯估计保留整个参数后验,用它描述不确定性和计算预测。
抛硬币 10 次,出现 7 次正面。用 表示硬币出现正面的概率,这串观测的似然为 。MLE 得到 。
如果先验认为硬币大致公平,MAP 在少量观测下的估计会向 0.5 收缩。数据增加后,似然通常有更大影响。贝叶斯预测则对不同 的预测按后验加权平均。
连续参数用概率密度描述。密度曲线在某个区间下的面积是参数落入该区间的概率,计算这种累积面积称为积分;某一点的密度值本身不是概率。贝叶斯预测对连续参数按后验加权时,也用积分完成这种平均。
同一组数据的三个结果
Beta 分布描述 0 到 1 之间的概率参数。设先验为 ,其密度正比于 ;看到 7 次正面、3 次反面,后验变成 。
- MLE:。
- MAP:后验峰值为 。
- 下一次正面的贝叶斯预测:后验均值为 。
峰值和均值回答不同问题。完整后验还保留了“这个估计有多不确定”的信息。
对似然取对数可把连乘改为求和,最大值的位置不变。高斯误差假设下,最大化线性回归的似然等价于最小化平方误差;参数的高斯先验则对应 L2 正则化。
朴素贝叶斯
朴素贝叶斯(Naive Bayes,NB)是基于贝叶斯公式的分类方法,假设给定类别后各特征条件独立。训练学习各类别的比例,以及各特征在该类别下的分布。
预测时计算:
是类别, 是第 个特征, 表示连乘, 表示两边相差一个对所有类别相同的归一化系数。模型选择得分最高的类别。
邮件中的“免费”和“中奖”实际可能相关,模型仍把两条证据分开计算,因此预测概率可能过于自信。词频常用 MultinomialNB,连续特征常用 GaussianNB。
若训练集中某类从未出现某个词,直接计数会得到零概率,使整项乘积归零。拉普拉斯平滑给各词计数加上小常数,再重新归一化。
贝叶斯网络与马尔可夫随机场
图模型用节点表示随机变量,用边表达依赖结构。贝叶斯网络(Bayesian Network,BN)使用无环有向图;马尔可夫随机场(Markov Random Field,MRF)使用无向图。
例如“下雨、洒水器、草地湿润”可以拆成几个局部关系,避免为所有变量组合单独列出概率。
若雨 和洒水器 都指向草地湿润 ,并假设 与 独立,则联合概率为:
观察到湿草地,可以反推下雨的概率;若又知道洒水器打开,下雨作为解释的必要性会降低。图上的箭头表达模型的条件关系,因果解释还需要额外假设。
例如给噪声图像的每个像素设置一个隐藏的真实灰度,邻接边鼓励相邻像素取相近值,同时要求它们接近观测。
每个局部配置得到一个非负兼容分数,所有分数相乘,再除以归一化常数 ,得到联合概率。局部分数不必各自加起来为 1; 保证整体是合法分布。变量多时,计算 可能很困难。
学习估计图结构或参数;推断在观测部分变量后,计算其余变量的分布。图画得简单,不一定意味着推断计算便宜。
隐马尔可夫模型
隐马尔可夫模型(Hidden Markov Model,HMM)描述带有隐藏状态的序列。当前隐藏状态只依赖前一状态,当前观测只依赖当前隐藏状态。
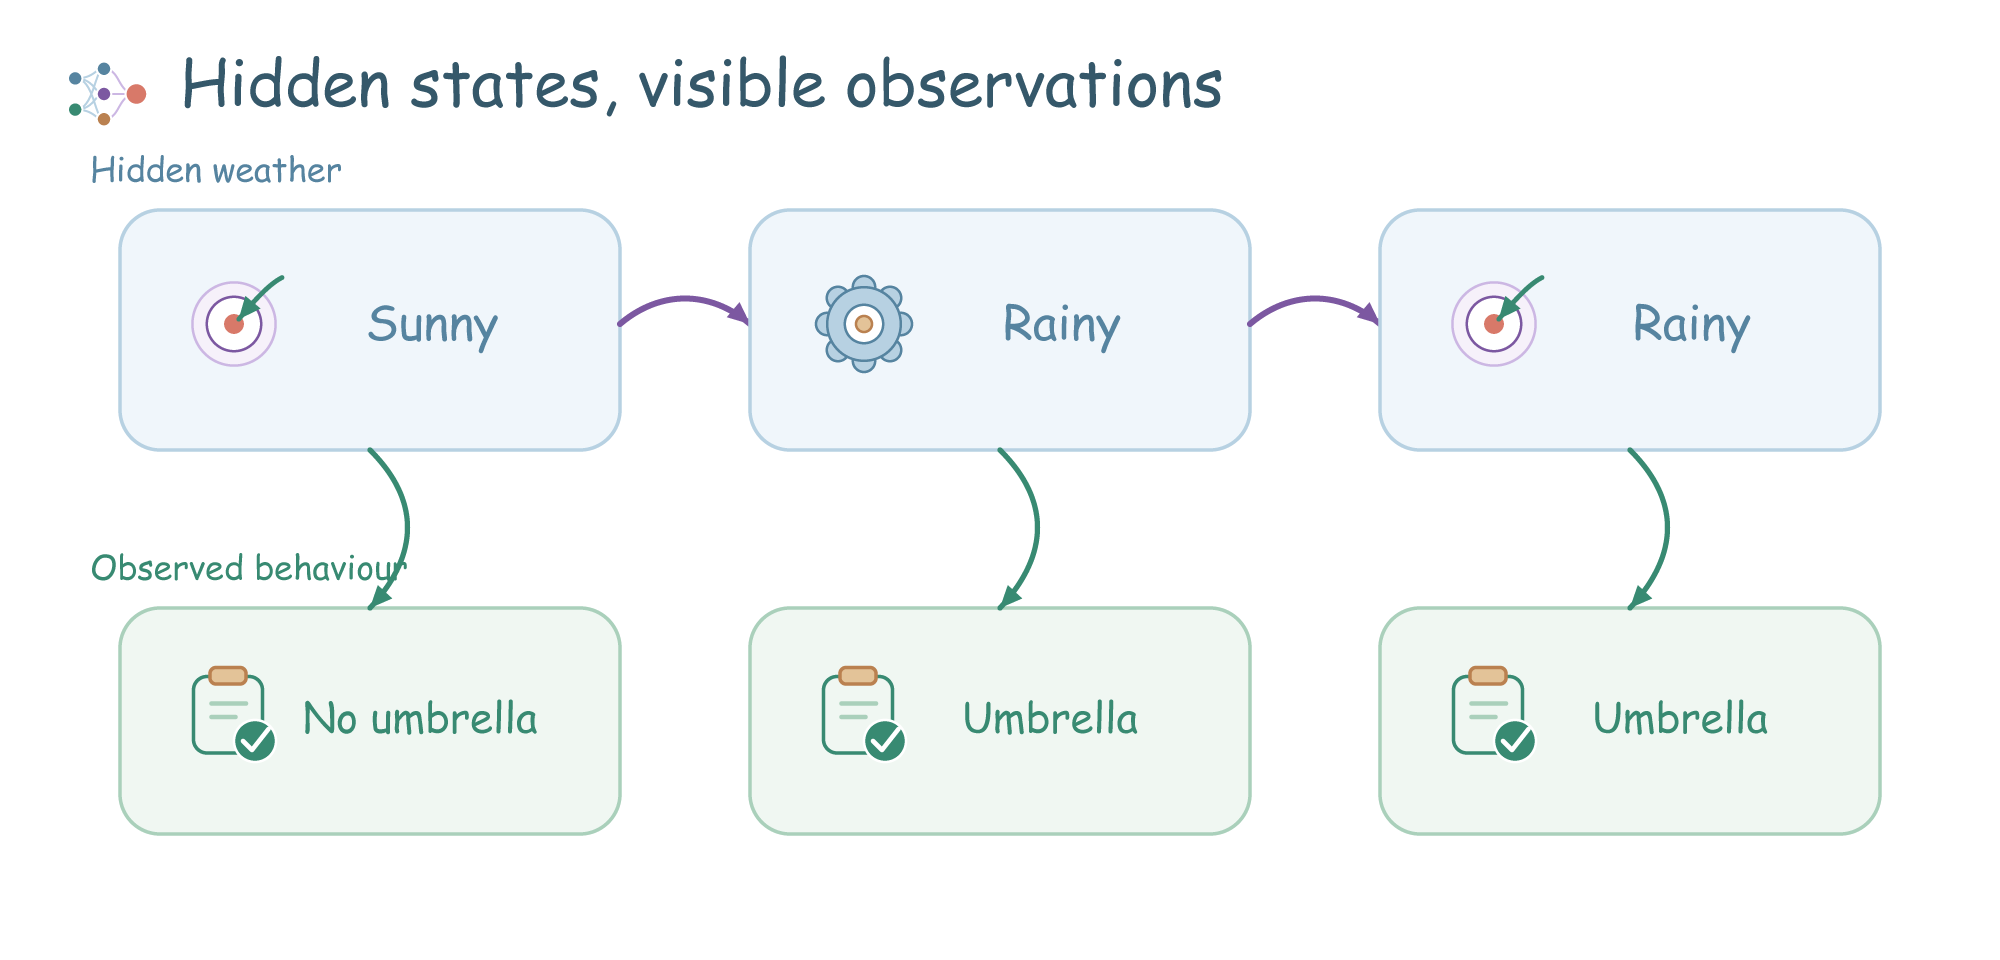
例如天气是隐藏状态,每天是否有人撑伞是观测。模型假设当前天气只依赖前一天天气,当天撑伞情况只依赖当天天气。
模型包含初始状态概率、状态转移概率和观测概率。例如“雨天后仍是雨天”为 0.8,“雨天有人撑伞”为 0.9。连续几天看到伞,会提高这些天处于雨天状态的后验概率,但不会使结论确定。
| 问题 | 常用计算 |
|---|---|
| 这串观测有多可能? | 前向算法累加不同隐藏路径的概率 |
| 每个时刻处于什么状态的概率较高? | 前向—后向算法利用前后观测 |
| 哪条完整隐藏路径最可能? | Viterbi 算法保留最优路径 |
| 转移和观测概率未知怎么办? | Baum–Welch,即 HMM 的期望最大化(Expectation–Maximization,EM)学习 |
逐时刻选最可能状态,与选择概率最大的完整路径,可能得到不同答案。
主题模型与潜在狄利克雷分配
潜在狄利克雷分配(Latent Dirichlet Allocation,LDA)把文章表示为主题比例,把主题表示为词语概率分布。
一篇文章可以同时谈体育和商业。例如一篇文章的主题比例为“体育 70%、商业 30%”,体育主题对“比赛”“球员”分配较高概率。
模型假设每个词有一个隐藏主题:按文章的主题比例选择主题,再按该主题的词分布生成词。训练根据整批文章的词语共现,反推主题和每篇文章的比例。狄利克雷先验控制这些比例倾向集中在少数主题,还是分散到多个主题。
常见输入是文档—词频矩阵,每行一篇文章,每列一个词;基本 LDA 不保留词序。主题编号没有自带名称,需要查看高概率词后解释。
马尔可夫链蒙特卡洛:用样本近似后验
马尔可夫链蒙特卡洛(Markov Chain Monte Carlo,MCMC)构造一条随机移动的链,使它在满足条件并充分运行后,停留在各区域的频率接近目标分布。
复杂后验往往无法直接积分,可以用链产生的样本均值近似后验期望,用样本分位数描述区间。
Metropolis–Hastings 每次提出新参数,按目标密度和提议分布计算接受概率;被拒绝时保留原参数。即使新位置密度较低,也可能接受,从而探索不同区域。Gibbs 采样则轮流从每个变量在其余变量给定时的条件分布取样。
相邻样本通常相关。链可能长时间停留在某个区域,因此采样次数不能直接当作独立样本数。多条链、有效样本量和收敛诊断用来检查结果是否可信。
变分推断
变分推断(Variational Inference,VI)选一个便于计算的分布族 ,调整它的参数来接近目标后验。
例如用高斯分布近似复杂后验,需要学习它的均值和方差。
常用目标是最大化 证据下界(Evidence Lower Bound,ELBO):一项奖励对观测数据的解释能力,另一项约束近似分布与先验的偏离。这等价于在选定的分布族内,减小 到真实后验的 Kullback–Leibler 散度(KL divergence)。它衡量分布差异,通常不对称。
平均场近似把多个未知变量的联合分布拆成独立分布的乘积,计算更容易,但可能漏掉变量间的相关性。VI 常比长链采样更方便扩展到大数据,结果的精度也受分布族和优化过程限制。