前馈网络与激活函数
前馈网络(Feedforward Network)把输入依次经过多层计算得到输出。每个神经元先加权求和、加偏置,再通过激活函数;激活函数通常引入非线性。
输入为 3、4,权重为 2、−1,偏置为 −3,加权结果就是 −1。修正线性单元(Rectified Linear Unit,ReLU)把负数变为 0,所以这个神经元输出 0。
多个神经元组成一层,层的输出作为下一层输入。输入和输出之间的层称为隐藏层。只堆叠线性运算仍相当于一次线性运算;加入非线性激活后,网络才能表达弯曲的分类边界。
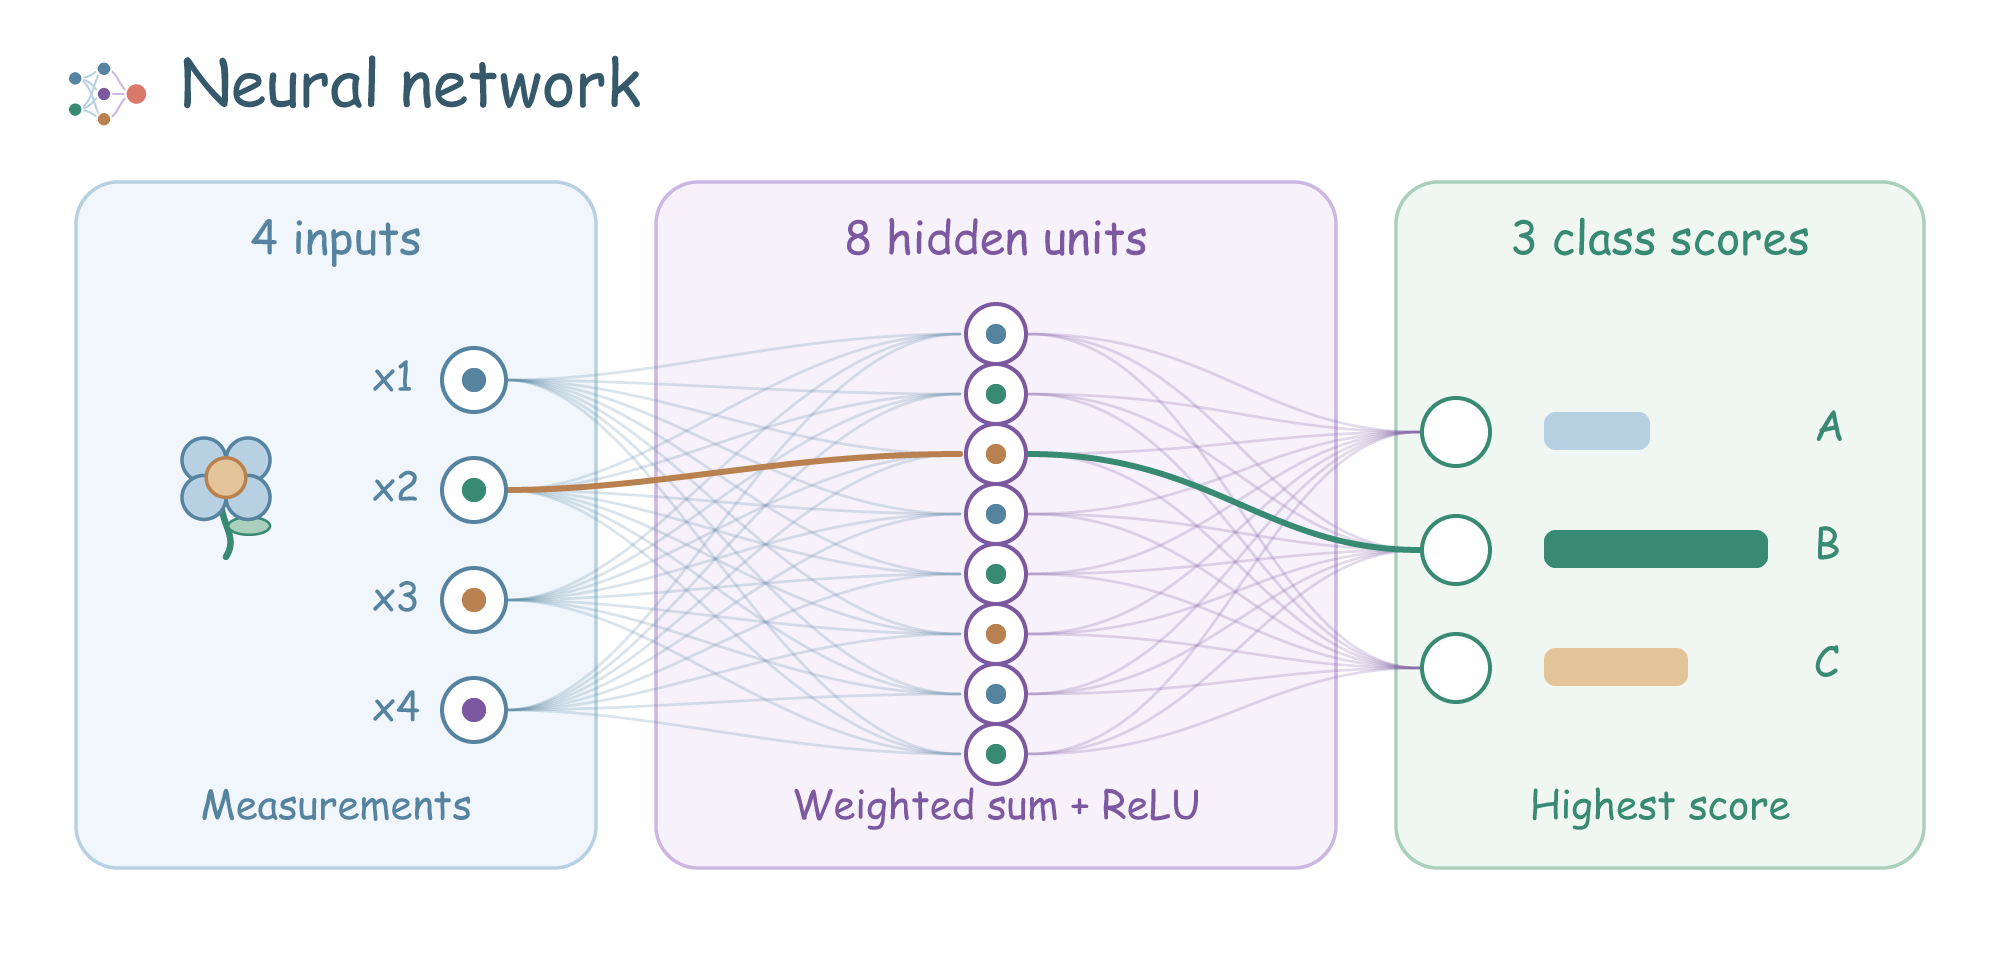
一层可写为 。 是特征向量, 的每一行存一个神经元的权重, 存各神经元的偏置, 是这一层的输出向量。矩阵乘法把这些加权求和一起算完。4 个输入、8 个神经元时, 的形状为 。
输出层取决于任务:回归可以直接输出数值;多分类输出每类的分数,再用 Softmax 转为概率。隐藏层数、宽度是训练前选择的超参数,权重和偏置通过训练得到。
反向传播
反向传播(Backpropagation)应用链式法则,从损失往回计算每个参数的梯度。梯度描述参数改变时损失的局部变化方向和幅度。
前向传播用当前参数计算预测,损失函数比较预测与标签。反向传播得到梯度后,优化器据此更新参数。
例如输入为 ,权重为 ,标签为 ,预测 ,损失 。有 ,这个偏导数表示只改变 时损失的局部变化率。当 时,预测为 2,梯度为 −4。学习率取 0.1,更新得到 ,新预测 2.8,比原来接近标签。
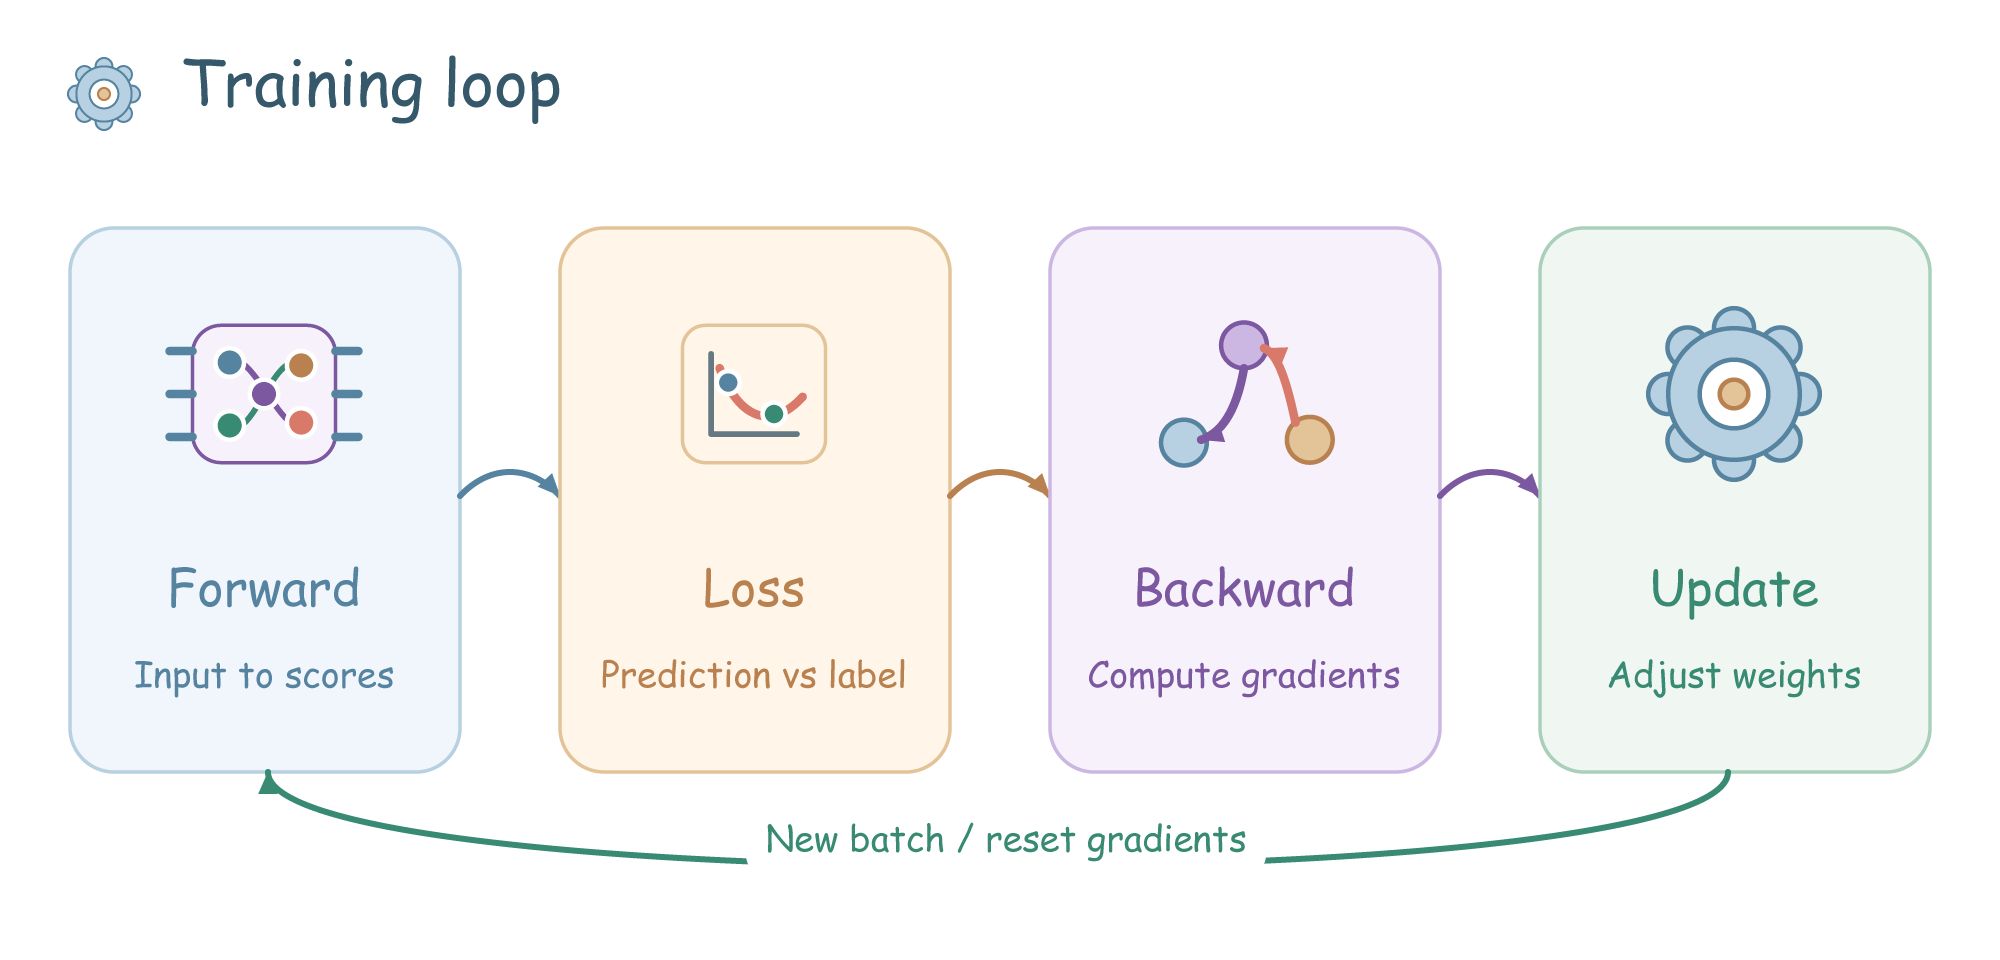
链式法则把“权重影响中间结果”和“中间结果影响损失”连起来。一个参数通过多条路径影响损失时,各路径的贡献相加。深层网络重复使用这条规则,无需为每个权重手写公式。
import torch

x = torch.tensor(3.0, requires_grad=True)
y = x * x
y.backward()
print(x.grad)  # tensor(6.)
requires_grad=True 记录求导所需的计算,backward() 计算梯度。这里得到 在 处的导数 6;它不会自动修改 。
熵与交叉熵
熵(Entropy)衡量概率分布的不确定性;交叉熵(Cross-Entropy)衡量用预测分布描述真实结果时的平均损失。
概率分布的熵为 。 是第 种结果的概率,求和覆盖所有结果;概率为 0 的项按极限记为 0。两类概率各一半时难以判断;概率为 1 和 0 时结果确定,熵为 0。对数把多个独立事件的概率乘积变成相加,概率越低的真实结果带来的损失越大。
交叉熵 用真实分布 评价预测分布 , 是模型给第 类的概率。单个分类样本的真实类别为第 类时,损失简化为 。给正确类别 0.9 的概率,损失约 0.105;只给 0.1,损失约 2.303,这里使用自然对数。
库尔贝克–莱布勒散度(Kullback–Leibler Divergence,KL 散度)满足 ,衡量用 近似 的差异。它非负,但交换两个分布通常会改变值,因此不是普通的距离。当 固定时,减小交叉熵也就在减小这方向的 KL 散度。
PyTorch 与训练循环
PyTorch 是提供张量计算、自动求导和神经网络组件的框架。训练循环重复计算预测、损失、梯度和参数更新;张量是带形状的数值数组。
16 朵花各有 4 个特征,输入形状为 (16, 4);分成三个类别,输出分数形状为 (16, 3)。以下片段假定 X_train 已按训练集统计量缩放,y_train 是 0、1、2 类标签。优化器使用自适应矩估计(Adaptive Moment Estimation,Adam),它利用梯度的历史统计调整更新步长。
import torch
from torch import nn

X = torch.as_tensor(X_train, dtype=torch.float32)
y = torch.as_tensor(y_train, dtype=torch.long)
model = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 3))
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
criterion = nn.CrossEntropyLoss()

model.train()
for epoch in range(100):
    optimizer.zero_grad()
    logits = model(X)
    loss = criterion(logits, y)
    loss.backward()
    optimizer.step()

model.eval()
with torch.no_grad():
    prediction = model(X).argmax(dim=1)
PyTorch 默认累加梯度,因此每次更新前用 zero_grad() 清空旧值。CrossEntropyLoss 接收原始分数,内部处理 Softmax 对应的计算,前面不用再加 Softmax。这里用全部训练样本更新;大数据通常拆成小批次,完整遍历一次训练集称为一个 epoch。
eval() 切换暂退法(Dropout)、批量归一化(Batch Normalization,BatchNorm)等层的行为,no_grad() 关闭梯度记录,两者作用不同。上面的 prediction 仍是训练集预测;泛化表现要用独立验证数据评估。
卷积网络:复用局部计算
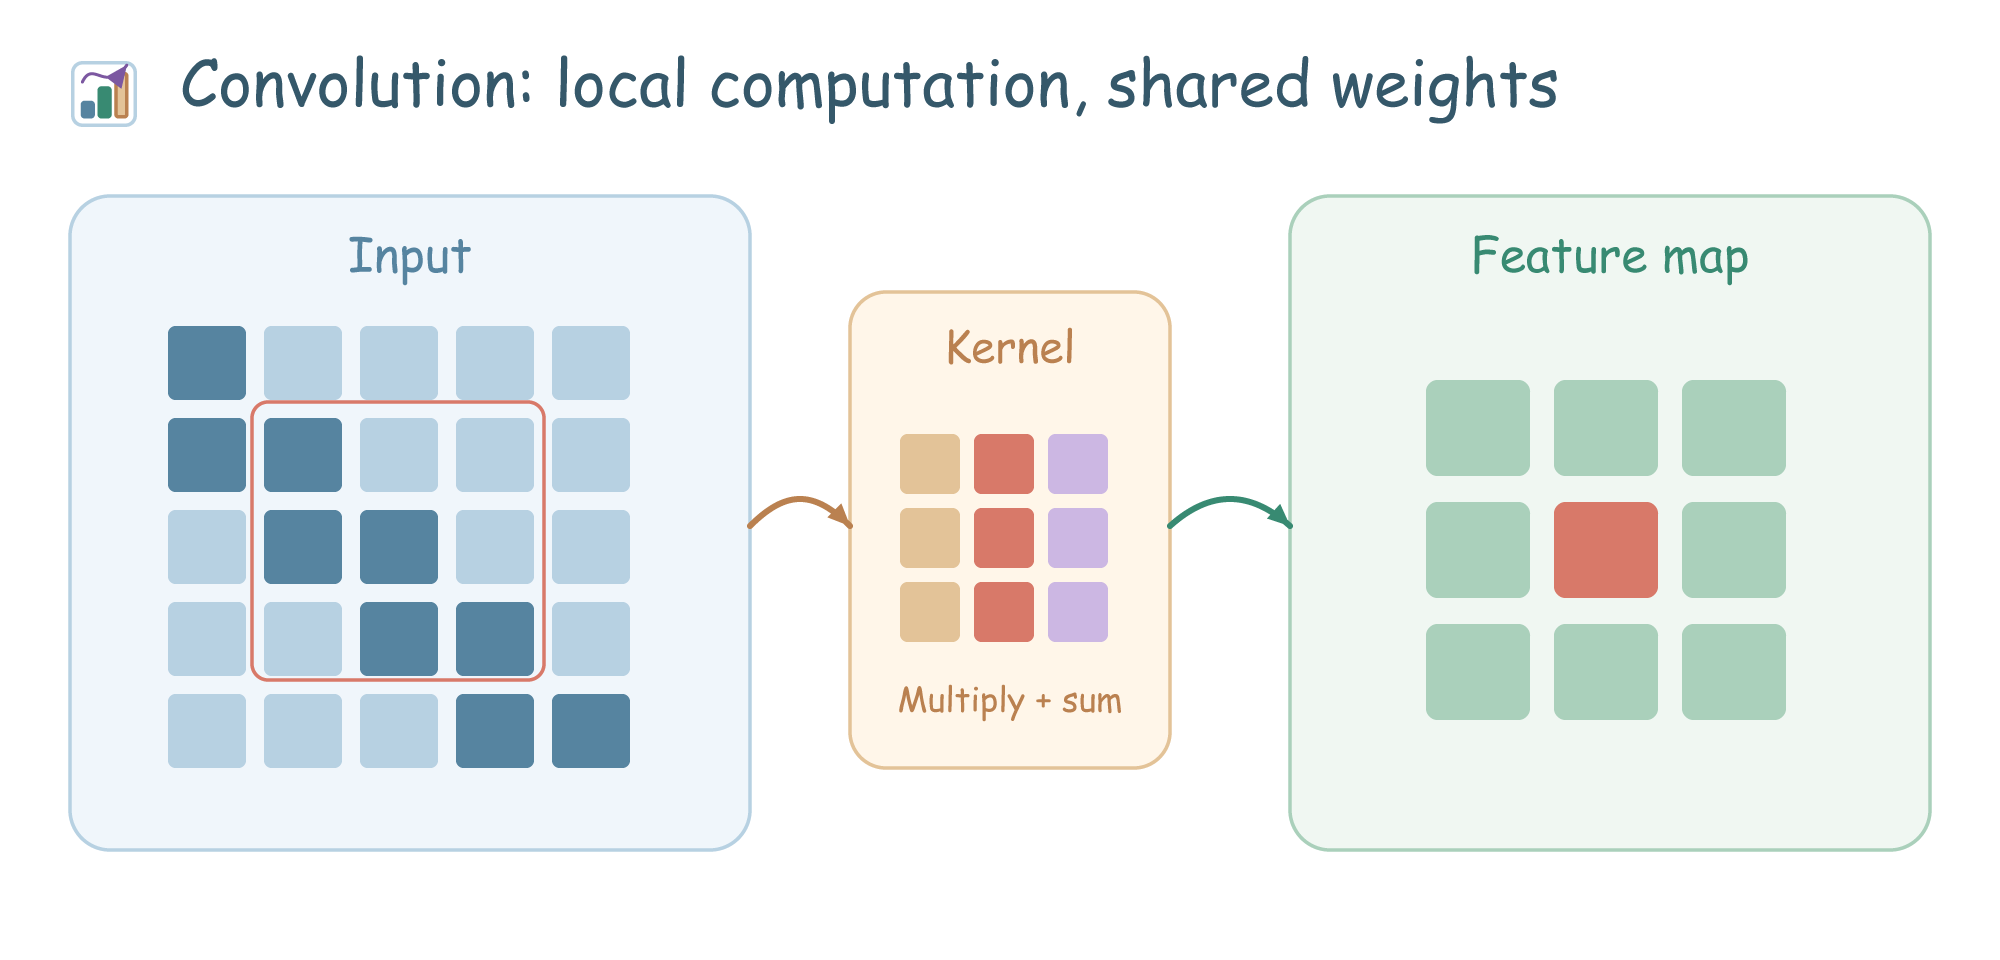
卷积神经网络(Convolutional Neural Network,CNN)在不同位置复用局部计算,提取图像等数据中的模式。卷积核是一组可学习的权重,计算结果组成特征图。
计算时,一个小矩阵在图像上滑动,每到一个位置,就把覆盖的像素与矩阵元素逐项相乘再求和。
例如核 [1, -1] 作用于相邻像素 [8, 8] 得到 0,作用于 [8, 1] 得到 7,能对亮度变化产生响应。同一组权重在不同位置复用,因此图像中的同类局部模式可以在不同位置被检测到。
多层卷积扩大每个输出能看到的区域,即感受野。通道表示不同特征图;步幅控制每次移动多远;填充在边缘补值以控制输出大小。池化将小区域压缩为最大值或平均值,减少空间尺寸,也会丢失细节。
循环网络:用状态表示历史
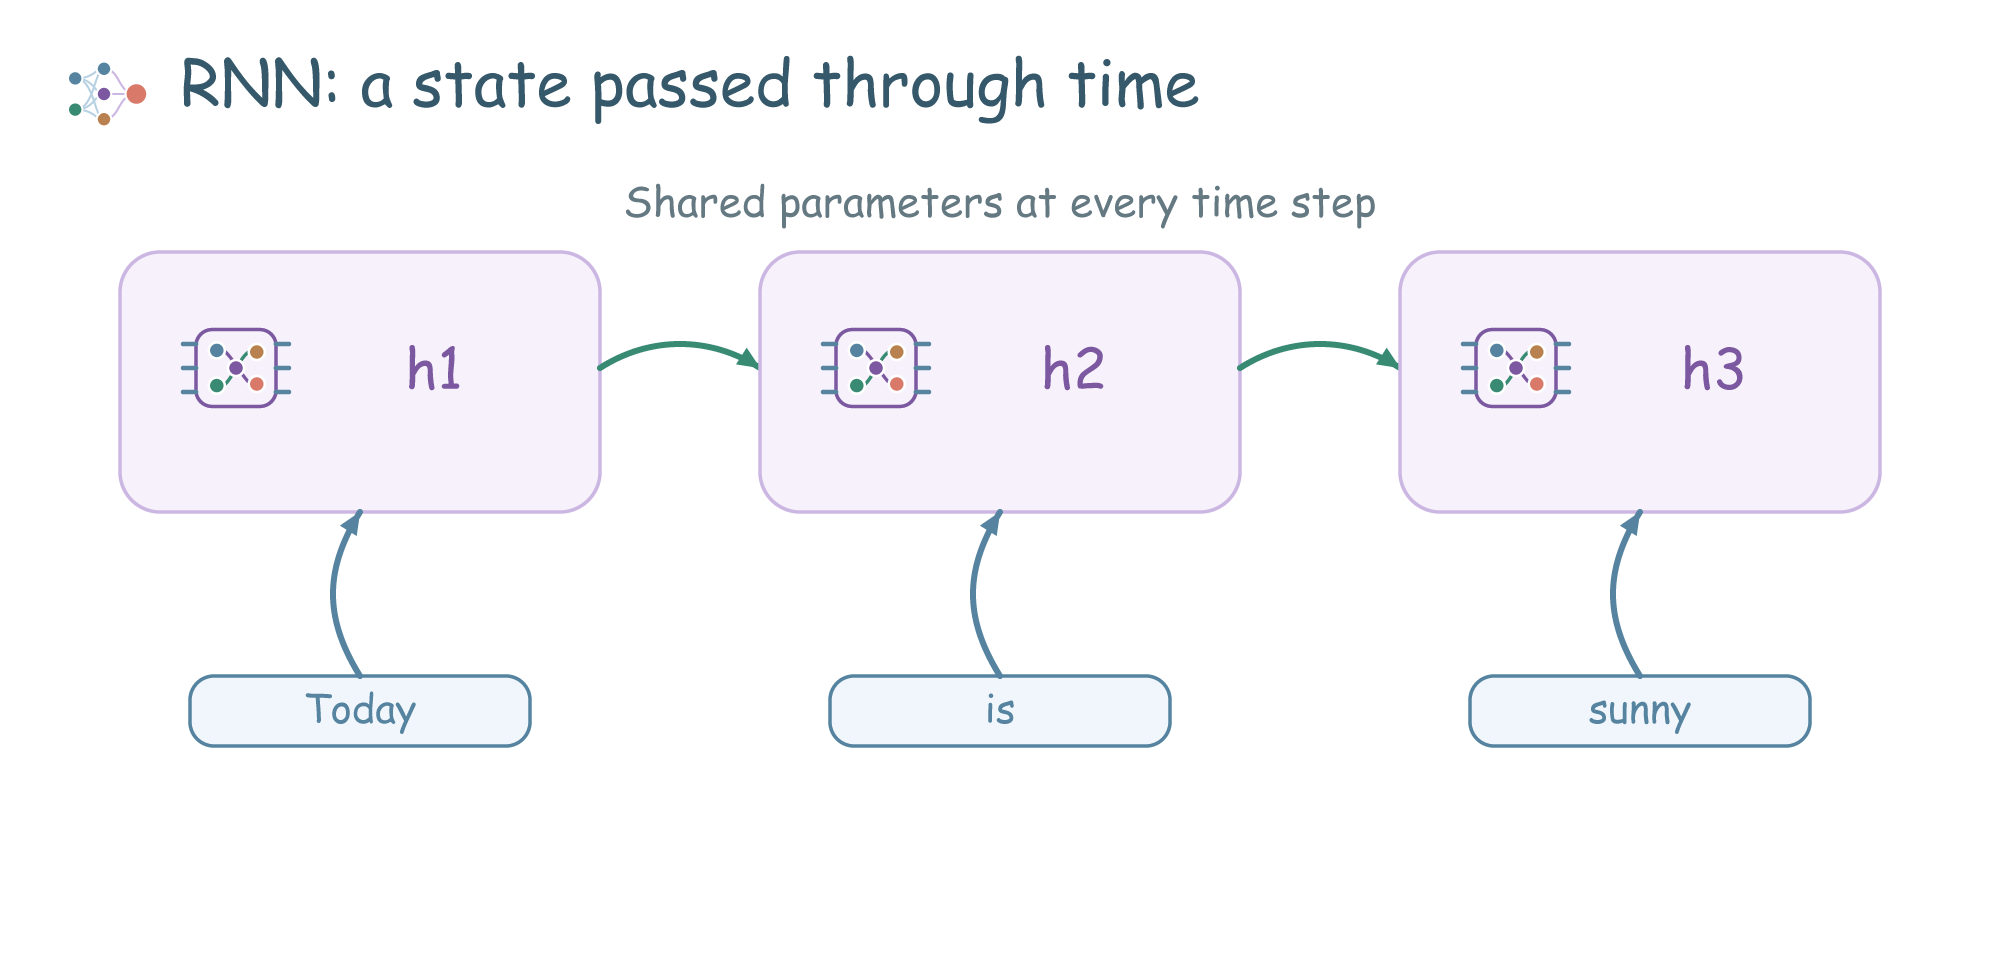
循环神经网络(Recurrent Neural Network,RNN)逐步处理序列,用隐藏状态向量记录历史。当前输入和上一时刻的状态共同生成新状态。
处理“今天/天气/很好”时,后一个词的表示会受前面词语影响。各时刻复用同一套参数,输入长度可以变化。
训练时将时间步骤展开,再沿展开的计算图反向传播。序列很长时,梯度可能变得极小或极大,早期信息难以学习。长短期记忆网络(Long Short-Term Memory,LSTM)和门控循环单元(Gated Recurrent Unit,GRU)是带门控的 RNN 变体,用 0 到 1 之间的系数控制旧信息保留多少、新信息写入多少;梯度裁剪用于限制过大的梯度。
RNN 适合顺序数据,但状态更新存在前后依赖,难以像全连接层那样把所有时刻完全并行计算。
嵌入、注意力与 Transformer
嵌入(Embedding)把离散编号映射为可学习的向量。注意力(Attention)按相关程度汇总其他位置的信息。Transformer 是以注意力和前馈网络为主要组件的网络架构。
词编号 17 只用来查表,不表示它比编号 8“大”。训练改变向量的位置,让有用的关系反映在向量中;商品、用户和图像小块也能使用类似表示。
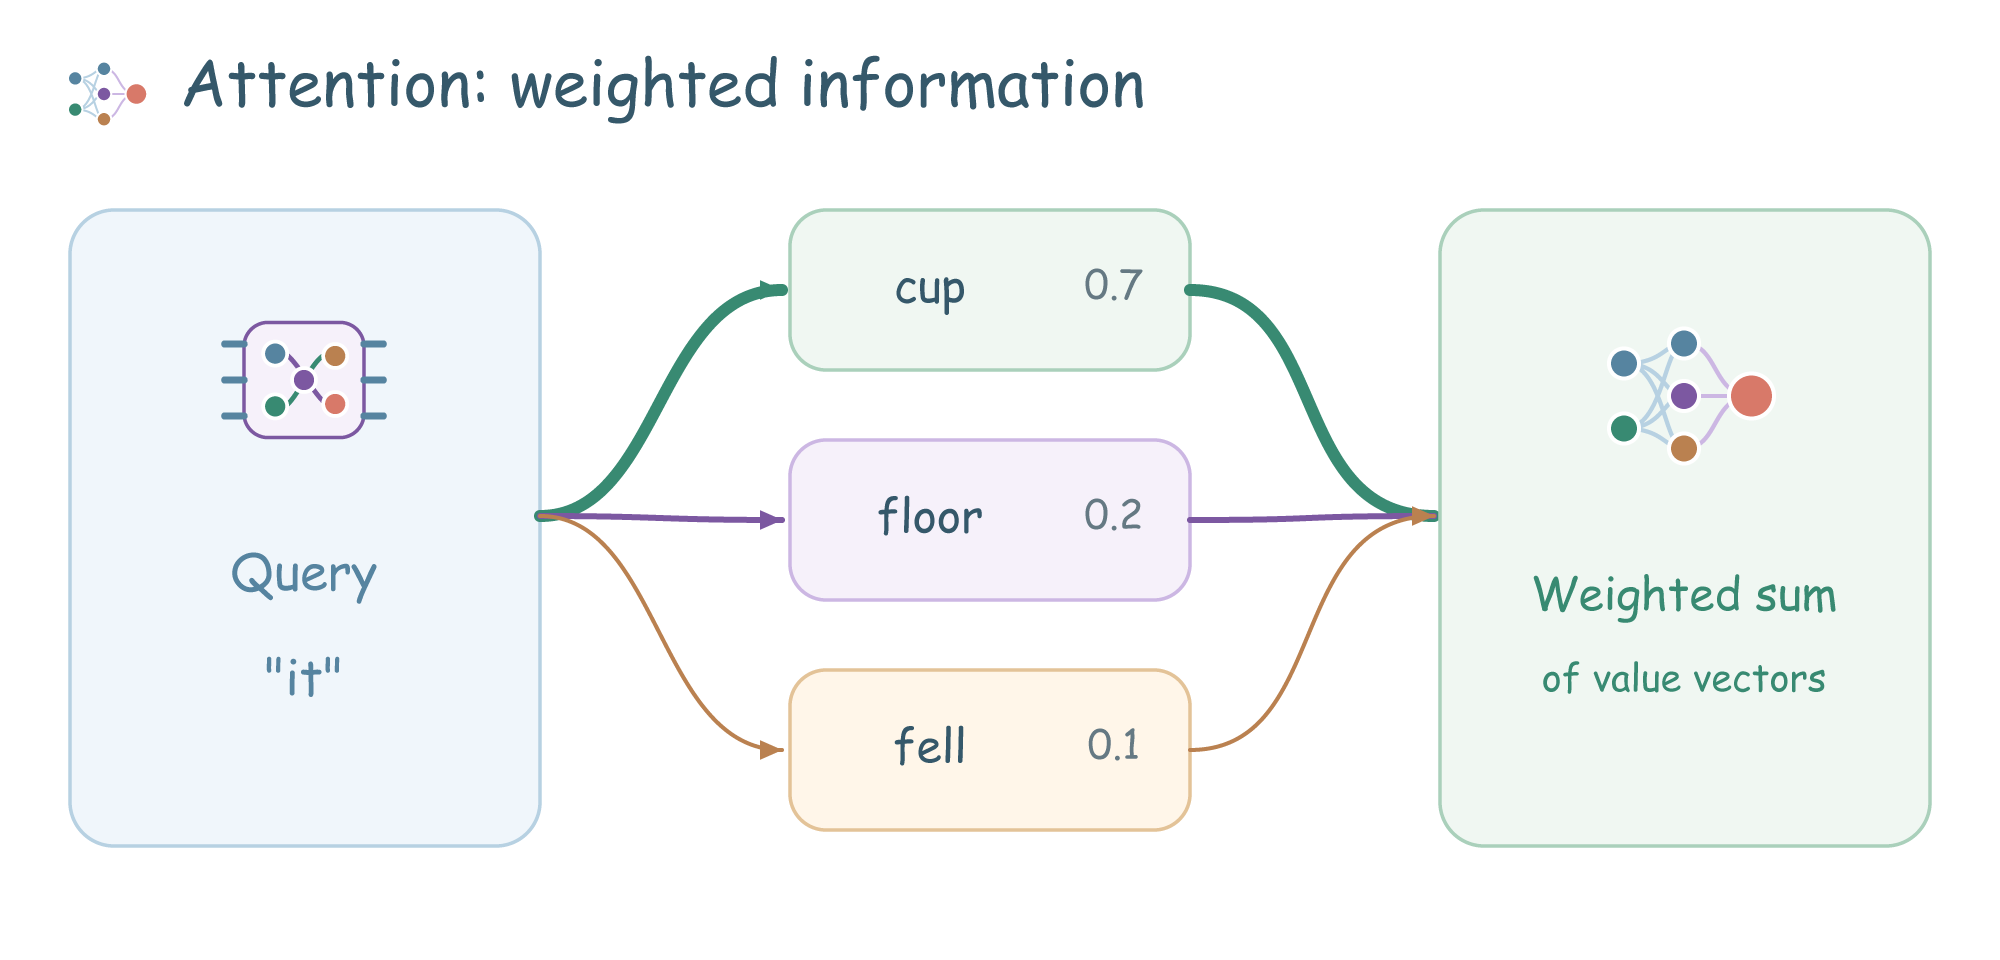
注意力让一个位置按相关程度汇总其他位置的信息。每个位置生成查询向量(Query,Q)、键向量(Key,K)、值向量(Value,V):Q 与各 K 做点积得到匹配分数,按向量维度缩放后,Softmax 把分数变成和为 1 的权重,再对 V 加权求和。点积就是对应分量相乘后相加;同向且较大的向量通常得到较高分数。
例如处理“杯子掉到地上,它碎了”中的“它”,模型可以给“杯子”较高权重,把杯子的信息融入当前位置。这种联系由训练学到,并不保证符合人的语法分析。多头注意力用多组可学习的矩阵分别生成 Q、K、V,允许同时提取不同关系。
Transformer 将注意力、逐位置前馈网络、残差连接和归一化组合起来。残差连接把模块输入直接加到输出,帮助信息和梯度传递。位置编码提供词序信息;生成文本时用因果掩码遮住未来词,防止训练时偷看答案。
标准全注意力要计算每对位置的关系。序列长度翻倍,匹配分数数量约变为四倍。这也是窗口注意力等改进方法的出发点。
优化器、初始化与归一化
优化器规定怎样根据梯度更新参数;初始化设置训练开始时的参数;归一化调整中间计算的数值尺度。三者分别影响更新过程、起点和数值稳定性。
梯度指出局部上升方向,优化器通常沿其反方向或结合历史梯度更新。小批量随机梯度下降(Stochastic Gradient Descent,SGD)使用当前批次的梯度;动量法保留过去更新方向,减轻来回摆动;Adam 记录梯度及梯度平方的移动平均,为各参数调整步长。移动平均给近期结果较高权重,也保留一部分过去的信息。学习率仍需选择,Adam 也不能保证找到全局最优解。
初始化决定训练的起点。隐藏层权重若完全相同,神经元可能一直学到相同内容;随机初始化打破这种对称性。Xavier、He 初始化还根据层宽控制权重尺度,减少信号逐层放大或缩小的问题,He 初始化常与 ReLU 配合。
归一化通常减去均值,再除以带有小常数保护的标准差,调整网络内部数值尺度;随后用可学习的缩放和平移保留表达能力。BatchNorm 在训练时使用批次统计量,推理通常使用累计统计量;层归一化(Layer Normalization,LayerNorm)通常在单个样本或词元的特征维度上计算,不依赖批次大小。它们与输入数据的标准化属于不同位置的操作。
Adam · 初始化 · PyTorch:LayerNorm
神经网络中的正则化
正则化(Regularization)通过限制参数、扰动训练计算或约束训练过程,减轻模型对训练样本偶然细节的依赖。
权重衰减抑制过大的权重;Dropout 在训练时随机将部分中间输出置零,使后续计算不能总依赖同一组单元。PyTorch 的 Dropout 训练时会缩放保留的输出,调用 eval() 后停止随机丢弃。
数据增强通过裁剪、适当旋转等变换增加训练变化,前提是标签仍成立。把数字 6 旋转成 9 就可能改变标签。早停根据验证集表现选择训练轮数,避免训练损失持续下降、验证表现却变差。
这些方法都要通过验证集比较。过强的正则化也会欠拟合,测试集不能参与选择强度或训练轮数。