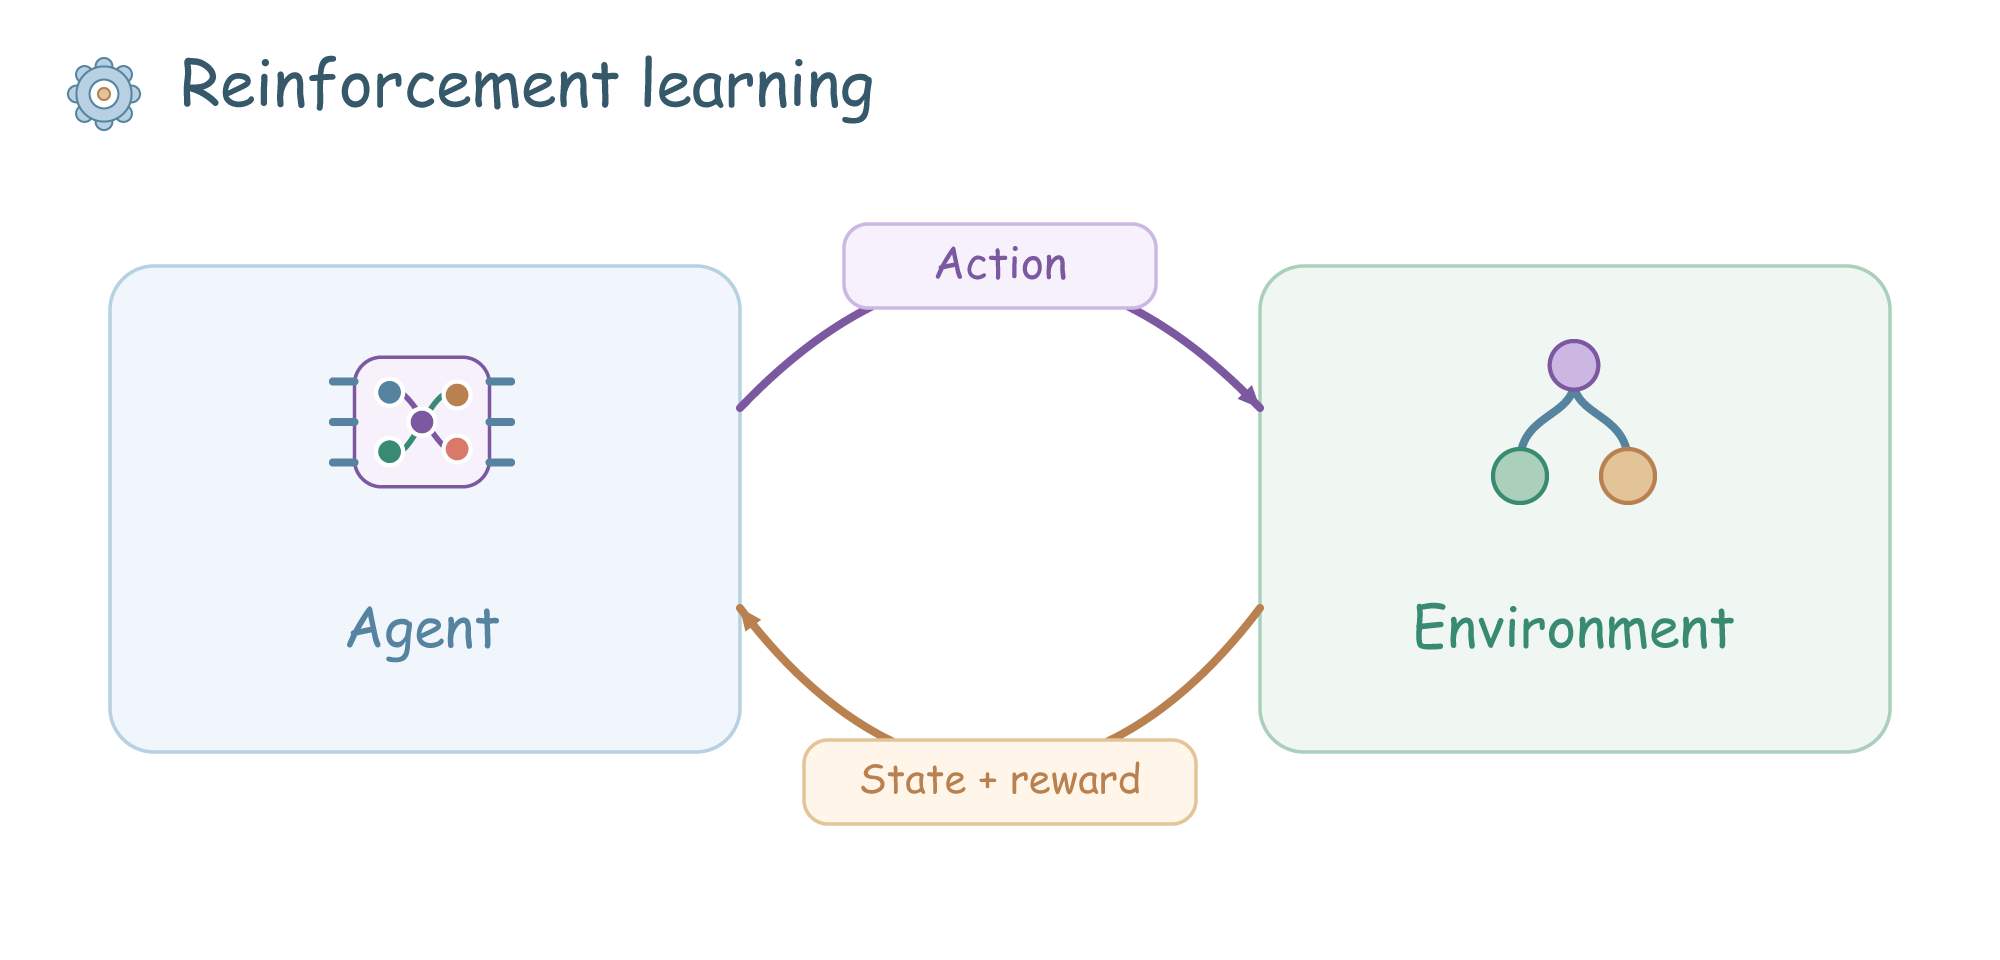
强化学习(Reinforcement Learning,RL)研究连续决策。智能体执行动作,环境返回新状态和奖励,动作还会影响后面能遇到什么情况。
例如走迷宫时,当前转弯是否有用,可能要到抵达出口才能判断。
马尔可夫决策过程、策略与回报
马尔可夫决策过程(Markov Decision Process,MDP)用状态、动作、转移概率和奖励描述决策环境。当前状态需包含预测下一步所需的历史信息。
用迷宫举例:
| 要素 | 迷宫中的例子 |
|---|---|
| 状态 | 所在格子;若钥匙影响通行,还要包含是否持有钥匙 |
| 动作 | 上、下、左、右 |
| 转移 | 动作后到达各格子的概率,地面湿滑时可能偏移 |
| 奖励 | 每走一步 −1,进入出口 +10 |
| 策略 | 在每个状态选择各动作的概率 |
只记录格子,却遗漏决定门能否打开的钥匙,就可能不满足这个要求。
策略(policy)规定给定状态下各动作的选择概率;回报(return)是从当前时刻开始累积的折扣奖励。
回报写为:
是折扣因子,越接近 1,远期奖励的权重越大。若接下来两步奖励为 −1、10,且之后结束, 时回报为 。训练目标是提高回报的期望;期望就是按各结果的概率加权平均。
价值函数与贝尔曼方程
状态价值 表示从状态 出发,持续按策略 行动的期望回报。动作价值 固定第一步动作 ,之后再按策略行动。
前者评价位置,后者评价当前位置的具体动作。
贝尔曼方程把整段回报拆成“一步奖励 + 后续价值”:
表示对策略可能选择的动作,以及环境可能产生的结果求平均。若某动作确定获得 −1 并到达价值为 5 的状态,,该动作的价值就是 。
最优动作价值 满足类似关系,但下一状态使用所有动作中的最大价值:。这让出口的收益可以通过相邻状态逐步传回更远的格子。
动态规划
动态规划(Dynamic Programming,DP)通过复用子问题的结果解决整体问题。在这里,它利用已知的转移概率和奖励,反复按贝尔曼关系更新状态价值。
策略迭代交替进行两件事:固定策略,计算它的状态价值;根据这些价值,在各状态选择期望回报更高的动作。价值迭代把选择最佳动作直接放进每次价值更新,价值稳定后再提取策略。
迷宫只有几十个格子时,可以用表保存全部价值。如果状态是摄像头图像,状态数量难以枚举,通常要用函数或神经网络近似价值。未知环境下,也无法直接计算对所有转移的期望,需要从交互样本学习。
蒙特卡洛与时序差分
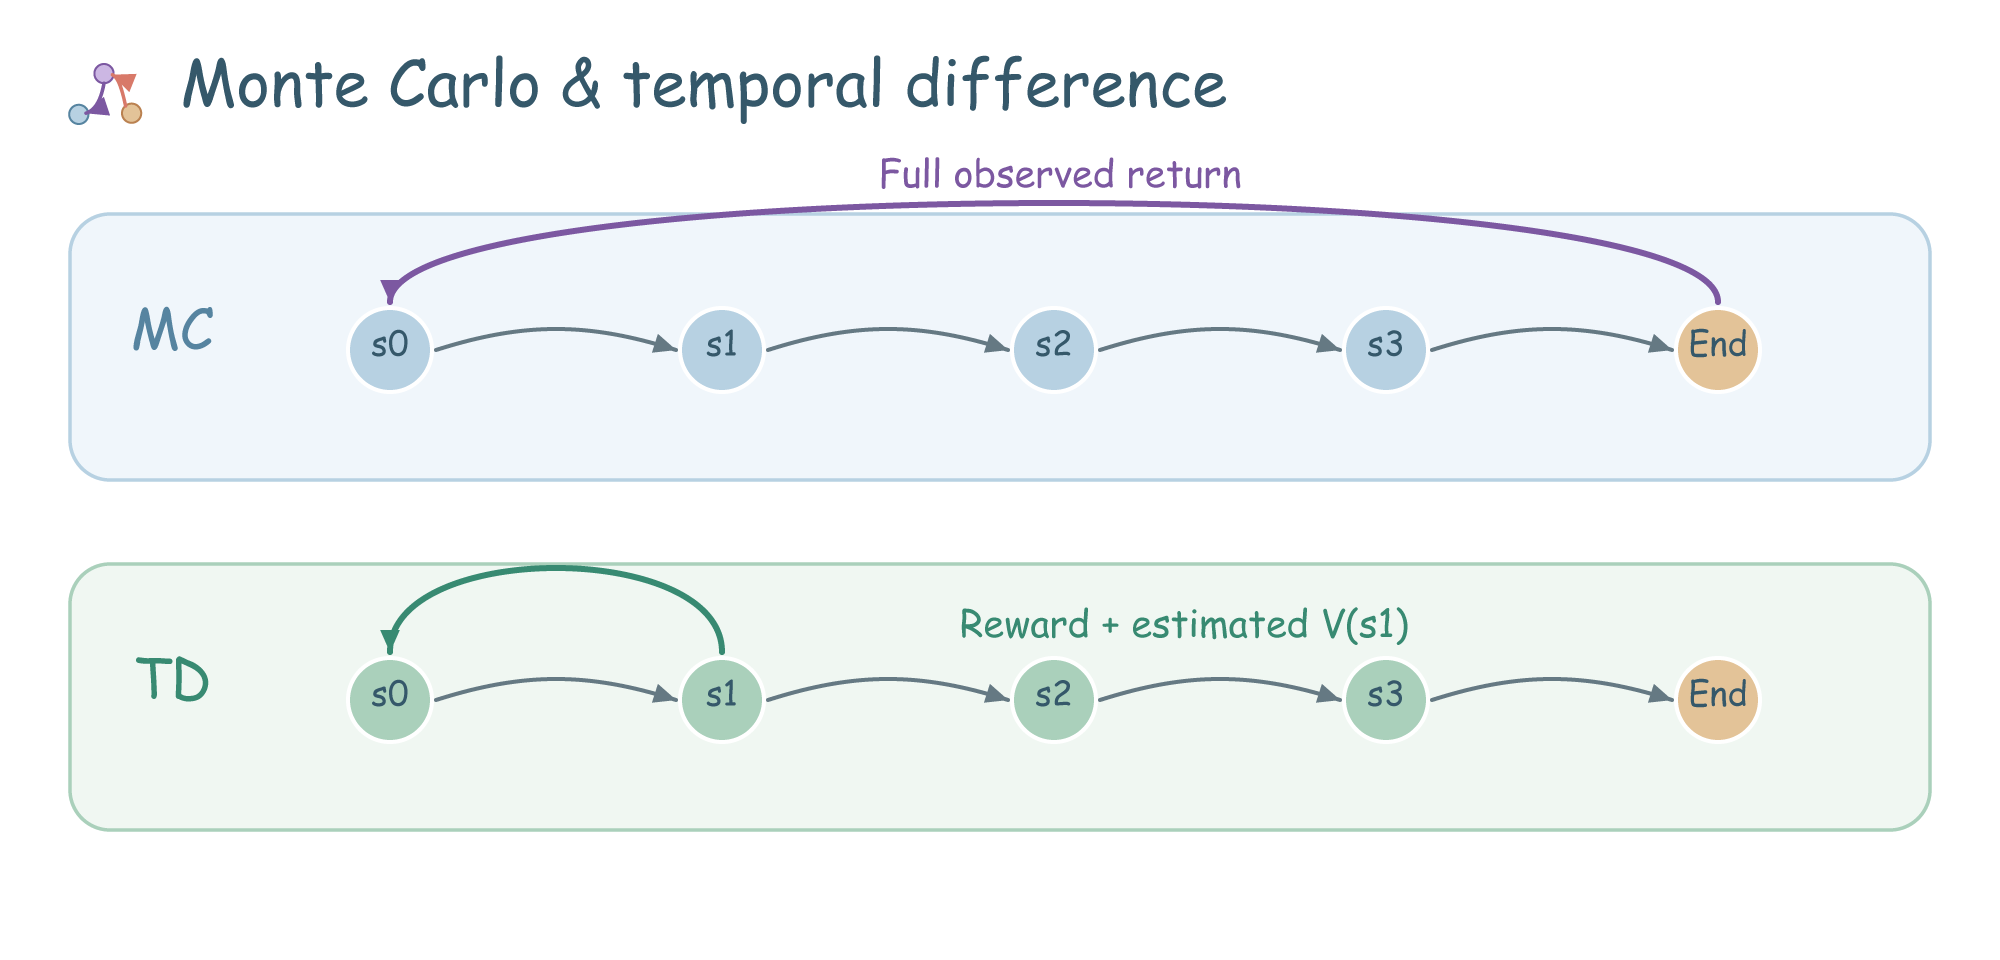
蒙特卡洛(Monte Carlo,MC)用完整回合的实际回报估计价值;时序差分(Temporal Difference,TD)用当前奖励和后续价值估计更新价值。两者都能从实际轨迹学习,不要求预先知道转移概率。
一轮任务结束后,计算某状态之后真正得到的回报 ,用它更新该状态的价值。多次访问的回报平均值,近似这个策略的期望回报。
一次迷宫路径很长,MC 就要等到结束;不同路径的回报也可能相差很大。它的目标使用实际奖励,不依赖后续状态的价值估计。
每走一步,用 作为目标,不必等到整轮结束:
是学习率,方括号是 TD 误差。若旧价值为 2,奖励为 −1,下一状态价值为 5,、,新价值为 。
TD 用已有估计帮助更新其他估计,称为自举。这样能及时学习,但目标也会继承当前估计的误差。
真正终止后没有未来奖励,后续价值取 0。仅因运行时间上限截断的轨迹,不一定代表任务终止,处理时要区分这两种情况。
两种动作价值学习方法
两者都学习动作价值 。Q-learning 的更新目标使用下一状态的最大动作价值;SARSA(State–Action–Reward–State–Action)使用下一步实际选出的动作价值。
更新形式都是:旧值加上学习率乘以“目标减旧值”,区别在目标。
| 算法 | 更新目标 | 学习的行为 |
|---|---|---|
| Q-learning | 下一步按当前估计选择最好动作 | |
| SARSA | 下一步执行实际选出的动作 |
SARSA 的名字来自五项记录:当前状态、动作、奖励、下一状态、下一动作。它学习采集数据的当前策略,属于 on-policy。Q-learning 的目标可以与实际探索动作不同,属于 off-policy。
常见探索方法是 -greedy:以 的概率随机选动作,其余时候选择当前价值最大的动作。只选已有最佳动作,可能永远发现不了更好的路径。
例如沿悬崖走能抄近路,但随机探索可能掉下去。SARSA 的更新会纳入实际探索策略带来的风险;Q-learning 的目标假设后续选最大价值动作,两者可能学到不同路线。
一个 Q-learning 更新
假设 ,奖励为 1,下一状态最大动作价值为 4,、。目标为 ,更新后为 。若这一步已经到达终止状态,目标只有奖励 1。
策略梯度
策略梯度直接计算期望回报对策略参数的梯度,并据此更新策略。
例如一个网络读入状态,输出向左、向右的概率。执行动作并收集回报后,增加高回报动作出现的概率,降低表现较差动作的概率。
REINFORCE 用完整回合的采样回报估计策略梯度,其名称来自 REward Increment = Nonnegative Factor × Offset Reinforcement × Characteristic Eligibility。以下取有限回合、折扣因子 ,一次更新可写为:
是策略参数, 是对这些参数的梯度。对数概率的梯度指出如何增加本次动作的概率, 决定更新的权重。它需要对许多采样结果求平均,单次成功未必代表动作可靠。
通常用 代替 ,其中 是不依赖本次动作的基线,例如状态价值。这样比较的是“比这个位置平常的结果好多少”,可降低梯度估计的波动。连续动作也可通过参数化概率分布生成,不必枚举每个可能值。
Actor–Critic
Actor–Critic 结合策略学习与价值学习:Actor 根据状态给出动作分布,Critic 估计状态或动作价值。Critic 的反馈帮助 Actor 判断本次选择比预期好多少。
一种常见实现使用 TD 误差 近似优势:Critic 调整自己的价值预测,Actor 用 给本次动作的对数概率梯度加权。正误差提高该动作的概率,负误差降低它的概率。
Critic 让策略能更频繁地更新,但它的估计错误也会影响 Actor。训练时同时观察回报、价值损失与多次独立运行的波动;仅看策略网络的损失下降,无法判断任务表现是否变好。