这些方法处理不同限制:标签少、任务变化、标注成本高,或预测结果需要解释。选用哪一种,取决于问题和数据。
集成学习
集成学习(Ensemble Learning)汇总多个模型的预测,利用不同模型之间的差异改善结果。
模型的错误不完全相同时,平均或投票有机会抵消部分错误;把相同模型复制十份没有这种作用。
自助聚合(Bootstrap Aggregating,Bagging)用不同抽样数据训练模型,再汇总结果,随机森林 属于这一类。提升法(Boosting)逐轮添加模型,让新模型补充已有组合的不足,梯度提升按损失的负梯度拟合修正量。堆叠法(Stacking)把各模型的预测作为新特征,另训练一个模型学习组合方式。
Stacking 的组合器应使用折外预测训练:每个样本的预测来自没训练过它的模型。若直接用基模型的训练集预测,组合器容易学到过分乐观的结果。
半监督与自监督学习
半监督学习(Semi-Supervised Learning)同时使用有标签和无标签数据。自监督学习(Self-Supervised Learning)从数据本身构造训练目标,用于学习表示。
例如只有 100 张猫狗照片已标注,另外 1 万张没有标签。
伪标签方法用已有模型预测无标签样本,把高置信度结果加入训练;标签传播沿样本相似关系传递标签。它们依赖数据结构与类别确实有关。如果模型自信地判错,伪标签可能反复放大错误。
例如遮住句子里的一个词,让模型根据上下文恢复;或对同一张照片做两种裁剪,让表示保持接近,并与其他照片的表示区分。
这些任务能学习可复用的表示,再用于分类等下游任务。裁剪若丢掉了主体,或增强改变了语义,训练目标就可能不合适。
两者可以结合:大量无标签图片做自监督预训练,再用少量标签训练分类器。自监督仍然有明确的损失函数,只是训练目标不依赖逐条人工标注。
迁移学习与元学习
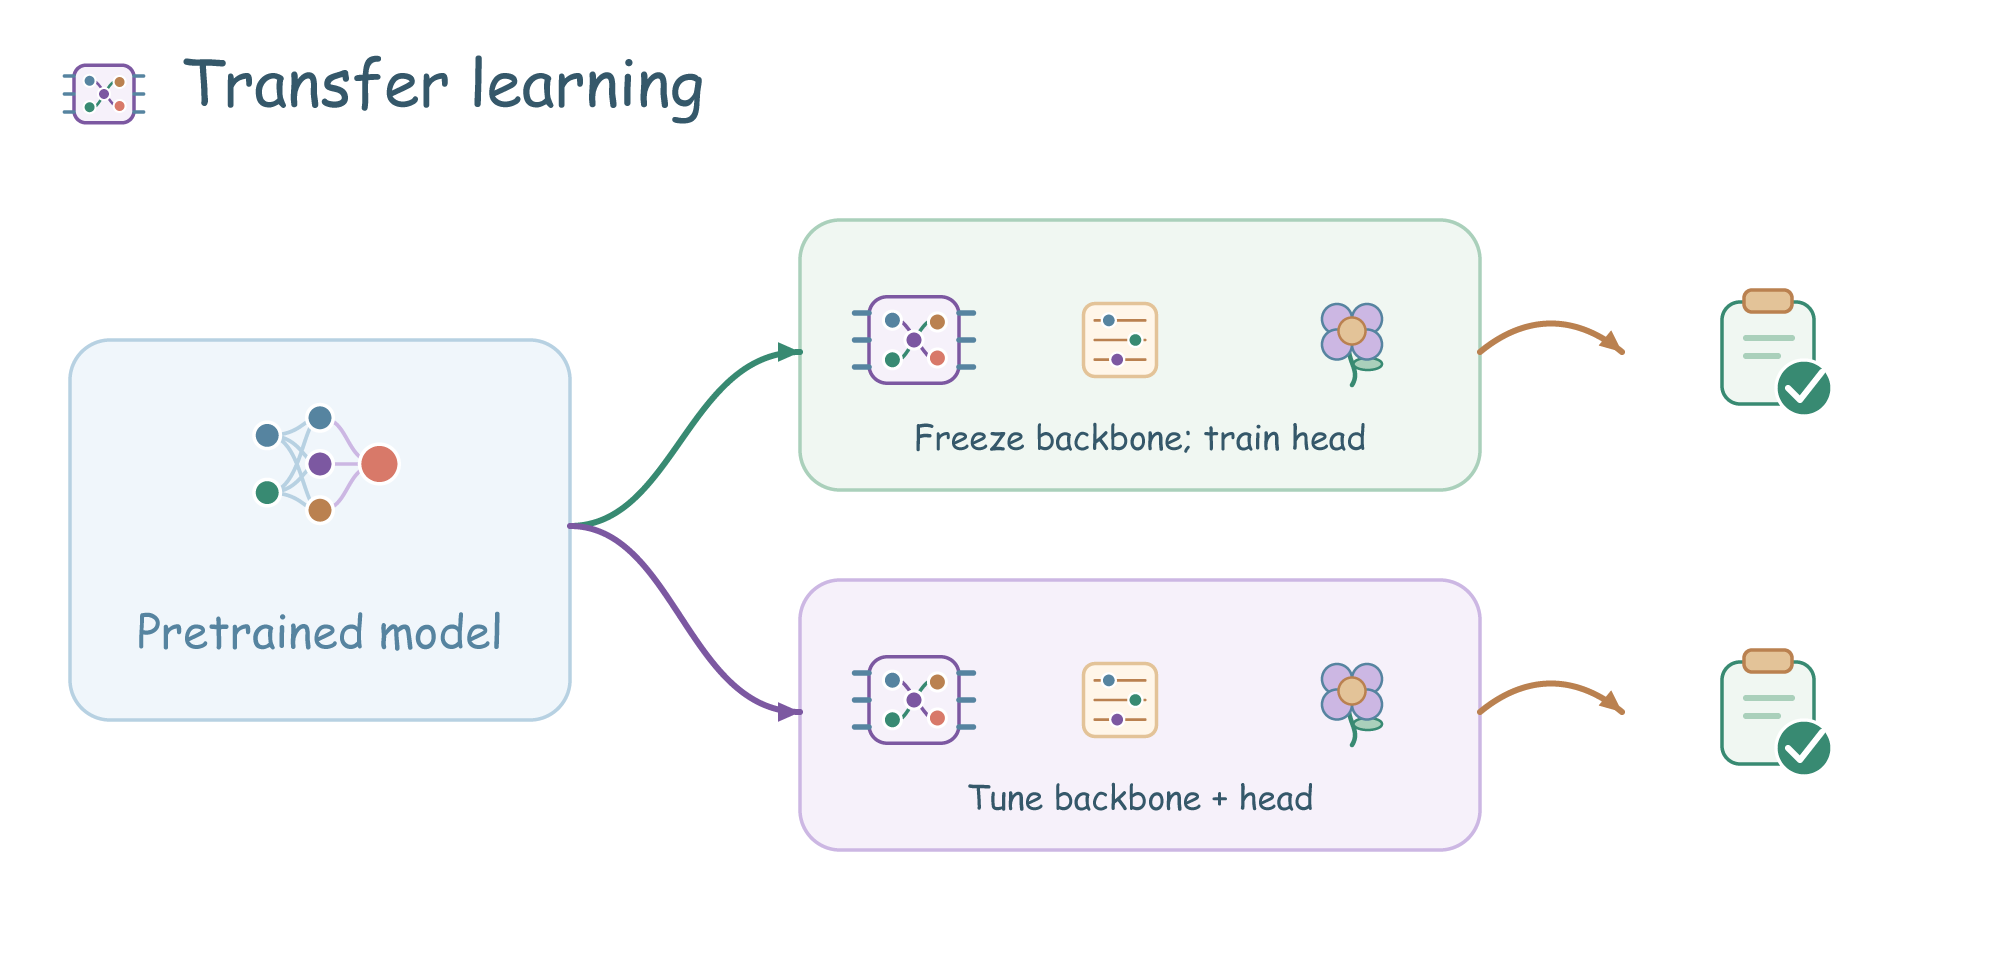
迁移学习(Transfer Learning)把已有任务学到的参数或表示用于新任务。元学习(Meta-Learning)利用多个任务学习适应新任务的方法。
例如用大规模图片训练好的网络识别花卉,可以固定特征提取层,仅训练新的分类层;也可以用较小学习率微调部分或全部参数。来源任务和目标任务差异过大时,迁移也可能降低表现。
例如元学习中的每个任务识别不同的几种动物,训练时反复模拟“只给几张标注图片,识别这一组新类别”。以模型无关元学习(Model-Agnostic Meta-Learning,MAML)为例,每轮从一组初始参数出发,在某个任务的少量样本上更新,再根据该任务另一部分样本的表现改进初始参数。最终目标是让新任务只需少量更新就能适应。
这里的划分单位还包括“任务”。若新任务的类别或对象已在元训练中出现,可能夸大对未知任务的适应能力。
因果学习
因果学习(Causal Learning)研究变量之间的影响关系,以及干预某个变量会怎样改变结果。干预指主动改变某因素,例如随机安排是否参加辅导课。
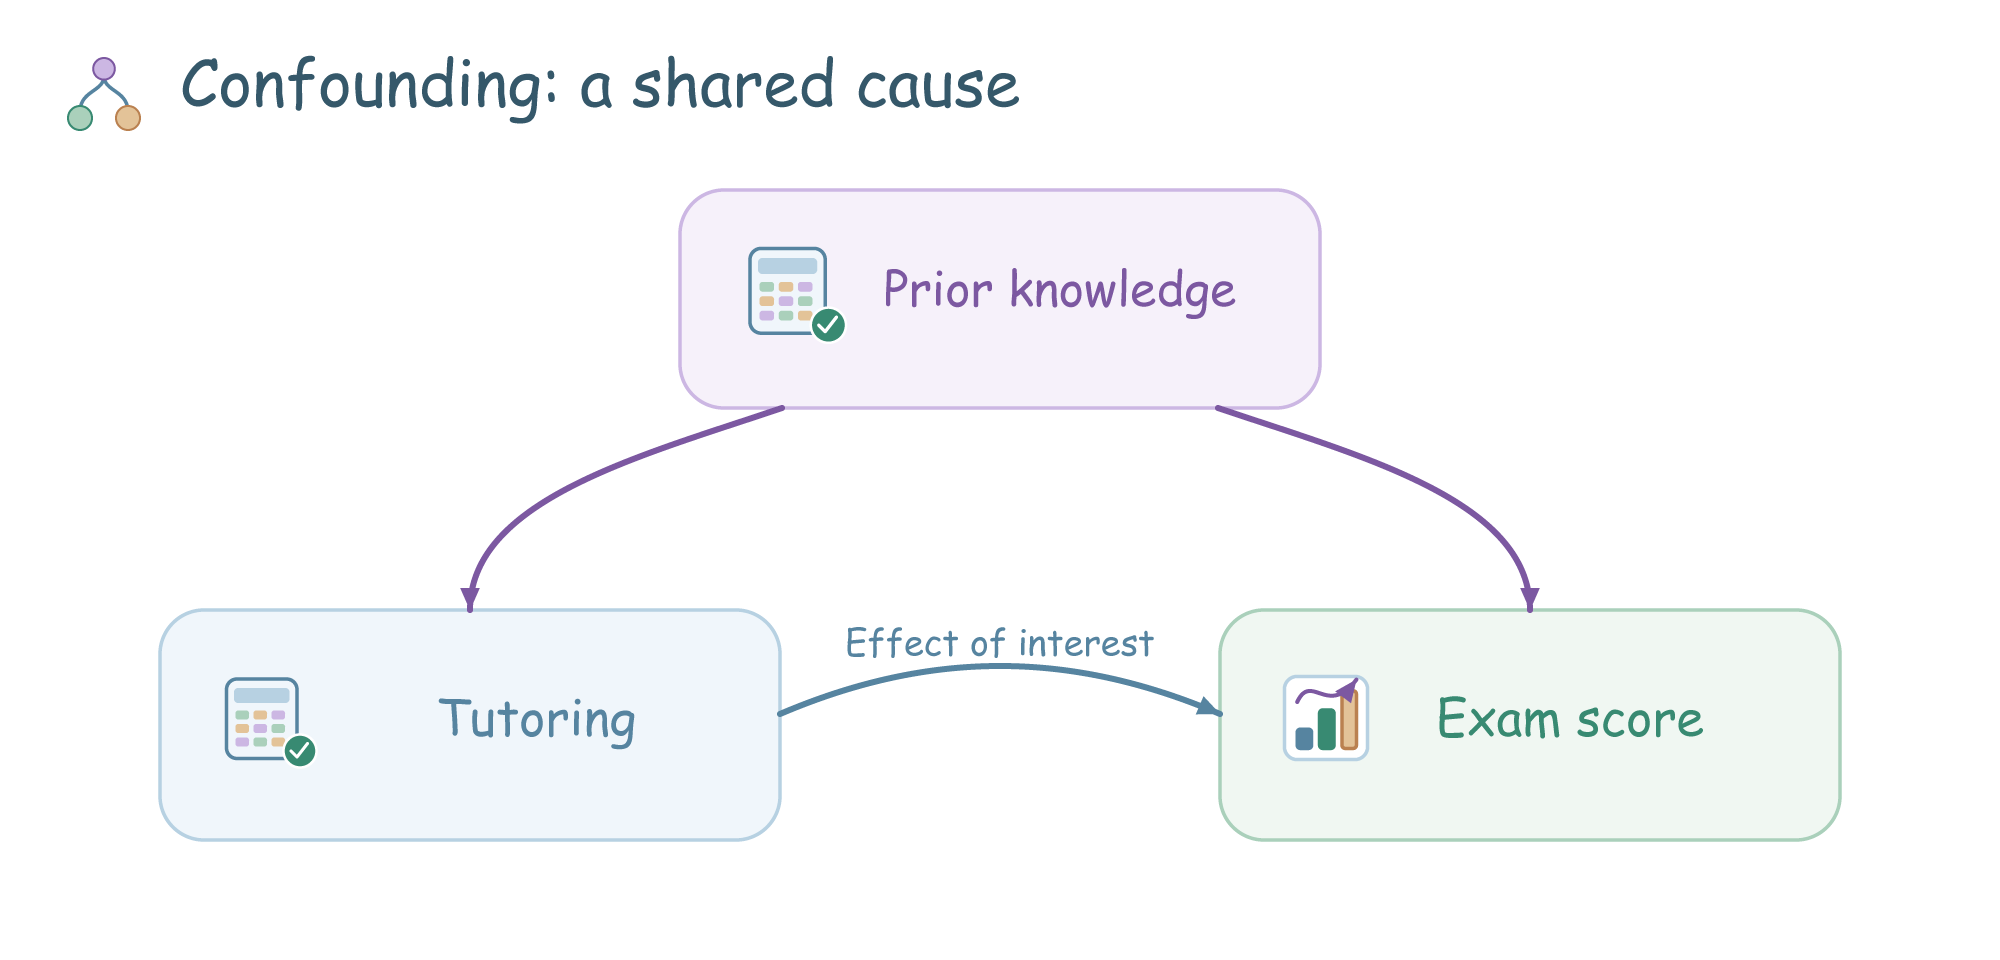
预测关心“知道这些信息后,结果可能是什么”;因果问题关心“主动改变某个因素,结果会改变多少”。参加辅导课的学生成绩更高,可能同时受到原有基础、学习投入等因素影响,不能直接把分差当作辅导效果。
因果图用箭头表达假设中的影响方向。原有基础既影响是否报名,也影响成绩,它就是可能的混杂因素。将学生随机分到辅导组和对照组,能在统计意义上削弱这种混杂;观察数据分析则需要说明哪些混杂已测量、怎样调整,以及相关假设为何合理。
隐藏混杂、样本选择和错误的图假设都会影响结论。预测准确率高,不能单独证明某个因素具有因果作用。
主动学习
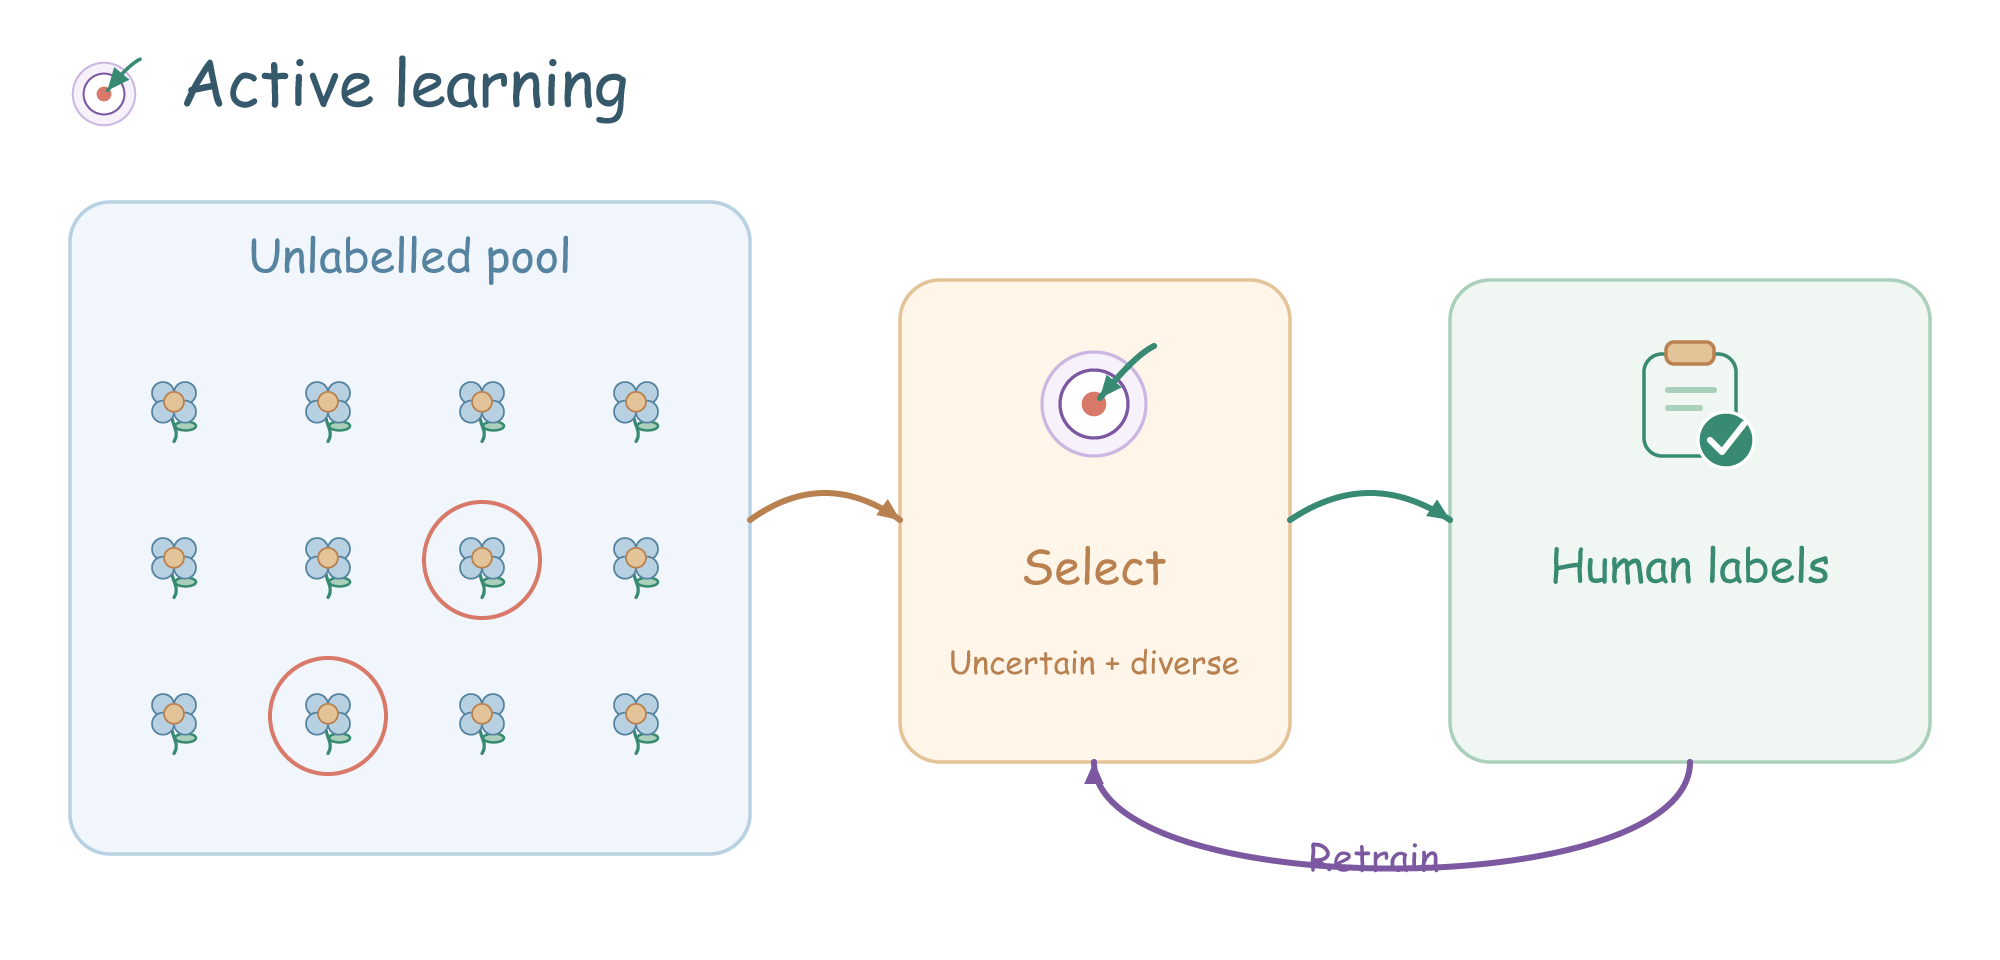
主动学习(Active Learning)由模型选择交给人标注的样本,目标是在同样的标注预算下获得更好的模型。
例如猫狗分类器对一张图给出 0.51 和 0.49 的概率,这张图可能比预测为 0.99 和 0.01 的图更有标注价值。
最简单的策略选择最不确定的样本,再标注、训练、重新选择。实际还会兼顾多样性,避免一批样本几乎相同。只选不确定样本可能集中到模糊图片或异常数据,新增标签未必改善整体表现。
评估时比较“相同标注数量下的测试表现”,并加入随机抽样基线,才能判断选择策略是否节省了标注。
可解释性
可解释性(Interpretability)关注人能否理解模型如何使用输入形成预测。全局解释描述总体规律,局部解释描述某一次预测。
线性模型的系数能展示关联方向,但大小受特征单位和相关性影响,不能直接按绝对值排名。
置换重要性把验证集的一列随机打乱,观察成绩下降多少。下降越大,说明模型在这份数据上越依赖该列。若两个特征高度相关,一个被打乱后另一个还能代替它,各自的重要性可能都偏低。
SHAP(SHapley Additive exPlanations,夏普利加性解释)将预测相对某个背景基准的差异分摊到各特征。例如某次预测比基准高 10,各特征的贡献加起来也为 10;分摊依赖背景数据和处理相关特征的方式。解释反映模型的行为,不能直接视为现实中的因果关系。
公平性与隐私
机器学习公平性(Fairness)关注模型对不同群体的影响及差异是否合理;隐私(Privacy)关注训练和使用模型时,个人数据是否受到保护。
整体准确率可能掩盖不同群体的错误差异。例如两个群体总体都预测对 90%,其中一个群体却更容易被错误拒绝。因此需要按群体检查样本量、误报率、漏报率,以及数据和标签如何形成。
以是否通过申请为例,正向预测就是“通过”,真实正例指按评价标准本应通过的申请。人口统计均等比较不同群体获得正向预测的比例;机会均等比较真实正例被识别出来的比例。它们衡量的问题不同,未必能同时满足。删除群体字段也不保证公平,其他特征可能携带相关信息。
隐私问题包括训练数据被记忆,以及攻击者判断某个人是否出现在训练集中。差分隐私(Differential Privacy)限制加入或移除一个人的数据对算法输出分布的影响;训练中常限制每个样本的梯度大小,再向汇总梯度加噪声,减少单个样本的影响。隐私预算控制个体数据变化对输出分布允许造成多大影响,要求越严格,通常越难保持原有精度。联邦学习(Federated Learning)让数据留在本地,但传输的模型更新仍可能泄露信息,需要额外保护。
大模型与基础模型
基础模型(Foundation Model)在广泛数据上预训练,再适配多种下游任务。大语言模型(Large Language Model,LLM)是其中面向语言的一类。
文本通常被切成词元(token),可能是字、子词或其他片段。自回归语言模型根据已有词元预测下一个词元,重复这一过程生成文本。预训练学习广泛模式;监督微调用输入与目标输出示例调整行为;偏好训练进一步利用回答之间的偏好信号。
上下文学习把说明和示例放进输入,推理时通常不更新权重。检索增强生成(Retrieval-Augmented Generation,RAG)把检索到的材料加入上下文,效果受检索质量和模型使用材料的能力影响。参数高效微调只训练少量新增或选定参数,减少适配开销。
模型生成的是按所学分布得到的内容,流畅回答仍可能包含错误。评价具体应用要使用独立任务样本,检查正确率、来源支持、耗时和成本;公开测试题若进入训练数据,也会夸大测得能力。
自动机器学习
自动机器学习(Automated Machine Learning,AutoML)在给定预算内,自动搜索预处理、模型和超参数组合。
例如比较缺失值填充方式、线性模型与树模型、不同正则化强度,再依据交叉验证成绩选择候选方案。有些系统还组合多个模型。
随机搜索从指定范围抽取配置;贝叶斯优化根据已尝试配置的成绩,选择更有希望或更值得探索的下一组参数。搜索空间、指标和时间预算都由人设定。
自动搜索不能修复错误标签或数据泄漏。尝试越多,越可能碰巧适配验证集;最终仍需保留独立测试集,嵌套交叉验证则把搜索放在内层划分,用外层留出的数据评价整套选择过程。