模型效果既取决于算法,也取决于输入数据和实验方式。同一个分类器,换一种数据划分,得到的分数可能差很多。
特征工程
特征工程(Feature Engineering)把原始记录转换成模型能使用的输入,并选择适合任务的表示方式。
日期可以拆成月份、星期;订单可以按用户汇总成最近 30 天的次数;文字可以转换成词频或嵌入。每个特征都应在实际预测的那个时刻可获得。
例如预测用户下个月是否流失,可以使用本月访问次数,不能使用下个月的退款记录。后一种输入提前泄露了未来。
缺失值可用训练集的中位数填补;跨度很大的正数可考虑对数变换。标准化使不同列的尺度接近。异常值可能是录入错误,也可能是有意义的少数情况,需要结合原始记录判断。
城市名没有天然大小顺序。独热编码为各类别建立 0/1 列,避免把城市编号误当成数值距离。类别过多会产生稀疏高维输入,可以合并低频类别或学习嵌入。
同一个人的多条记录通常相关。若任务是预测新用户,训练与验证应按用户分开;若预测未来,就按时间划分。滚动均值只能使用预测时刻之前的数据。
数据管道
数据管道(Pipeline)把填补、编码、缩放和模型连接为一个处理流程,统一管理训练与预测所用的转换。
fit 从训练数据学习所需参数;transform 沿用这些参数转换数据;predict 输出预测。
ColumnTransformer 对不同列执行不同处理。例如年龄列填补后标准化,城市列进行独热编码。Pipeline 再把这些转换接到分类器前面。交叉验证时,每一折都会独立拟合整条管道,验证数据不会参与计算均值或选择特征。
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression

model = Pipeline([
    ("fill", SimpleImputer(strategy="median")),
    ("scale", StandardScaler()),
    ("classifier", LogisticRegression(max_iter=1000)),
])
# X_train 为数值特征表,y_train 为类别标签
model.fit(X_train, y_train)
prediction = model.predict(X_test)
模型文件需要连同预处理参数一起保存。部署时重新计算均值、改变类别编码顺序,都会改变输入的含义。
超参数搜索
参数(Parameter)由训练学习,例如回归系数;超参数(Hyperparameter)由实验设置,例如树的最大深度。超参数搜索用验证表现比较不同设置,属于模型选择的一部分。
网格搜索枚举给定组合。3 个正则化强度配合 2 个设置,共 6 组;每组做 5 折验证,就需要训练 30 次。随机搜索在规定范围内抽样,在较大的搜索空间中通常更节省尝试次数。贝叶斯优化利用已有试验结果,决定下次尝试哪个配置。
from sklearn.model_selection import GridSearchCV, StratifiedKFold

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
search = GridSearchCV(
    model,
    {"classifier__C": [0.1, 1, 10]},
    scoring="f1_macro", cv=cv,
)
search.fit(X_train, y_train)
print(search.best_params_, search.best_score_)
这里沿用上一节的管道,classifier__C 指定分类器的超参数。CV 指交叉验证(Cross-Validation),f1_macro 表示分别计算各类 F1 后取平均值;F1 是精确率与召回率的调和平均数。best_score_ 是验证分数;最终测试分数要在未参与选择的测试集上另外计算。
反复看验证集,也会过拟合吗?
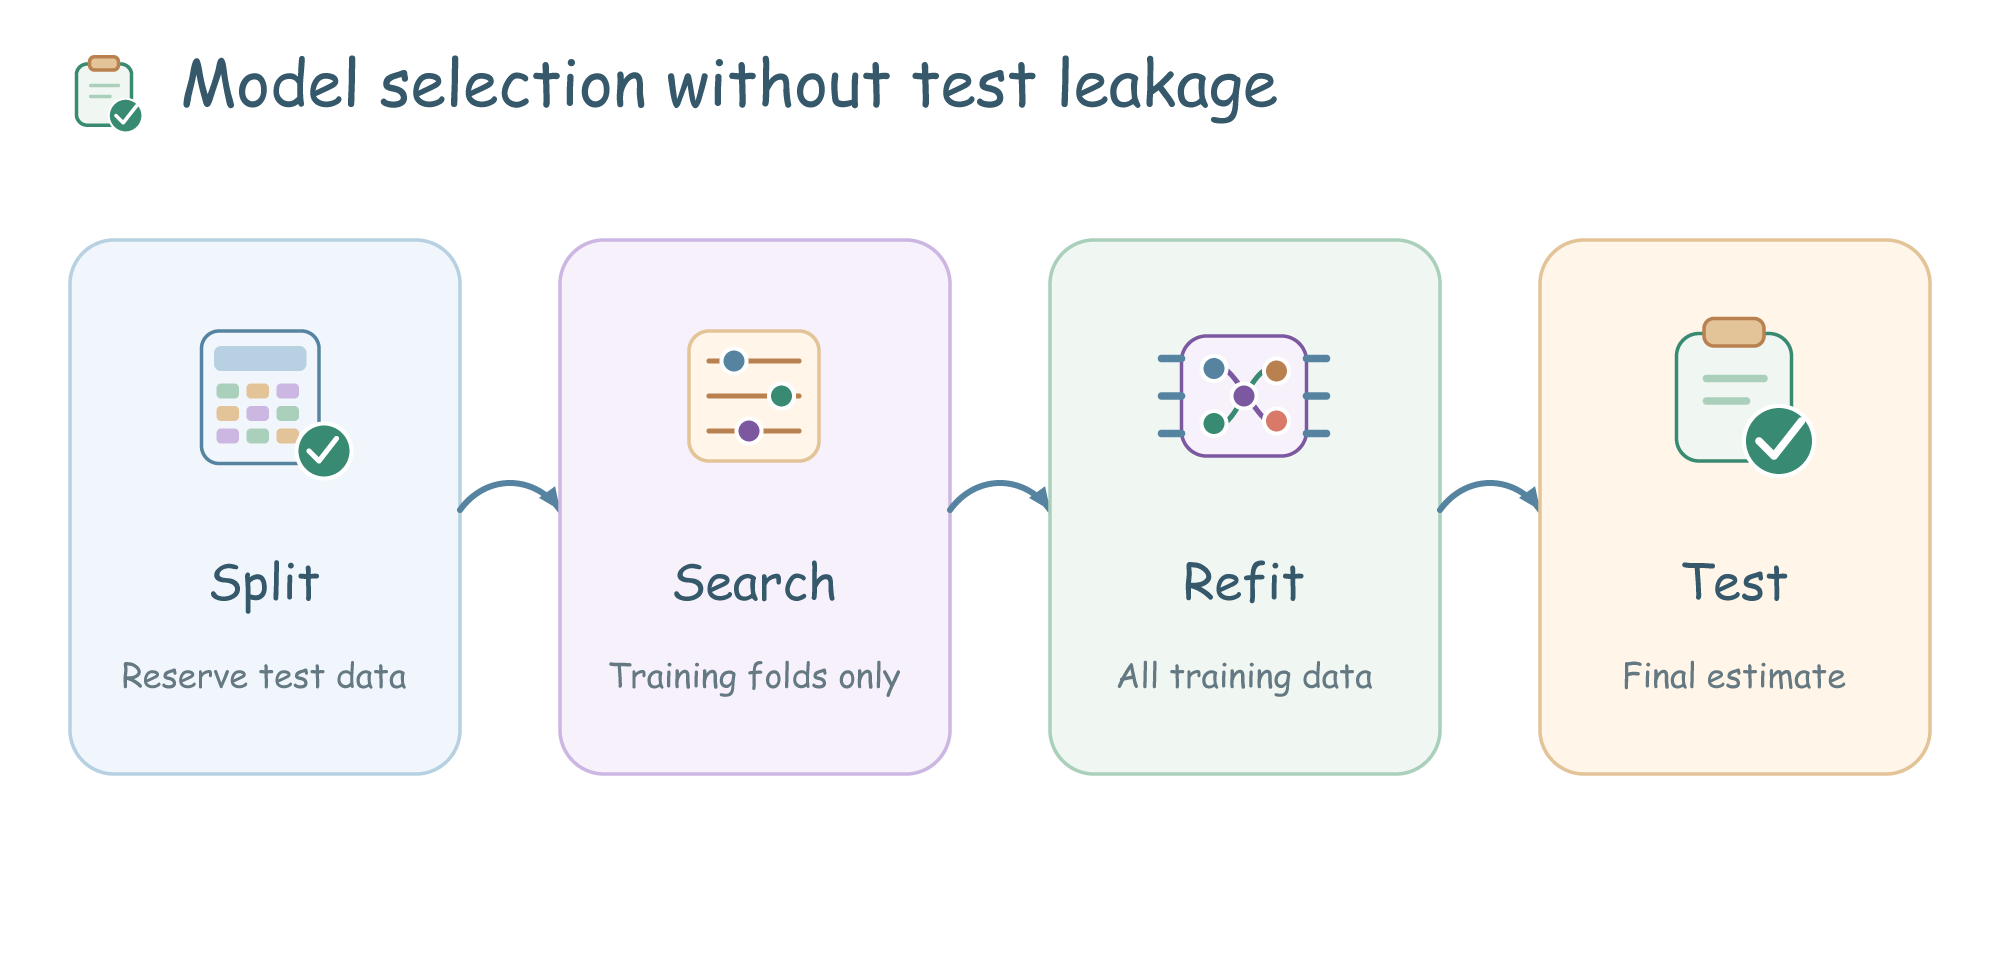
会。尝试很多设置后,胜出的模型可能碰巧适合这个验证集。独立测试集用于最终评估;嵌套交叉验证则用内层选参数、外层评估整个选择过程。两者都不能在看到评估结果后继续反复挑选,再把原分数当成独立证据。
三种框架怎样表达同一个任务
机器学习框架提供建模、训练和预测所需的软件组件。scikit-learn、PyTorch 和 TensorFlow 都能完成分类任务,但组织计算的方式不同。
scikit-learn 把常见算法封装成 fit/predict。PyTorch 允许显式编写前向计算、反向传播和更新循环。TensorFlow 的 Keras 接口用 compile/fit 组织训练。它们都需要定义输入、模型、损失和评价方式。
下面三个片段都使用多层感知机(Multilayer Perceptron,MLP),接收 64 维数字图像输入,输出 10 类预测。ReLU 是修正线性单元(Rectified Linear Unit),把负值置零;Adam 指自适应矩估计(Adaptive Moment Estimation),根据梯度的历史统计调整更新步长。X_train 已转换为浮点数组,y_train 是 0 到 9 的整数标签。完整运行文件见数字识别实验。
from sklearn.neural_network import MLPClassifier
model = MLPClassifier(hidden_layer_sizes=(32,), max_iter=100,
                      random_state=42)
model.fit(X_train, y_train)
prediction = model.predict(X_test)
import torch
from torch import nn
model = nn.Sequential(nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 10))
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
x = torch.tensor(X_train, dtype=torch.float32)
y = torch.tensor(y_train, dtype=torch.long)
optimizer.zero_grad()
loss = nn.CrossEntropyLoss()(model(x), y)
loss.backward()
optimizer.step()  # 一次更新;完整训练重复处理多个批次
import tensorflow as tf
model = tf.keras.Sequential([
    tf.keras.Input(shape=(64,)),
    tf.keras.layers.Dense(32, activation="relu"),
    tf.keras.layers.Dense(10),
])
model.compile(optimizer="adam", metrics=["accuracy"],
    loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True))
model.fit(X_train, y_train, epochs=20, batch_size=64)
神经网络输出的是未归一化得分 logits。上面两个深度学习损失函数内部处理概率归一化,输入前不再手动应用 Softmax。不同框架的默认初始化和优化细节不同,分数差异不能直接归结为框架优劣。
Kaggle 与课程作业
Kaggle 是提供数据集、机器学习竞赛和练习的平台。课程作业则围绕指定概念或任务,通过计算、代码和实验检查理解。
Kaggle 练习通常提供数据、评分指标和提交格式。公开榜单只反映一部分评估数据;频繁根据榜单分数改模型,也会让选择偏向这部分数据。本地验证仍然需要独立设计。
课程作业适合检查一个具体知识点:手写一次梯度更新、实现 K 均值聚类(K-means,K 表示组数)的分配与更新、比较主成分分析(Principal Component Analysis,PCA)降维前后的分类效果。记录输入、预期行为和实际输出,才容易定位公式或代码中的问题。
实验记录
实验记录保存每次运行所用的数据、配置和结果,方便比较不同方案,也方便再次运行。
| 记录 | 例子 |
|---|---|
| 数据与划分 | 数据来源、样本数、划分代码、是否按人或时间隔离 |
| 训练配置 | 模型、超参数、随机种子、依赖版本、设备 |
| 结果 | 基线与模型使用相同的评价方式,记录多次运行的均值与波动 |
| 对照实验 | 固定其他条件,只改变待研究组件 |
随机种子控制数据打乱、参数初始化等随机过程。设备和软件版本也会影响运行结果,一并记下便于排查差异。