坤坤想让小车把样本送到实验台。房间里有货架和墙,绕路会浪费时间,碰壁还得重新找方向。他不想为每张地图手写一条路线,希望小车能从一次次尝试中学会怎么走。
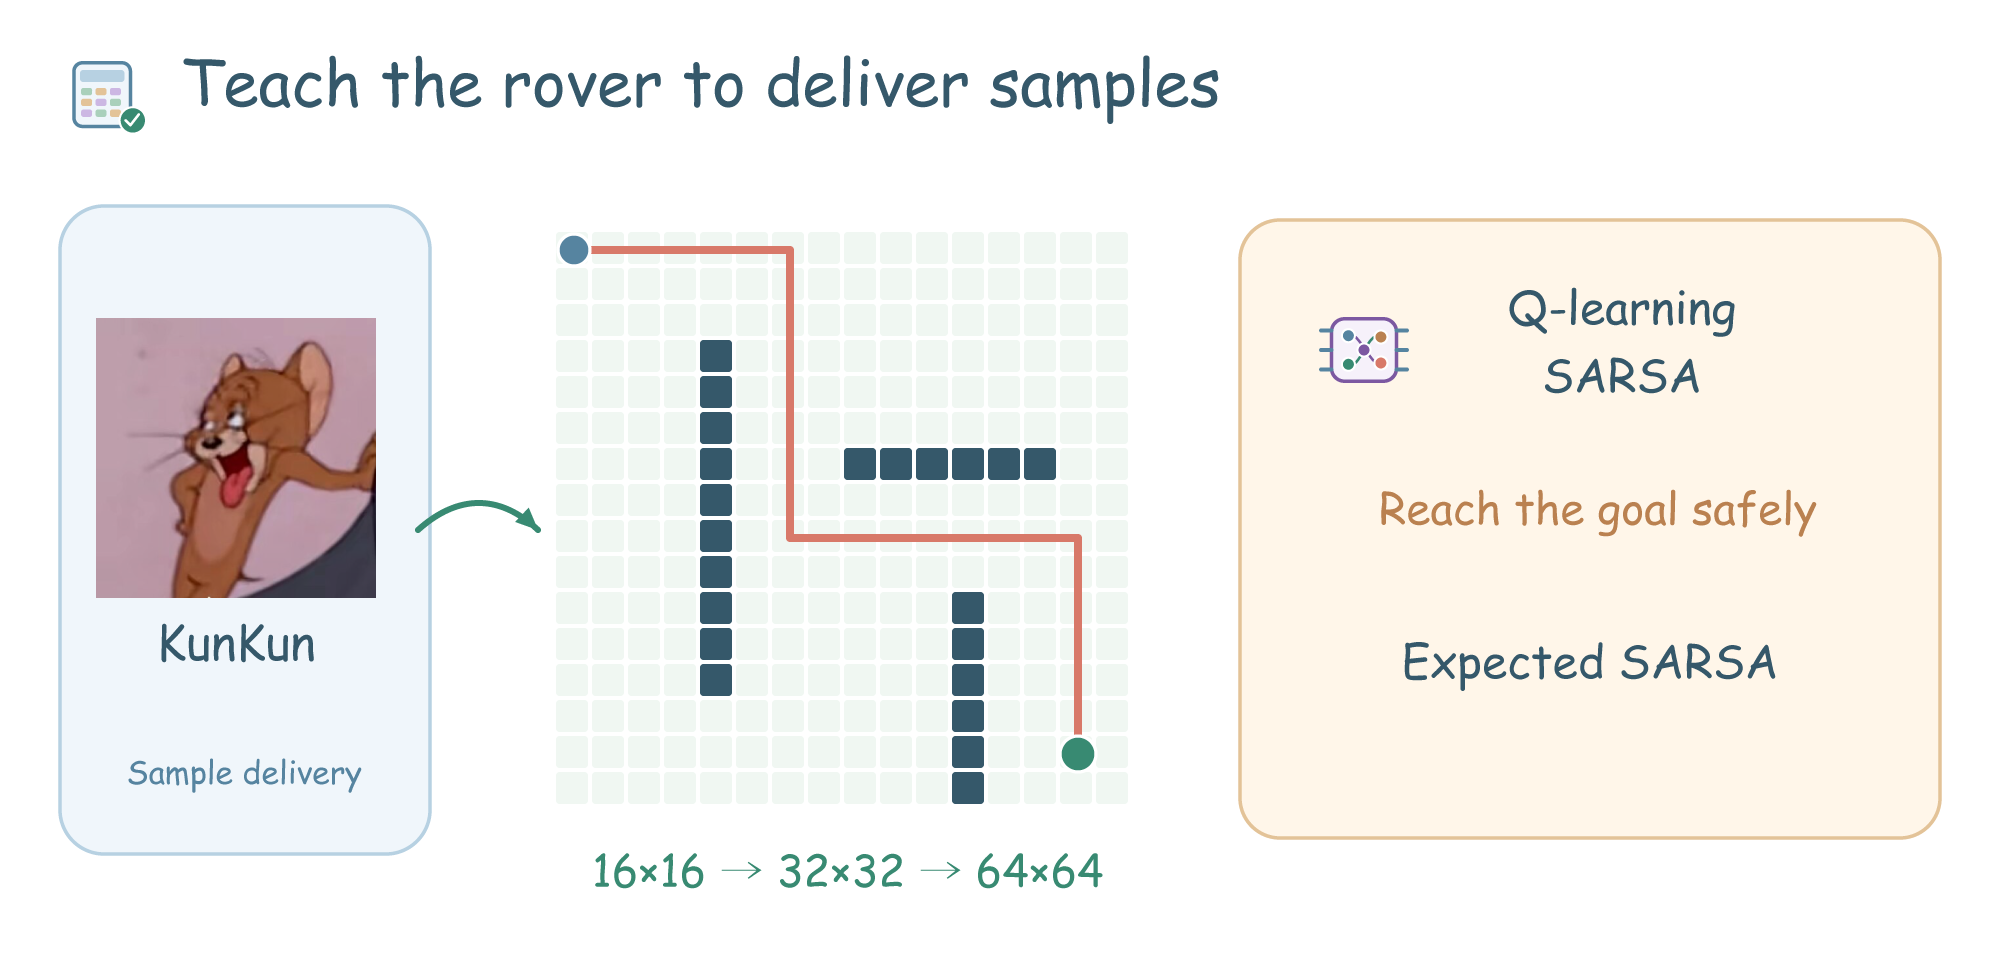
让小车在 16×16 到 64×64 的地图里学会避开障碍、抵达终点。比较 Q-learning、SARSA 和 Expected SARSA 的表现,再换地图、改奖励或探索程度,观察到达率和路线怎样变化。最终要回答:小车学到的路线,是否既可靠又少绕路?
相关知识
- 状态、动作、奖励与回报:把地图上的送样任务描述成小车可以学习的问题。
- 价值函数与贝尔曼方程:理解一个动作的价值为什么还要考虑后面的路。
- 时序差分学习:了解小车怎样走一步、更新一次经验。
- Q-learning、SARSA 与探索:比较“下一步最好动作”和“实际探索动作”带来的更新差别;Expected SARSA 在此基础上对策略可能选择的动作取加权平均。
打开项目后选择「小车送样」。运行方法见包内 GETTING_STARTED.md,原理讲解和练习引导在实验页面里。