二项堆的定义和性质
在二叉堆(Binary Heap)的基础上,我们可以实现在可以在 时间内实现 个结点的插入建堆操作,而之前讨论的左式堆和斜堆不可以
- 结构性质:
- 二项堆不是一棵树,而是由许多树组成的森林,其中每一棵树称为二项树
- 一个二项堆中的每棵树具有不同的高度,每一种高度的二项树最多只有一棵
- 高度为 0 的二项树是一棵单节点树;高度为 的二项树 通过将一棵二项树 附接到另一棵二项树 的根上而构成
- 序性质:每棵二项树都保持堆序性质(最小堆或者最大堆)
根据二项堆的性质,我们有以下结论:
二项树的节点数目: 的二项树具有 个节点,这可以由递推很容易证明
在深度为处的节点数恰好就是二项系数
对于 的情况显然正确,设直到 结论都是正确的,则对于 ,第一层和 最后一层只有一个结点是可以直接得到的,在其它层中,回忆二项堆的定义是由两个 接起来的,因此在新树的深度为的地方,由两部分组成:
- 一部分是在 的深度为 的地方,有 个结点
- 另一部分是在 的深度为 的地方,有 个结点
故我们只要证
这由二项数的性质很容易证明
可以将二项堆与二进制表示联系起来
二项堆的操作
Findmin
直接遍历所有树,注意到对于一个有个结点的二项堆,最多有棵树,因此时间复杂度为
也可以通过专门记录最小的节点来实现的时间复杂度,当然在DeleteMin的时候需要重新找到最小的节点并更新
Insert & merge
插入是特殊的合并操作,我们可以将一个新的节点看作是一个只有一个节点的二项堆,然后将其与原来的二项堆合并即可;
合并操作的过程十分类似二进制数的加法,例如一个二项堆有,其二进制表示为,另一个二项堆有,其二进制表示为,我们可以将其看作是二进制数相加,然后将进位的部分合并得到新的二进制数,则新的二项堆为,我们需要保证堆的存储顺序是按高度从小到大来排列,这样时间复杂度就是
对于从空开始插入建堆的时间复杂度我们需要做特殊的分析。因为我们是要平均时间的最坏情况,事实上也就是摊还代价。
聚合法需要每一步的操作复杂度,实际上我们随便模拟几步再结合之前讨论的合并和二进制加法之间的关系就可以发现,插入的整个操作与二进制数加1有完全的对应关系:若是遇到了某一位是,则用常数操作完成简单的合并即可,如果遇到,那么当前所有的二项树合起来就是最后的结果。基于这一观察我们知道,因为对应将0置1,对应1置0,这两种情况都对应于堆的常数时间操作,因此从空树连续插入的顶点的时间复杂度与的过程中数据二进制表示中0和1比特翻转的次数总和。于是算法复杂度就很好计算了,因为我们知道对应于 个二进制位,事实上最低位每次加1都会反转比特,次低位每两次运算反转比特,倒数第三位每4次运算反转比特......以此类推,次操作的整体时间复杂度与
有了这个结论,我们就可以知道,从空树开始插入个结点的时间复杂度是的,故单步插入的摊还代价是的
对于复杂的操作,对应着很多次的复位操作(1变0)和一次置位(0变1)操作,所以将势函数定义为 二项堆中二项树的个数,这样在一次操作之后势函数的会下降很多;
假设一次操作 有 次复位;那么
故单步操作复杂度为
二项堆的代码实现
因为每个结点的孩子数量可能不只有2个,因此我们使用LeftChild和NextSibling的组合实现。直观上来看用LeftChild和NextSibling是让二项树翻转了:原先是根的子树从左到右高度依次增大,现在依次减小了。并且为了方便索引每棵二项树,我们用一个数组存储每棵二项树的根,其中数组的索引就对应二项树的高度
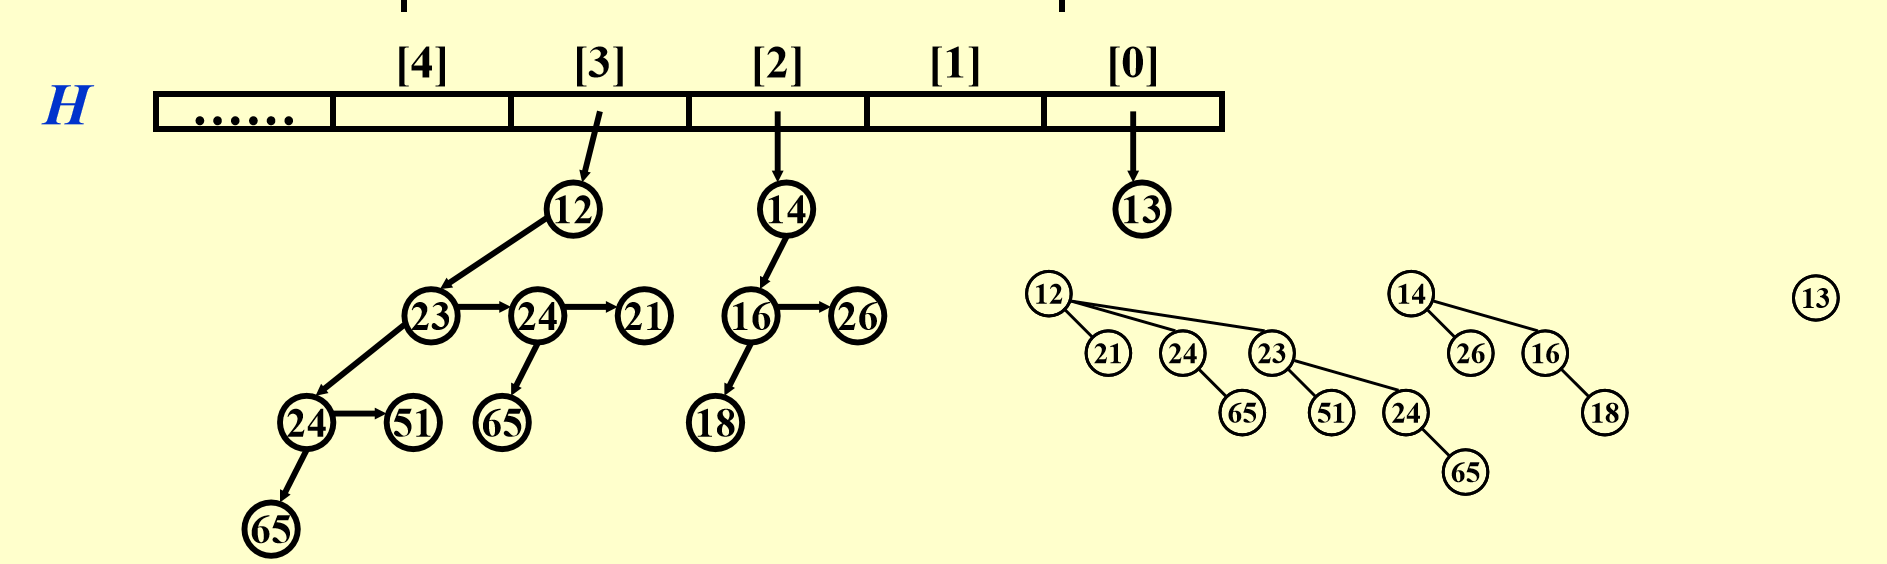
相当于让最大的孩子管着其它的兄弟
结构定义
typedef struct BinNode *Position;//指针
typedef struct Collection *BinQueue;//二项队列
typedef struct BinNode *BinTree;  //二项树

struct BinNode
{
	ElementType	    Element;
	Position	    LeftChild;
	Position 	    NextSibling;
} ;

struct Collection
{
	int	    	CurrentSize;  /* total number of nodes */
	BinTree	TheTrees[ MaxTrees ];//存储每棵二项树的根
} ;
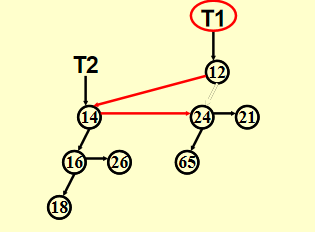
合并大小相同的树(复杂度)
BinTree
CombineTrees( BinTree T1, BinTree T2 )
{  /* merge equal-sized T1 and T2 */
	if ( T1->Element > T2->Element )
		/* attach the larger one to the smaller one */
		return CombineTrees( T2, T1 );
	/* insert T2 to the front of the children list of T1 */
	T2->NextSibling = T1->LeftChild;
	T1->LeftChild = T2;
	return T1;
}
Merge
BinQueue  Merge( BinQueue H1, BinQueue H2 )
{	BinTree T1, T2, Carry = NULL;
	int i, j;
	if ( H1->CurrentSize + H2-> CurrentSize > Capacity )  ErrorMessage();
	H1->CurrentSize += H2-> CurrentSize;
	for ( i=0, j=1; j<= H1->CurrentSize; i++, j*=2 ) {
	    T1 = H1->TheTrees[i]; T2 = H2->TheTrees[i]; /*current trees */
	    switch( 4*!!Carry + 2*!!T2 + !!T1 ) {
		case 0: /* 000 */  break;
	 	case 1: /* 001 */  break;
		case 2: /* 010 */  H1->TheTrees[i] = T2; H2->TheTrees[i] = NULL; break;
		case 4: /* 100 */  H1->TheTrees[i] = Carry; Carry = NULL; break;
		case 3: /* 011 */  Carry = CombineTrees( T1, T2 );
			            H1->TheTrees[i] = H2->TheTrees[i] = NULL; break;
		case 5: /* 101 */  Carry = CombineTrees( T1, Carry );
			            H1->TheTrees[i] = NULL; break;
		case 6: /* 110 */  Carry = CombineTrees( T2, Carry );
			            H2->TheTrees[i] = NULL; break;
		case 7: /* 111 */  H1->TheTrees[i] = Carry;
			            Carry = CombineTrees( T1, T2 );
			            H2->TheTrees[i] = NULL; break;
	    } /* end switch */
	} /* end for-loop */
	return H1;
}
4*!!Carry + 2*!!T2 + !!T1的作用是将树转换为二进制表示,对于第一个非,如果是空,那么为1,如果非空,那么为0,再取非,就再取反,然后转换为3位的二进制数字000什么都不用做,此时三个位置都是0001什么都不用做,此时H1有树,H2没有东西需要合并上去的010此时将H2的树转移到H1011需要进位,Carry要变成两树之和,两树要清空100将Carry转移到H1101需要进位,当位置0,将Carry变得更大110与上一情况类似111这里的做法并不唯一,我们可以保留任意一棵树,将另外两树之和进位上去,不过这里采用的是保留Carry,进位T1+T2
Deletemin
ElementType  DeleteMin( BinQueue H )
{	BinQueue DeletedQueue;
	Position DeletedTree, OldRoot;
	ElementType MinItem = Infinity;  /* the minimum item to be returned */
	int i, j, MinTree; /* MinTree is the index of the tree with the minimum item */

	if ( IsEmpty( H ) )  {  PrintErrorMessage();  return –Infinity; }

	for ( i = 0; i < MaxTrees; i++) {  /* Step 1: find the minimum item */
	    if( H->TheTrees[i] && H->TheTrees[i]->Element < MinItem ) {
		MinItem = H->TheTrees[i]->Element;  MinTree = i;    } /* end if */
	} /* end for-i-loop */

	DeletedTree = H->TheTrees[ MinTree ];
	H->TheTrees[ MinTree ] = NULL;   /* Step 2: remove the MinTree from H => H’ */
	OldRoot = DeletedTree;   /* Step 3.1: remove the root */
	DeletedTree = DeletedTree->LeftChild;   free(OldRoot);
	DeletedQueue = Initialize();   /* Step 3.2: create H” */

	DeletedQueue->CurrentSize = ( 1<<MinTree ) – 1;  /* 2^{MinTree} – 1 */

    for ( j = MinTree – 1; j >= 0; j – – ) {
	    DeletedQueue->TheTrees[j] = DeletedTree;
	    DeletedTree = DeletedTree->NextSibling;
	    DeletedQueue->TheTrees[j]->NextSibling = NULL;
	} //将树拆开

    H->CurrentSize  – = DeletedQueue->CurrentSize + 1;//minus 2^{MinTree}
    H = Merge( H, DeletedQueue ); /* Step 4: merge H’ and H” */
	return MinItem;
}
Explanation
比较简单,就照抄了GPT了
函数原型和输入参数
ElementType DeleteMin(BinQueue H)
ElementType: 返回删除的最小元素的类型。BinQueue H: 要从中删除最小元素的二项队列。
变量初始化
BinQueue DeletedQueue;
Position DeletedTree, OldRoot;
ElementType MinItem = Infinity;
int i, j, MinTree;
DeletedQueue: 用于存储将要删除的树。DeletedTree: 指向当前处理的树。OldRoot: 保存被删除的根节点。MinItem: 初始设为正无穷,用于跟踪最小元素。MinTree: 存储最小元素所在树的索引。
检查队列是否为空
if (IsEmpty(H)) { PrintErrorMessage(); return -Infinity; }
- 检查二项队列是否为空。如果为空,则打印错误信息并返回负无穷。
找到最小元素
for (i = 0; i < MaxTrees; i++) {
    if (H->TheTrees[i] && H->TheTrees[i]->Element < MinItem) {
        MinItem = H->TheTrees[i]->Element;
        MinTree = i;
    }
}
- 遍历所有树,找到具有最小元素的树(即最小根节点)。
- 如果找到更小的元素,则更新
MinItem和MinTree。
删除最小元素的树
DeletedTree = H->TheTrees[MinTree];
H->TheTrees[MinTree] = NULL;
OldRoot = DeletedTree;
DeletedTree = DeletedTree->LeftChild;
free(OldRoot);
- 将最小树存储在
DeletedTree中,并在原队列中将其置为NULL。 - 保存根节点到
OldRoot,然后将DeletedTree指向其左子树。 - 释放
OldRoot所占的内存。
初始化新的队列
DeletedQueue = Initialize();
DeletedQueue->CurrentSize = (1 << MinTree) - 1;
- 初始化一个新的二项队列
DeletedQueue,用于存放从最小树中拆分出的树。 - 设置
DeletedQueue的当前大小为2^MinTree - 1,因为最小树的节点数是2^MinTree - 1。
拆分树并放入新队列
for (j = MinTree - 1; j >= 0; j--) {
    DeletedQueue->TheTrees[j] = DeletedTree;
    DeletedTree = DeletedTree->NextSibling;
    DeletedQueue->TheTrees[j]->NextSibling = NULL;
}
- 从
MinTree-1到0,将拆分出的树依次放入DeletedQueue中。 - 将每棵树的
NextSibling设为NULL,以正确断开链表。
更新原队列的大小并合并
H->CurrentSize -= DeletedQueue->CurrentSize + 1;
H = Merge(H, DeletedQueue);
- 从原队列
H的当前大小中减去DeletedQueue的大小以及1(因为删除了一个根)。 - 调用
Merge函数将H和DeletedQueue合并,更新原队列。
返回最小元素
return MinItem;
- 返回找到的最小元素。
堆性能的总结(单步摊还代价)
| Operation | Binary Heap | Leftist Heap | Skew Heap | Binomial Heap | Fibonacci Heap |
|---|---|---|---|---|---|
| Insert | |||||
| Merge | |||||
| DeleteMin | |||||
| Delete | |||||
| DecreaseKey |